

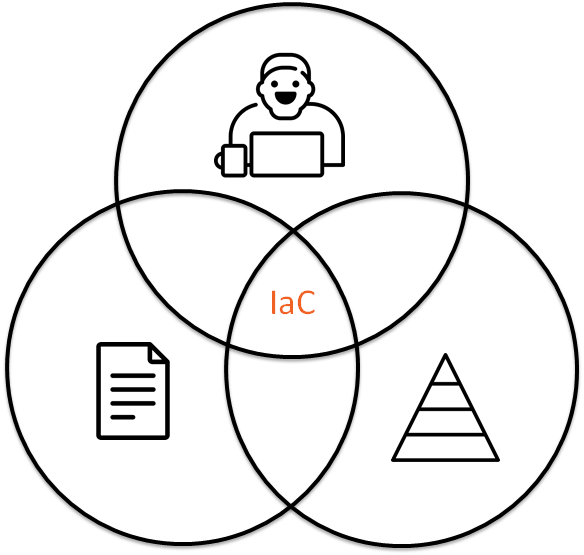
Lähenemine . See on arusaadav. Lõppude lõpuks, just nemad andsid võimaluse konfigureerida täielikult virtuaalne andmekeskus: füüsilisi servereid, riiuleid, võrgu komponente ei ole ning kogu infrastruktuuri saab kirjeldada skriptide ja konfiguratsioonifailide abil. (Infrastructure as Code) koosneb mitte ainult koodist, mis hoitakse hoidlapis, vaid ka inimestest ja protsessidest, mis seda koodi ümbritsevad. Kas saame kasutada tarkvaraarenduses kasutatavaid lähenemisi infrastruktuuri haldamiseks ja kirjeldamiseks? Oluline on hoida seda mõtet meeles, kui loete seda artiklit.
See on minu . Tundub, et .
Esitlused ja videod
- Dry run 2019-04-24
Infrastructure as bash history
Oletame, et asute uuele projekti, ja teile öeldakse: 'meil on Infrastructure as Code'. Tõelisuses selgub, Infrastructure as bash history või näiteks Documentation as bash history. See on täiesti reaalne olukord, näiteks kirjeldas sellist juhtumit Denis Lysenko oma ettekandes , ta rääkis, kuidas bash ajaloost saadi korralik infrastruktuur projektis.
Mõningase soovi korral võib öelda, et Infrastructure as bash history see on nagu kood:
- konfiguratsiooni korduvus: saate võtta bash ajaloo, täita sealt käske, tõenäoliselt saate töökeskkonna tulemuseks.
- versioonimine: teate, kes logis sisse ja mida tegi, kuid ei ole garanteeritud, et see viib teid töökeskkonna tulemusele.
- ajalugu: ajalugu, kes ja mida tegi. Ainult te ei saa seda kasutada, kui kaotate serveri.
Mis siis teha?
Infrastructure as Code
Isegi sellist kummalist juhtumit nagu Infrastructure as bash history on võimalik venitada Infrastructure as Code, kuid kui soovime teha midagi keerulisemat kui vana hea LAMPi server, jõuame sinna, et seda koodi tuleb mingil moel muuta, täiustada ja arendada. Edasi käsitleme paralleele Infrastructure as Code ja tarkvaraarenduse vahel.
D.R.Y.
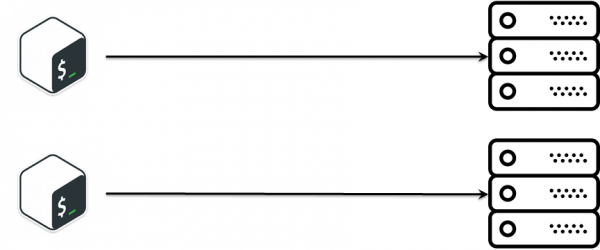
Süvendatud andmekandmete arendusprojekti korral oli alateema : väljastame uue väljaande — see tuleb rakendada edasisteks testimiseks. Ülesanne on äärmiselt lihtne:
- siia logige sisse ssh kaudu ja käivitage käsk.
- seal kopeerige fail.
- siin parandage konfi.
- seal käivitage teenus.
- …
- PROFIT!
Kirjeldatud loogika jaoks on bash täiesti piisav, eriti projekti varases staadiumis, kui see alles alustab. See , kuid aja jooksul tekivad soovid luua midagi sarnast, kuid veidi erinevat. Esimene mõte, mis pähe tuleb: copy-paste. Ja nüüd on meil juba kaks väga sarnast skripti, mis teevad peaaegu sama. Aja jooksul on skriptide arv kasvanud ja oleme silmitsi seisnud olukorraga, kus on teatud äriloogika installatsiooni rakendamiseks, mida tuleb erinevate skriptide vahel sünkroniseerida, mis on üsna keeruline.
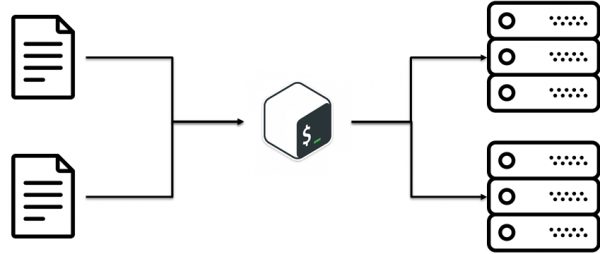
Selgub, et on olemas selline praktika nagu D.R.Y. (Ära Korda Iseennast). Idee on kasutada olemasolevat koodi uuesti. Kõlab lihtsalt, kuid me ei jõudnud selleni kohe. Meie puhul oli see lihtne idee: eraldada konfiguratsioonid skriptidest. St. äriloogika, kuidas installatsioon käivitub, eraldi, konfiguratsioonid eraldi.
S.O.L.I.D. for CFM
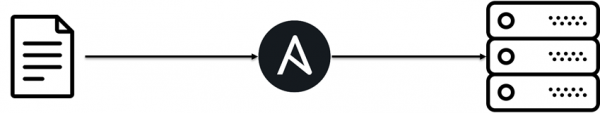
Aja jooksul projekt kasvas ja oli Ansible'i ilmumine. Peamine põhjus, miks see tekkis, on meeskonnas olemasolev ekspertisus ja see, et bash ei ole mõeldud keerukaks loogikaks. Ansible'i sisemuses on samuti keeruline loogika. Selleks, et keeruline loogika ei muutuks kaoseks, kasutatakse tarkvaraarenduses koodi organiseerimise põhimõtteid. S.O.L.I.D. Samuti mainis näiteks Grigori Petrov oma ettekandes „Miks IT-spetsialistile on isiklik bränd oluline“ küsimust, et inimene, nagu ta on loodud, suudab lihtsamalt töötada teatud sotsiaalsete elementidega, tarkvaraarenduses on need objektid. Kui neid kahte ideed ühendad ja edasi arendad, siis võib märgata, et infrastruktuuri kirjeldamisel saab kasutada S.O.L.I.D. et tulevikus oleks lihtsam seda loogikat toetada ja kohandada.
The Single Responsibility Principle
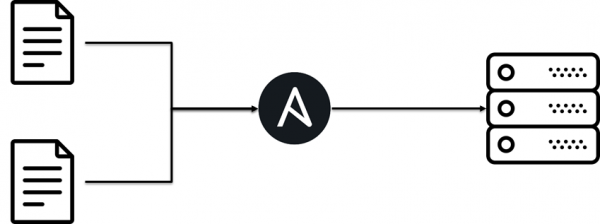
Iga klass täidab vaid ühe ülesande.
Ärge segage koodi ja looge monoliitseid jumalikke makaronimonstre. Infrastruktuur peaks koosnema lihtsatest plokkidest. Selgub, et kui jagada Ansible'i playbook väikesteks tükkideks, st Ansible'i rollideks, siis on neid lihtsam toetada.
The Open Closed Principle
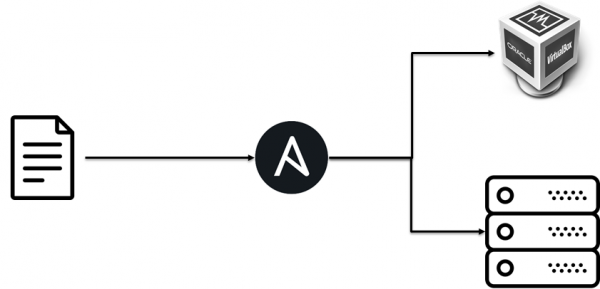
Avatud/Suletud põhimõte.
- Avatud laiendamiseks: tähendab, et üksuse käitumist saab laiendada, luues uusi üksuse tüüpe.
- Suletud muutmiseks: käitumise laiendamise tõttu ei tohi teha muudatusi koodis, mis neid üksusi kasutab.
Alguses käivitasime testimisstrateegia virtuaalmasinatel, kuid kuna äri loogika oli eraldi rakendusest, saime probleemideta lisada baremetal installatsiooni.
Liskovi asendamise põhimõte
Barbara Liskovi asendamise põhimõte. Programmis olevad objektid peavad olema asendatavad oma alamliikide eksemplaridega ilma programmi teostatavuse muutmiseta.
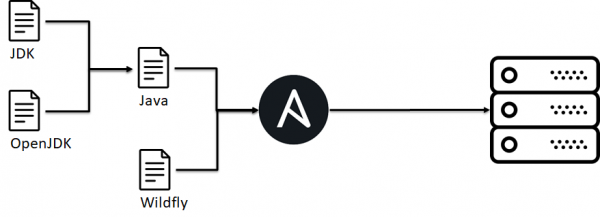
Kui vaadata laiemalt, siis ei ole see konkreetse projekti spetsiifilisus, vaid millega saab tegeleda. S.O.L.I.D., see puudutab CFM-i laiemalt, näiteks teises projektis tuleb juurutada kastiversioon Java rakendust erinevate Java, rakenduste serverite, andmebaaside, OS-ide jne peal. Seda näidet arvesse võttes vaatan edasi teisi põhimõtteid. S.O.L.I.D.
Meie puhul on infrastruktuuri meeskonna seas kokku lepitud, et kui me oleme installinud rolli imbjava või oraclejava, siis meil on olemas binaarne käivitatav fail java. See on vajalik, kuna ülemised rollid sõltuvad sellest käitumisest, nad ootavad java olemasolu. Samuti võimaldab see meil asendada ühe rakenduse / versiooni java teisega, muutmata samas rakenduse juurutamise loogikat.
Probleem peitub selles, et Ansible'is ei saa sellist asja rakendada, tulemusena tekivad meeskonnas mõned kokkulepped.
Liidese jagamise põhimõte
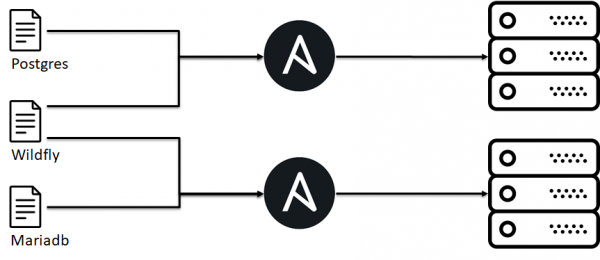
Liidese jaotamise põhimõte: "palju liideseid, mis on spetsiaalselt loodud klientide jaoks, on parem kui üks üldine liides."
Alguses proovisime kogu rakenduse juurutamise varieeruvust koondada ühte Ansible playbook'i, kuid see oli keeruline hallata, ja lähenemine, kus meil on välisse määratud liides (kliendi ootus 443 port), võimaldab meil konkreetse rakenduse jaoks infrastruktuuri komponendina jaotada erinevatest plokkidest.
Sõltuvuse pööramise põhimõte
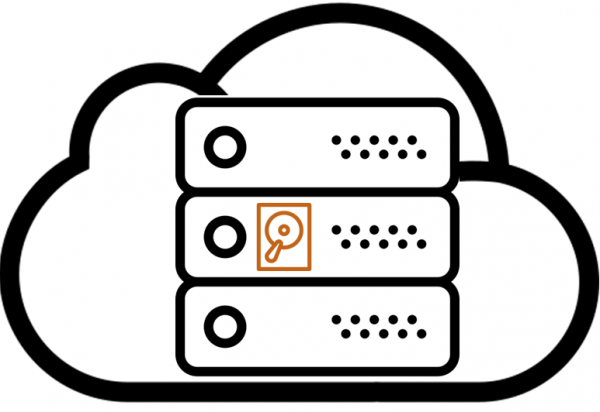
Sõltuvuse pööramise põhimõte: Ülemise tasandi moodulid ei tohiks sõltuda alumise tasandi moodulitest. Mõlemad moodulitüübid peavad sõltuma abstraktsioonidest. Abstraktsioonid ei tohiks sõltuda detailidest. Detailid peavad sõltuma abstraktsioonidest.
Siin on näide, mis põhineb antipaternil.
- Ühel meie kliendil oli privaatne pilv.
- Pilves tellisime virtuaalmasinaid.
- Kuid pilve spetsiifilisuse tõttu sõltus rakenduse juurutamine sellest, millisele hüperviisorile VM sattus.
See, the high-level logic of application deployment and dependencies flowed down to the underlying levels of the hypervisor, which meant problems when reusing this logic. Ära nii tee.
Interaction
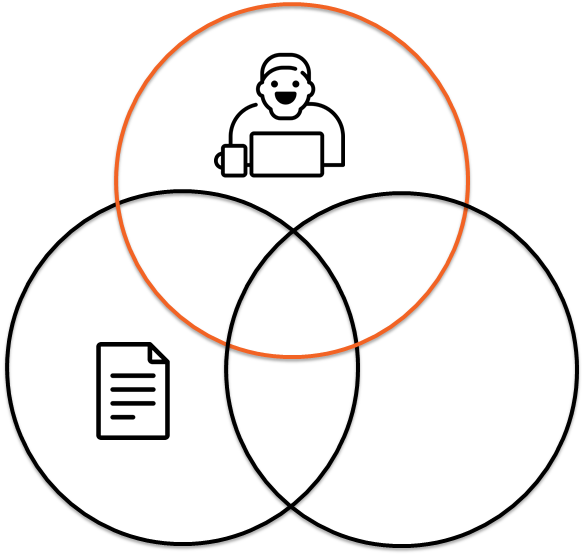
Infrastructure as code is not just about code; it’s also about the relationships between code and people, about interactions between infrastructure developers.
Bus factor
Let's assume there's Vasya on your project. Vasya knows everything about your infrastructure; what happens if he suddenly disappears? It's a very real situation, as he could get hit by a bus. Sometimes it happens. If that occurs and knowledge about the code, its structure, how it works, the login credentials, is not distributed within the team, then you may face a number of unpleasant situations. To minimize these risks and share knowledge within the team, various approaches can be used.
Pair DevOpsing
It's not like , where admins drank beer, changed passwords, and a parallel to pair programming. That is, two engineers sit at one computer, one keyboard, and start configuring your infrastructure together: setting up the server, writing Ansible roles, etc. Sounds great, but it didn't work for us. However, specific cases of this practice did work. A new employee comes in, their mentor takes a real task with them, they work together — passing on knowledge.
Another specific case is incident calls. During a problem, a group of on-duty and involved persons gathers, one leader is appointed, who shares their screen and verbalizes their thought process. Other participants follow the leader’s line of thought, peek at tricks from the console, check that a line in the log wasn’t missed, and learn something new about the system. This approach worked more often than not.
Code Review
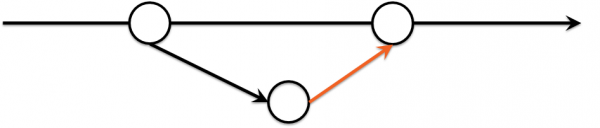
Subjectively, the more effective dissemination of knowledge about the infrastructure and how it is structured was done through code review:
- The infrastructure is described in code in the repository.
- Changes occur in a separate branch.
- During a merge request, you can see the delta of changes in the infrastructure.
The highlight here was that reviewers were chosen in rotation, according to a schedule, meaning that with some probability, you would delve into a new part of the infrastructure.
Koodistiil
Aja jooksul hakkasid arvustuste ajal tekkima erinevad arvamused, kuna arvustajatel oli oma stiil ja nende vaheldumisel sattusid nad kokku erinevate stiili valikutega: 2 tühikut või 4, camelCase või snake_case. Selle rakendamine ei õnnestunud kohe.
- Esimene idee oli soovitada linter'i kasutamist, kuna kõik on ju insenerid, kõik on targad. Aga erinevad redigeerijad, operatsioonisüsteemid, see ei ole mugav.
- See arenes botiks, mis igal probleemsel commit'il kirjutas Slack'i ja lisas linter'i väljundi. Aga enamasti oli rohkem tähtsamaid asju, ja kood jäi parandamata.
Roheline ehitusmeister
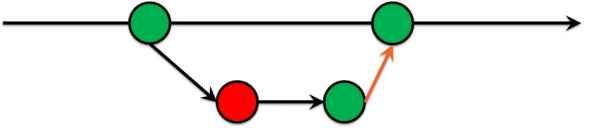
Aeg möödub ja oleme jõudnud järeldusele, et ei saa lasta masterisse commite, mis ei läbi teatud teste. Voilà! Me leiutasime Roheline ehitusmeister, mis on juba ammu tarkvara arenduses praktiseeritud:
- Arendustööd käivad eraldi harus.
- Sellel harul käivad testid.
- Kui testid ei läbi, siis kood ei pääse masterisse.
Selle otsuse vastuvõtmine oli väga raskendatud, kuna see põhjustas palju vaidlusi, kuid see oli seda väärt, kuna arvustustele hakkasid tulema liitumistaotlused, kus stiili üle ei vaieldud ja aja jooksul probleemsete kohtade arv hakkas vähenema.
IaC testimine
Lisaks stiili kontrollimisele saab kasutada ka teisi asju, näiteks kontrollida, kas teie infrastruktuur tõepoolest suudab paigaldada. Või kontrollida, et infrastruktuuri muudatused ei tooda rahakaotust. Miks see võiks vajalik olla? Küsimus on keeruline ja filosoofiline, paremini vastata jutuga, et kunagi oli Powershell'i auto-skaleri, mis ei kontrollinud piirdeolukordi => loodi rohkem virtuaalmasinaid kui vajalik => klient kulutas rohkem raha, kui oli planeeritud. See ei olnud meeldiv, aga see viga oleks olnud täiesti võimalik varasemates etappides kinni püüda.
Võib küsida, miks teha keeruline infrastruktuur veelgi keerulisemaks? Infrastruktuuri testid, nagu ka koodile, ei ole lihtsustamise küsimus, vaid teadmine, kuidas teie infrastruktuur peaks töötama.
IaC testimise pyramida
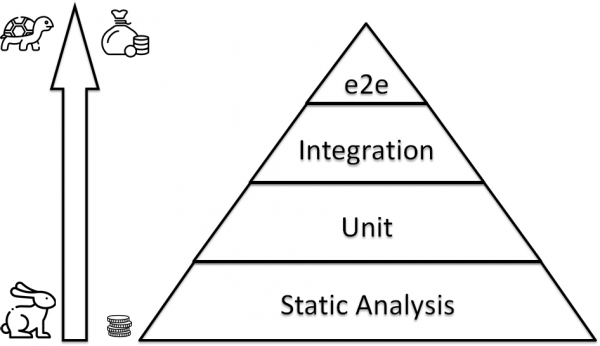
IaC testimine: staatiline analüüs
Kui kohe paigaldatakse kogu infrastruktuur ja kontrollitakse, et see töötab, võib selguda, et see võtab tohutult aega ja nõuab palju ressursse. Seetõttu peaks aluseks olema midagi kiiret, mida on palju ja mis katab mitmeid primitiivseid kohti.
Bash on petlik
Vaatame üht banaalset näidet. Valige kõik failid praegusest kataloogist ja kopeerige need mujale. Esimene asi, mis pähe tuleb:
for i in * ; do
    cp $i /some/path/$i.bak
done
Aga mis juhtub, kui failinimes on tühik? No okei, me oleme ju targad, oskame kasutada jutumärke:
for i in * ; do cp "$i" "/some/path/$i.bak" ; doneTubli? Ei! Mis siis, kui kataloogis ei ole midagi, st globaalne otsing ei toimi.
find . -type f -exec mv -v {} dst/{}.bak ;Nüüd on tubli? Ei... Unustasime, et failinimes võib olla n.
touch x
mv x "$(printf "foonbar")"
find . -type f -print0 | xargs -0 mv -t /path/to/target-dir
Staatilised analüüsi tööriistad
Eelmise sammu probleemi oleks saanud tuvastada, kui oleksime unustanud jutumärgid, selleks on looduses palju vahendeid , neid on tõeliselt palju ja tõenäoliselt leiate oma IDE jaoks lintimise tööriista oma stack'i jaoks.
Keel
Tööriist
bash
Ruby
python
ansible
IaC Testimine: Üksuse Testid
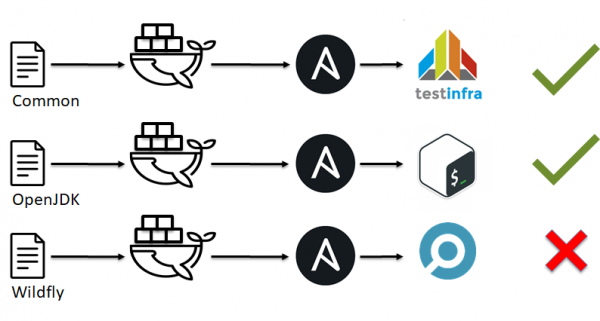
Kuidas me nägime eelmises näites, ei ole lintijad kõikvõimsad ja nad ei saa näidata kõiki probleemseid kohti. Jätkates sarnaselt tarkvaraarenduses testimisega, tuleb meelde unit testid. Siia tulevad kohe meelde , , , . Aga mida siis teha ansible’i, chef’i, saltstack’i jms. jaoks?
Alguses rääkisime S.O.L.I.D. ja sellest, et meie infrastruktuur peaks koosnema väikestest tellistest. Nüüd on nende aeg.
- Infrastruktuur jaguneb väikesteks tellisteks, näiteks Ansible'i rollideks.
- Käivitub mingi keskkond, olgu see siis docker või virtuaalmasin.
- Sellele testkeskkonnale rakendame oma Ansible'i rolli.
- Kontrollime, et kõik töötas nagu ootame (teeme testid).
- Otsustame, kas on okei või ei.
IaC Testimine: Üksuse Testimise Tööriistad
Küsimus, mis on testid CFM jaoks? Võib lihtsalt käivitada skripti või kasutada selleks valmis lahendusi:
CFM
Tööriist
Ansible
Chef
Chef
saltstack
Näide testinfra jaoks, kontrollime, et kasutajad test1, test2 oleksid olemas ja kuuluksid gruppi sshusers:
def test_default_users(host):
    users = ['test1', 'test2' ]
    for login in users:
        assert host.user(login).exists
        assert 'sshusers' in host.user(login).groups
Mida valida? Küsimus on keeruline ja ei ole üheselt mõistetav, siin on näide muudatustest projektides github’is 2018-2019 aastal:
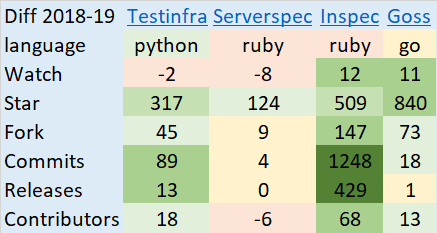
IaC Testimise Raamistikud
Kuidas kõik kokku panna ja käivitada? Võib olemasolevate inseneride piisava arvu korral. Või võib võtta valmis lahendused, ehkki neid ei ole just väga palju:
CFM
Tööriist
Ansible
Chef
Terraform
Näide muudatustest projektides github’is 2018-2019 aastal:
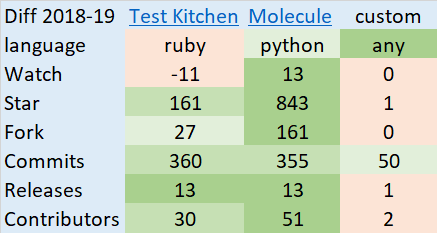
Molecule vs. Testkitchen
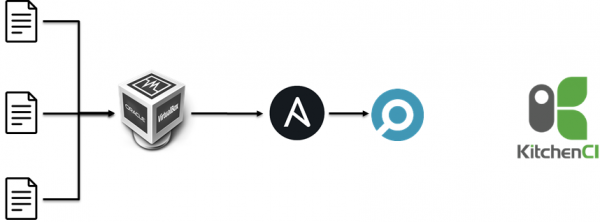
Alguses proovisime :
- Luua virtuaalmasin paralleelselt.
- Kasutage Ansible rolle.
- Käivitage inspec.
25-35 rolli puhul töötas see 40-70 minutit, mis oli liiga pikk aeg.
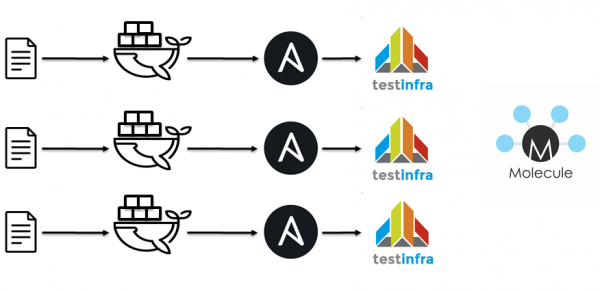
Järgmiseks sammuks oli üleminek jenkinsile / dockerile / ansible’ile / molecule’ile. Ideoloogiliselt on kõik sama.
- Lintige playbook’id.
- Lintige rollid.
- Käivitage konteiner.
- Kasutage Ansible rolle.
- Käivitage testinfra.
- Kontrollige idempotentsust.
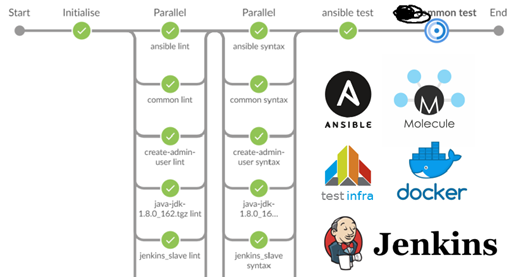
40 rolli lintimine ja kümnete testimine võttis aega umbes 15 minutit.
Valik sõltub paljuski mitmest tegurist, nagu kasutatav stekk, meeskonna ekspert ja nii edasi. Igaühel on enda viis, kuidas lahendada Unit testimise küsimus.
IaC Testimine: Integreerimistestid.
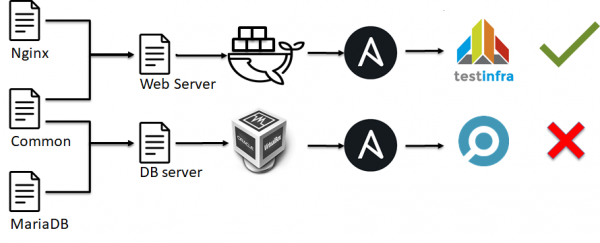
Järgmises infrastruktuuri testimise püramiidi astmes ilmuvad integreerimistestid. Need on sarnased Unit testidega:
- Infrastruktuur jaguneb väikesteks tükkideks, näiteks Ansible rollideks.
- Käivitub mingi keskkond, olgu see siis docker või virtuaalmasin.
- Selle testkeskkonna jaoks rakendatakse palju Ansible rolle.
- Kontrollime, et kõik toimis nagu ootasime (käivitame testid).
- Otsustame, kas on okei või ei.
Üldiselt ei kontrolli me eraldi süsteemi elemendi töökindlust nagu unit testides, vaid kontrollime, kuidas server on tervikuna kokku pandud.
IaC Testimine: Lõpp-lõpuks Testid.
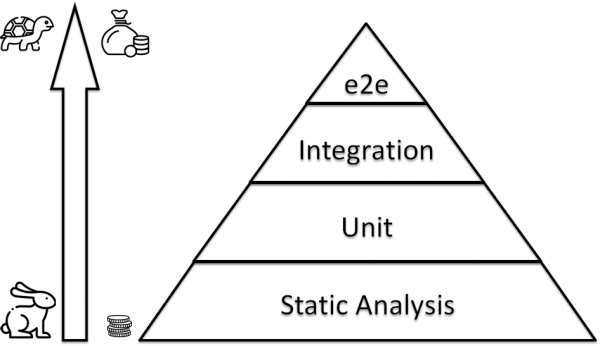
Püramiidi tipus kohtame End to End teste. See tähendab, et me ei kontrolli eraldi serveri, eraldi skripti või eraldi infrastruktuuri tükki töökindlust. Me kontrollime, kuidas paljud serverid, mis on kokku liidetud, meie infrastruktuur töötab, nagu me ootasime. Kahjuks ei ole valmis lahendusi, mida olen näinud, tõenäoliselt seetõttu, et infrastruktuur on sageli ainulaadne ja seda on keeruline mallida ja luua raamistik selle testimiseks. Lõpptulemusena loovad kõik oma lahendused. Küsitlus on olemas, aga vastust ei ole. Seetõttu räägin sellest, mis on olemas, et innustada teisi mõtlema või suunata mind, et kõik, mida me varem ei avastanud, on juba leiutatud.
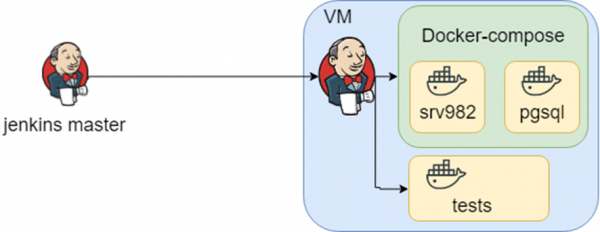
Projekt, millel on rikkalik ajalugu. Seda kasutatakse suurtes organisatsioonides ja tõenäoliselt olete teie kõigi kaudu olnud kaudselt seotud. Rakendus toetab mitmeid andmebaase, integratsiooni ja nii edasi. Teadmine, kuidas infrastruktuur võib välja näha, on palju docker-compose faile, ja teadmine, milliseid teste millistes keskkondades käivitada, on jenkins.
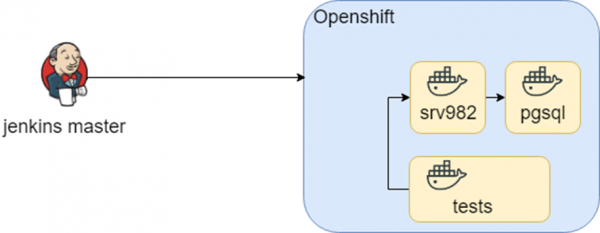
See skeem töötas piisavalt kaua, kuni me üritasime seda viia Openshift’i. Konteinerid jäid samaks, kuid käituskeskkond muutus (tervitused D.R.Y.-le jälle).
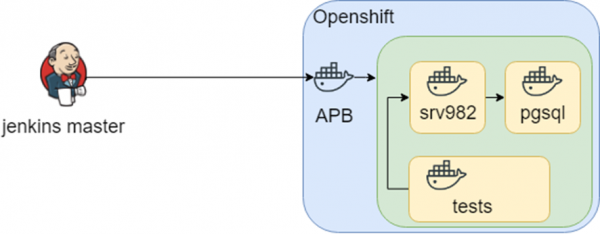
Uuringu mõte läks kaugemale ja OpenShiftis leiti selline asi nagu APB (Ansible Playbook Bundle), mis võimaldab pakkida teadmisi infrastruktuuri juurutamiseks konteinerisse. See tähendab, et olemas on reprodutseeritav ja testitav teadmiste punkt, kuidas infrastruktuuri seadistada.
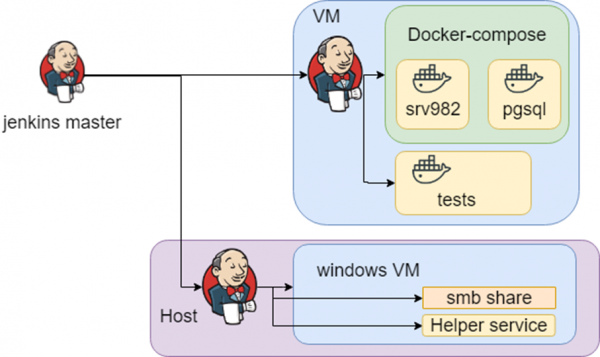
Kõik see kõlas hästi, kuni jäänud heterogeense infrastruktuuri taha: testimiseks on meil vajalik Windows. Lõpuks istub teadmine sellest, kuidas, kus ja millal juurutada ning testida, Jenkinsis.
Kokkuvõte
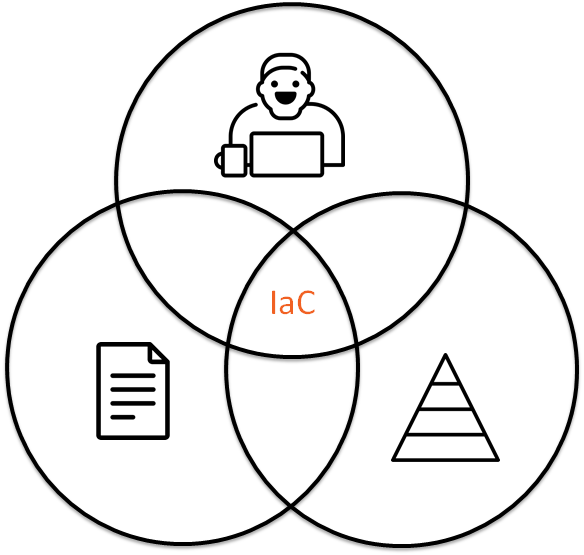
Infrastruktuur kui kood on
- Kood hoidlas.
- Inimeste koostöö.
- Infrastruktuuri testimine.
lingid
- Dry run 2019-04-24
- &
Allikas: habr.com
