

Me arutame Zabbixi ja TimescaleDB andmebaasi koostööd taustal. Näitame, kuidas alustada nullist ja kuidas migreerida PostgreSQL-ilt. Toome ka võrdlevad jõudlustestid kahe konfiguratsiooni kohta.
HighLoad++ Siberia 2019. Saal "Tomsk". 24. juuni, 16:00. Teesid ja . Järgmine HighLoad++ konverents toimub 6. ja 7. aprillil 2020. aastal Peterburis. Üksikasjad ja piletid .
Andrei Gushchin (edasi – AG): – Olen ZABBIX-i (edasi – "Zabbix") tehnilise toe insener ning treener. Olen töötanud tehnilises toetuses üle 6 aasta ja olen otseselt kokku puutunud jõudlusega. Täna räägin sellest, millist jõudlust TimescaleDB võib anda, võrreldes tavalise PostgreSQL 10-ga. Toomega ka mõningane sissejuhatus – kuidas see kõik toimib.
Peamised jõudlusväljakutsed: andmete kogumisest kuni puhastamiseni
Alustame sellest, et olemas on teatud jõudlusväljakutsed, millega igas süsteemis jälgimine silmitsi seisab. Esimene jõudlusväljakutse on kiire andmete kogumine ja töötlemine.
Hea jälgimissüsteem peab kiiresti ja õigeaegselt saama kõik andmed, töötlema neid vastavalt alarmeerimise väljenditele, see tähendab töötlema neid teatud kriteeriumide alusel (erinevates süsteemides on see erinev) ja salvestama andmebaasi, et neid hiljem kasutada.
Teine jõudlusväljakutse on ajaloo salvestamine. Andmeid tuleb salvestada andmebaasis ning millele tuleb tagada kiire ja mugav juurdepääs nendele mõõdikutele, mis on kogutud mingil ajavahemikul. Kõige tähtsam on, et need andmed oleks mugavalt kättesaadavad, et neid kasutada aruannetes, graafikutes, alarmeerimises, mingites lävendites, teavitustes jne.
Kolmas jõudlusväljakutse on ajaloo puhastamine, st kui tuleb päev, mil ei ole tarvis säilitada teatud üksikasjalikke mõõdikuid, mis on kogutud 5 aasta jooksul (isegi kuude või kahe kuu pärast). Mõned võrgu sõlmed on eemaldatud või mõned hostid, mõõdikud ei ole enam vajalikud, kuna need on ajale jalgu jäänud ja lõpetanud kogumise. Kõik see tuleb puhastada, et teie andmebaas ei kasvaks liiga suureks. Üldiselt on ajaloo puhastamine sageli tõsine proovikivi andmehoidla jaoks – see mõjutab sageli jõudlust oluliselt.
Kuidas lahendada vahemäluprobleeme?
Ma räägin nüüd konkreetselt Zabbixist. Zabbixis on esimese ja teise kutsungiga seotud probleemid lahendatud vahemälu abil.
Andmete kogumine ja töötlemine – me kasutame kõikide nende andmete salvestamiseks mälupilti. Nüüd räägitakse neist andmetest lähemalt.
Samuti on andmebaasi poolel olemas teatud vahemälu peamiste valikute jaoks – graafikute ja muu suhtes.
Vahemälu Zabbix-serveri poolel: meil on ConfigurationCache, ValueCache, HistoryCache, TrendsCache. Mis need on?
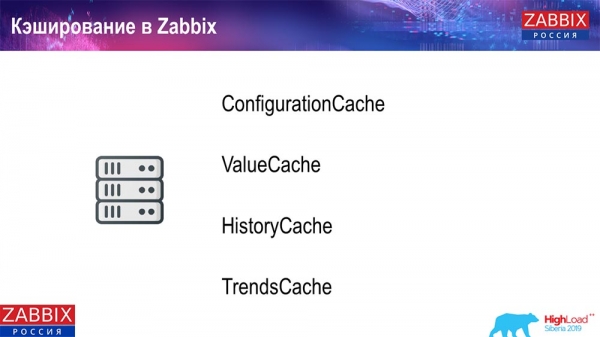
ConfigurationCache on peamine vahemälu, kus me salvestame mõõdikud, hostid, andmeelemendid, triggrid; kõik, mis on vajalik andmete eeltöötlemiseks, andmete kogumiseks, millistest hostidest andmeid koguda ja kui tihti. Kõik see salvestatakse ConfigurationCache'i, et mitte minna andmebaasi, et mitte luua liigseid päringuid. Serveri käivitamisel värskendame seda vahemälu (loome) ja värskendame seda perioodiliselt (sõltuvalt konfiguratsiooni seadistustest).
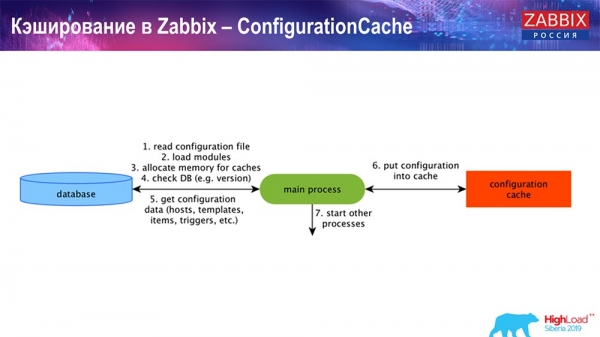
Vahemälu Zabbixis. Andmete kogumine
Siin on skeem piisavalt suur:
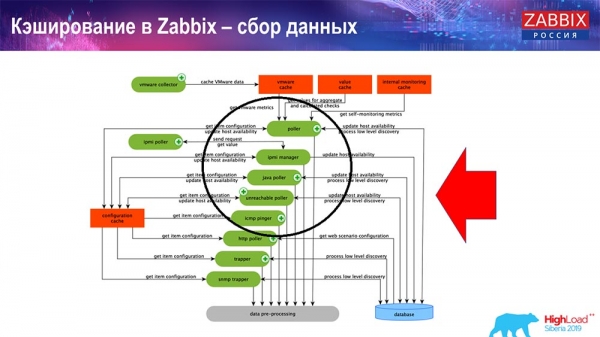
Peamised skeemis on need kogujad:
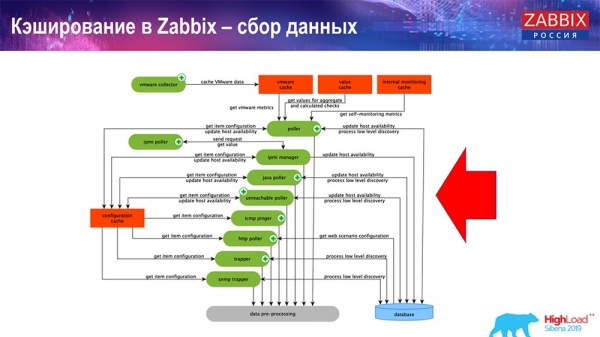
Need on kogumise protsessid, erinevad pollerid, mis vastutavad erinevate kogumiste tüüpide eest. Need koguvad andmeid icmp, ipmi ja erinevate protokollide kaudu ning edastavad need eeltöötlemiseks.
Eelprotsessimise Ajaloo vahemälu
Samuti, kui meil on arvutatud andmeelemendid (kes on Zabbixiga tuttav, see teab), st arvutatud, agregatiivsed andmeelemendid, siis võtame need otse ValueCache'ist. Kuidas see täidetakse, räägin hiljem. Kõik need kogujad kasutavad ConfigurationCache'i, et saada oma ülesandeid ja edastavad need edasi eeltöötlemiseks.
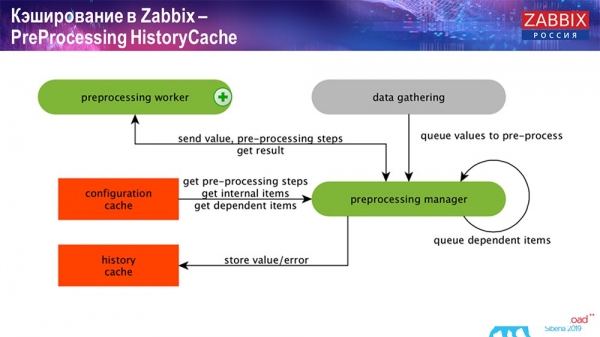
Eeltöötlemine kasutab samuti ConfigurationCache'i, et saada eeltöötlemise samme, töötleb neid andmeid erinevate meetoditega. Alates versioonist 4.2 on see meil välja viidud proksisse. See on väga mugav, kuna eeltöötlemine on üsna töömahukas operatsioon. Ja kui teil on väga suur Zabbix, kus on palju andmeelemente ja kõrge kogumise sagedus, siis see hõlbustab tööd oluliselt.
Seega, pärast seda, kui me oleme andmeid mingil moel eeltöötlemise abil töötlenud, salvestame need HistoryCache'i, et neid hiljem töödelda. Sellega lõpeb andmete kogumine. Liigume peamise protsessi juurde.
History syncer töö
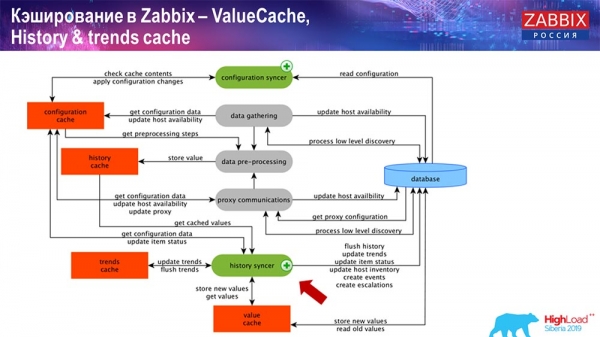
Peamine protsess «Zabbixis» (kuna see on monoliitne arhitektuur) on History syncer. See on peamine protsess, mis tegeleb iga andmeelemendi atomaarse töötlemisega, st iga väärtusega:
- saab väärtuse (ta võtab selle HistoryCache'ist);
- kontrollib Configuration syncer'it: kas on olemas mõni triggereid arvutamiseks – arvutab need välja;
kui on – loob sündmused, loob eskalatsiooni, et luua teavitamine, kui see on vajalik konfiguratsiooni järgi; - salvestab triggereid edasisteks töötlemiseks, aggregatsiooniks; kui aggregaadite viimase tunni jooksul jne, siis see väärtus talletatakse ValueCache'i, et mitte pöörduda ajaloo tabeli poole; seeläbi täidetakse ValueCache vajalike andmetega, mis on vajalikud triggereid arvutamiseks, arvutatavate elementide jne;
- edasi kirjutab History syncer kõik andmed andmebaasi;
- andmebaas kirjutab need kettale – sellega protsess lõpetatakse.
Andmebaasid. Vahemälu
Andmebaasi poolel, kui soovite vaadata diagramme või mõnda aruannet sündmuste kohta, on erinevaid vahemälusid. Kuid selle ettekande raames ma neist rääkima ei hakka.
MySQL-i jaoks on olemas Innodb_buffer_pool, veel palju erinevaid vahemälusid, mida saab ka seadistada.
Aga need on peamised:
- shared_buffers;
- effective_cache_size;
- shared_pool.
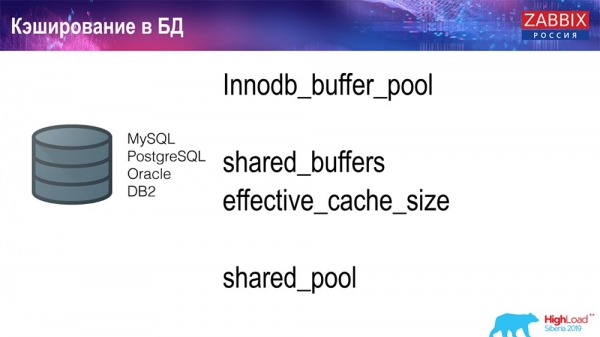
Ma olen kõikide andmebaaside jaoks toonud välja, et on olemas teatud vahemälud, mis võimaldavad hoida RAM-is andmeid, mida sageli on tulemuste jaoks vaja. Seal on neil oma tehnoloogiad selle jaoks.
Andmebaasi jõudlusest
Seega on olemas konkurentsikeskkond, st «Zabbix» server kogub andmeid ja salvestab neid. Ta loeb ajaloo järgi ka pärast taaskäivitamist ValueCache'i täitmiseks jne. Samuti võivad teil olla skriptid ja aruanded, mis kasutavad «Zabbix» API-d, mis põhineb veebiliidesele. «Zabbix» API siseneb andmebaasi ja saab vajalikud andmed diagrammide, aruannete või mingite sündmuste, viimaste probleemide loendi saamiseks.
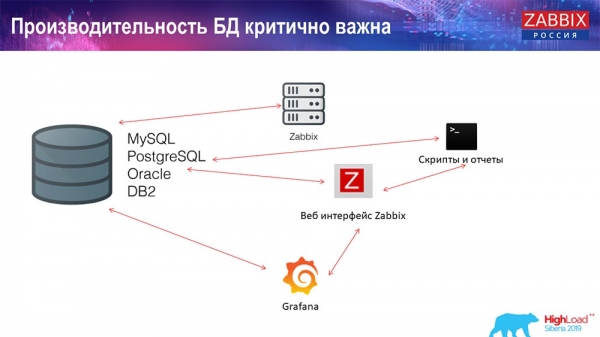
Samuti on väga populaarne lahendus visualiseerimiseks Grafana, mida meie kasutajad kasutavad. See oskab otse sisse minna nii läbi «Zabbix» API kui ka andmebaasi. See loob samuti teatud konkurentsi andmete hankimise osas: on vajalik täiendav, hea andmebaasi seadistus, et vastata kiirele tulemuste väljastamisele ja testimisele.
Ajaloo puhastamine. Zabbixis on Housekeeper.
Kolmas käsk, mida kasutatakse «Zabbixis», on ajaloo puhastamine Housekeeperi abil. «Housekeeper» järgib kõiki seadistusi, see tähendab, et meie andmeelementides on näidatud, kui kaua (päevades) andmeid säilitada, kui kaua säilitada trende ja muutuste dünaamikat.
Ma ei maininud TrendCache'i, mida me reaalajas arvutame: andmed sisenevad, me kogume need tunni kaupa (peamiselt on need arvud viimase tunni kohta), keskmine / minimaalne hulk ja salvestame need üks kord tunnis muutuste dünaamikatabelisse («Trendid»). «Housekeeper» käivitatakse ja eemaldab tavaliste selektide abil andmed andmebaasist, mis ei ole alati efektiivne.
Kuidas mõista, et see ei ole efektiivne? Võite siseprotsesside jõudluse graafikutel näha sellist pilti:
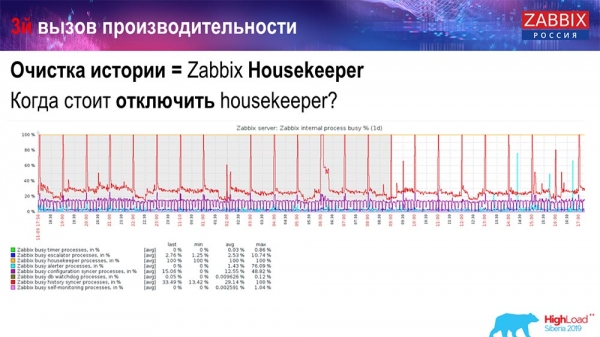
Teie Ajaloo sünkroniseerija on pidevalt hõivatud (punane graafik). Ja «oranž» graafik, mis jookseb peal. See on «Housekeeper», mis käivitub ja ootab andmebaasist, millal see eemaldab kõik read, mille ta on määranud.
Võtame mingi Item ID: viimase 5000 kustutamine; loomulikult indekseid mööda. Kuid tavaliselt on andmekogum piisavalt suur – andmebaas loeb ikkagi selle kettalt välja ja tõstab selle vahemällu, mis on andmebaasile väga kulukas operatsioon. Sõltuvalt selle suurusest võib see tekitada teatud jõudlusprobleeme.
«Housekeeperi» saab välja lülitada lihtsa viisi kaudu – meil on tuttav veebiliides. Seaded Administration general (seaded «Housekeeperi» jaoks) keelame sisemise hoolduse sisemise ajaloo ja trendide jaoks. Seega «Housekeeper» ei halda enam seda:
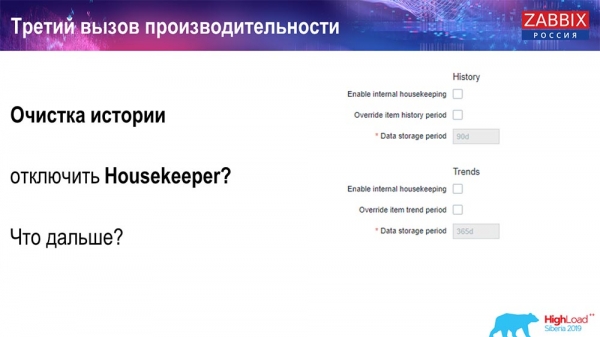
Mida edasi teha? Olete selle välja lülitanud, teie graafikud on joondunud... Millised võivad olla edasised probleemid? Mis võiks aidata?
Partitsioneerimine (sektsioonideks jagamine)
Tavaliselt seadistatakse see igal relatsioonilisel andmebaasil, mida ma loetlesin, erinevalt. MySQL-il on oma tehnoloogia. Kuid üldiselt on need väga sarnased, kui rääkida PostgreSQL 10-st ja MySQL-st. Loomulikult on seal palju sisemisi erinevusi selle asja elluviimisel ja sellel, kuidas see mõjutab jõudlust. Kuid üldiselt toob uue partitsiooni loomine sageli kaasa teatud probleeme.
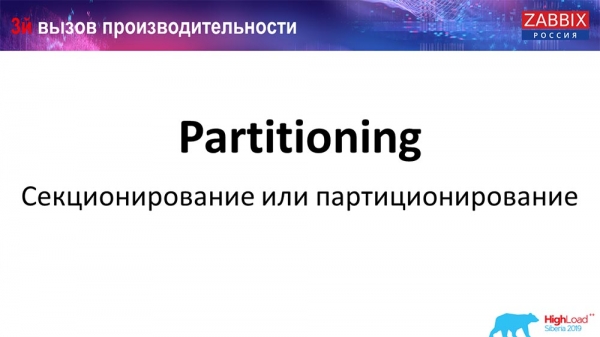
Sõltuvalt teie seadistusest (kui palju andmeid luuakse ühe päeva jooksul) määratakse tavaliselt minimaalne aeg – 1 päev/partitsioon, ning „trendid”, muutuste dünaamika – 1 kuu/uus partitsioon. See võib muutuda, kui teil on väga suur seadistus.
Las ma ütlen kohe seadistuse suuruste kohta: kuni 5000 uut väärtust sekundis (tuntud kui nvps) loetakse väikeseks „seadistuseks”. Keskmine on vahemikus 5 kuni 25 tuhat väärtust sekundis. Kõik, mis on üle selle, on suured ja väga suured installatsioonid, mis vajavad väga hoolikat andmebaasi seadistamist.
Väga suurtes installatsioonides võib 1 päev osutuda mitte optimaalseks. Olen isiklikult näinud MySQL-s partitsioone, mis on 40 gigabaiti päevas (ja rohkemgi). See on väga suur andmemaht, mis võib põhjustada probleeme. Seda tuleb vähendada.
Miks on partitsioneerimine vajalik?
Ma arvan, et kõik teavad, mida partitsioneerimine tähendab – see on tabelite jagamine. Sageli on need eraldi failid kettal ja span-küsimused. See valib ühe partitsiooni optimaalselt, kui see sobib tavalisse partitsioneerimisse.
Zabbixi puhul kasutatakse, nimelt vahemiku järgi, st kasutame ajatemplit (tavaline number, aeg alates ajastu algusest). Määrate päeva alguse/lõpu, ja see on partitsioon. Seega, kui pöördute kahe päeva taguste andmete poole, valitakse need andmed andmebaasist kiiremini, sest tuleb ainult üks fail laadida vahemällu ja esitada (mitte suur tabel).
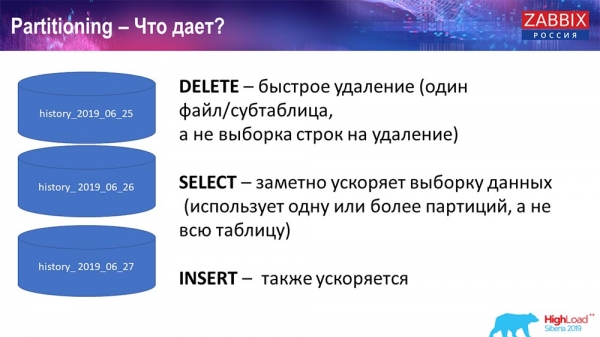
Paljud andmebaasid kiirendavad ka andmete sisestamist (sisestamine ühte laps-tabelisse). Kui ma räägin abstraktselt, siis see on samuti võimalik. Partitsioneerimine aitab sageli.
Elasticsearch NoSQL jaoks
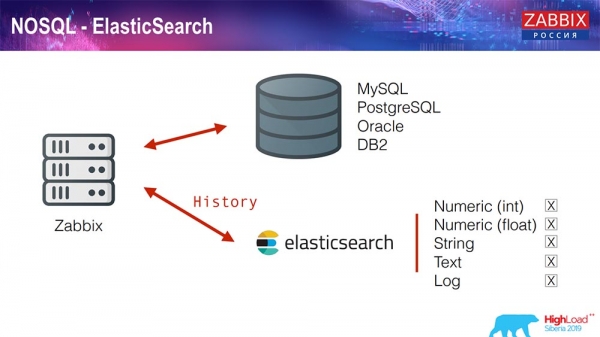
Hiljuti, versioonis 3.4, tegevusime NoSQL lahenduste rakendamisega. Lisatud on võimalus kirjutada Elasticsearchi. Saate kirjutada erinevaid tüüpe: valite – kas kirjutada numbreid või mingeid märke; meil on string-tekst, logisid saate kirjutada Elasticsearchi… Seega, veebiliides hakkab samuti pöörduma Elasticsearchi poole. See töötab teatud juhtudel suurepäraselt, kuid hetkel saab seda kasutada.
TimescaleDB. Hüppertabelid
4.4.2 jaoks pöörasime tähelepanu ühele asjale, nimelt TimescaleDB-le. Mis see on? See on laiendus PostgreSQL jaoks, seega omab see natiivset PostgreSQL liidest. Lisaks võimaldab see laiendus palju tõhusamalt töötada ajaseeriandmetega ja omada automaatset partitsioneerimist. Kuidas see välja näeb:
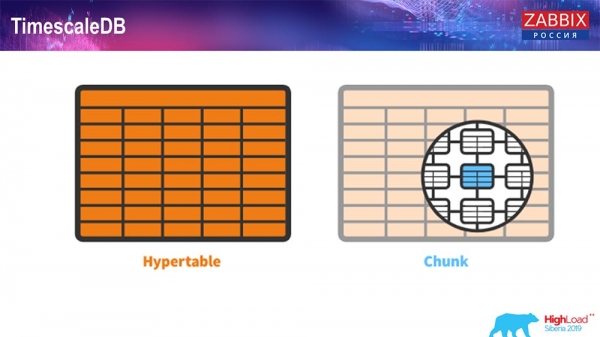
See on hypertable – selline mõisted on Timescale’is. See on hüpertabel, mille te loote, ja selles on tükid (chunk). Tükid – need on partitsioonid, need on laps-tabelid, kui ma ei eksi. See on tõeliselt tõhus.
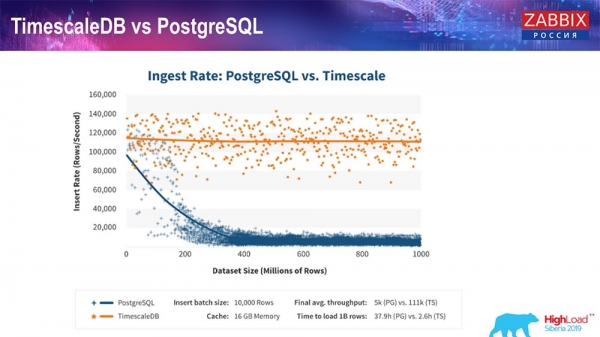
TimescaleDB ja PostgreSQL
TimescaleDB tootjate kinnituste kohaselt kasutavad nad paremat päringute töötlemise algoritmi, eriti insert'id, mis võimaldab hoida enam-vähem stabiilset jõudlust suureneva andmehulkade sisestamisel. See tähendab, et peale 200 miljoni märke hakkab PostgreSQL tavaliselt tugevalt aeglustuma ja kaotab jõudluse sisuliselt nulli, samas kui Timescale võimaldab sisestada insert'e võimalikult tõhusalt, olenemata andmete hulgast.
Kuidas installida TimescaleDB? See on üsna lihtne!
Dokumentatsioonis on see kirjas – saab paigaldada pakkidena igasugustele… See sõltub ametlikest PostgreSQL pakkidest. Võib käsitsi kompileerida. Nii juhtus, et pidin andmebaasi jaoks kompileerima.
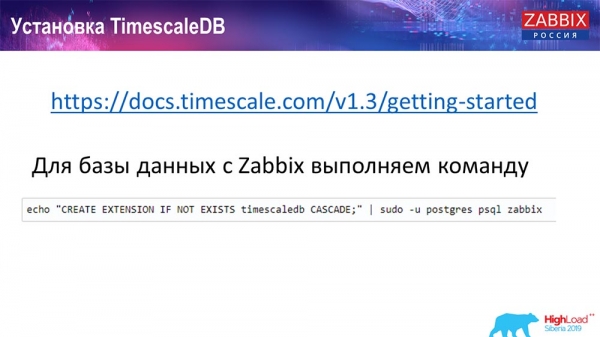
Zabbixis aktiveerime lihtsalt laienduse. Arvan, et need, kes on PostgreSQL'is laiendust kasutanud... Lihtsalt aktiveerite laienduse, loote selle Zabbixi andmebaasi jaoks, mida kasutate.
Ja viimane samm...
TimescaleDB. Ajaloo tabelite migratsioon
On vaja luua hypertable. Selleks on olemas spetsiaalne funktsioon – Create hypertable. Esimeseks parameetriks määrate tabeli, mis on selle andmebaasi jaoks vajalik (mille jaoks tuleb luua hüpertabel).
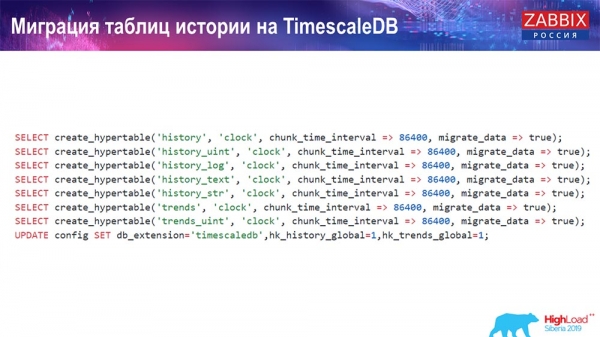
Kohandage väli, mille alusel on vaja luua, ja chunk_time_interval (see on partitsioonide (chunkide) vaheline intervall, mida tuleb kasutada). 86 400 – see on üks päev.
Migrate_data parameeter: kui sisestate true, siis see kannab kõik praegused andmed eelnevalt loodud chunkidesse.
Kasutasin ise migrate_data - see võtab korralikult aega, olenevalt teie andmebaasi suurusest. Mul oli üle ühe terabaiti – loomine kestis kauem kui tund. Mõningatel juhtudel testimise käigus kustutasin ajaloolisi andmeid (history_text) ja stringi (history_str), et mitte edasi kanda – need ei olnud mulle tegelikult huvitavad.
Ja viimane värskendus, mille teeme meie db_extention'is: me paigaldame timescaledb, et andmebaas ja eriti meie «Zabbix» mõistaks, et on olemas db_extention. See aktiveerib ja kasutab õigesti süntaksit ja päringuid andmebaasi, kasutades juba tarvitusele võetud «funktsioone», mis on vajalikud TimescaleDB jaoks.
Serveri konfiguratsioon
Kasutasin kahte serverit. Esimene server on piisavalt väike virtuaalmasin, 20 protsessorit, 16 gigabaiti mälu. Seadsin sellele üles «PostgreSQL» 10.8:
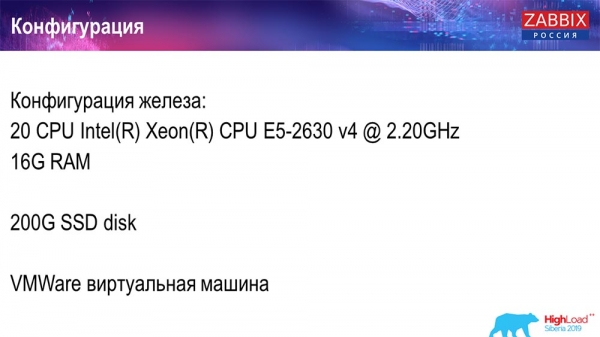
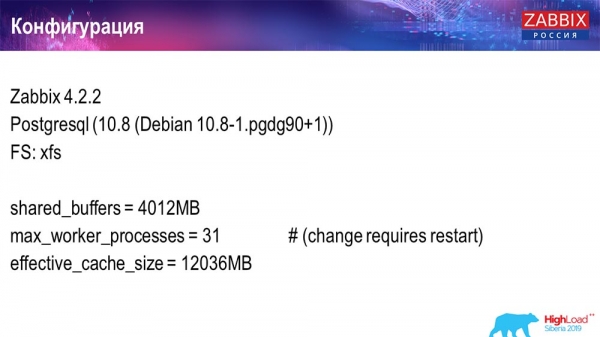
Sisendoperatsioonisüsteem oli Debian, failisüsteem – xfs. Teostasime minimaalset seadistamist, et kasutada just seda andmebaasi, välja arvatud need, mis kasutab «Zabbix». Samal masinal oli installitud «Zabbix» server, PostgreSQL ja koormuse agendid.
Kasutasin 50 aktiivset agenti, mis kasutasid LoadableModule'i, et kiiresti genereerida erinevaid tulemusi. Need genereerisid ridu, numbreid jne. Täitsin andmebaasi suure hulga andmetega. Algne konfiguratsioon sisaldas 5000 andmeelementi iga hosti kohta, kusjuures iga andmeelement sisaldas käivituspunkti – et see oleks tõeline seadistus. Mõnikord on isegi ühe käivituspunkti kasutamine vajalik.
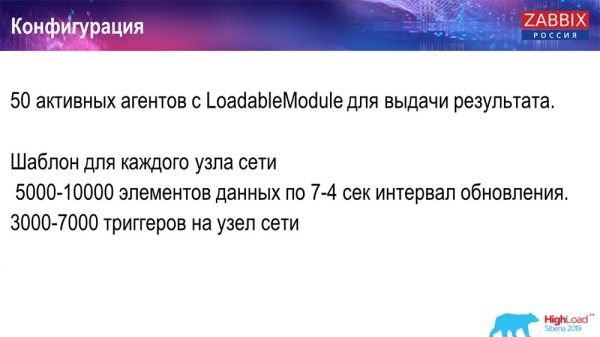
Uuendamise intervalli, koormust reguleerisin sellega, et kasutasin mitte ainult 50 agenti (lisades veel), vaid ka dünaamiliste andmeelementide kaudu ja vähendasin uuendamise intervalli 4 sekundini.
Tulemuslikkuse test. PostgreSQL: 36 tuhat NVP-d
Esimene käivitamine, esimene seadistus oli mul puhtal PostgreSQL 10-l selle riistvara peal (35 tuhat väärtust sekundis). Üldiselt, nagu ekraanil näha, kestab andmete sisestamine murrangulise aja jooksul – kõik on hea ja kiire, SSD-d (200 gigabaiti). Ainsaks probleemiks on, et 20 GB täituvad üsna kiiresti.
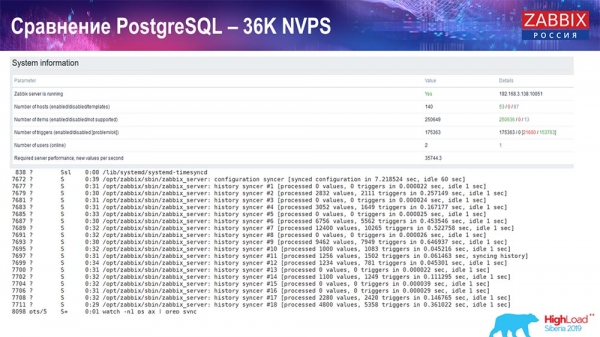
Edasi on piisavalt palju selliseid diagramme. See on standardne «Zabbix» serveri tulemuslikkuse armatuurlaud.
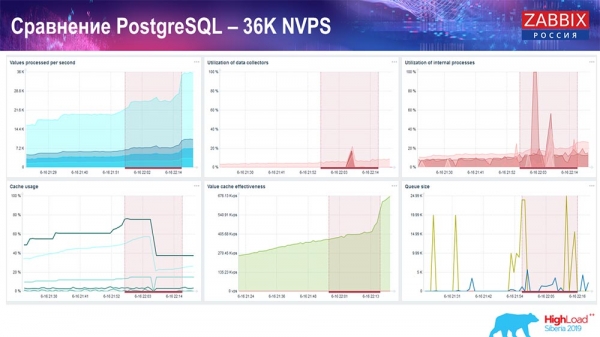
Esimene diagramm – väärtuste arv sekundis (sinine, üleval vasakul), 35 tuhat väärtust antud juhul. See (üleval keskel) on koormusprotsesside kogumise osas, ja see (üleval paremal) – on koormus täpselt sisemiste protsesside osas: history syncers ja housekeeper, mis siin (alumisel keskel) töödelda piisava aja jooksul.
See all available plans for our services
Performance Test. PostgreSQL: 50,000 NVPs
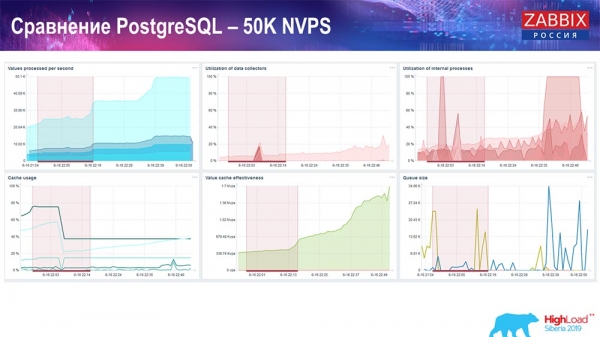
Next, I increased the load to 50,000 values per second on the same hardware. When loading with 'Housekeeper', 10,000 values were already being written in 2-3 seconds with computation. This is shown in the next screenshot:
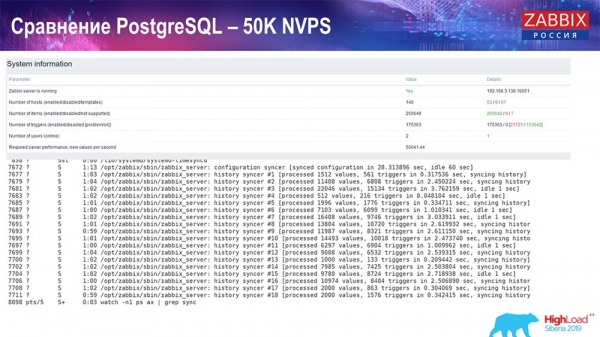
'Housekeeper' already starts to interfere with operations, but overall the load on the history syncers is still at 60% (the third graph, top right). HistoryCache is actively filling up during the operation of 'Housekeeper' (bottom left). It was about half a gigabyte, filling up to 20%.
Performance Test. PostgreSQL: 80,000 NVPs
I then increased it to 80,000 values per second:
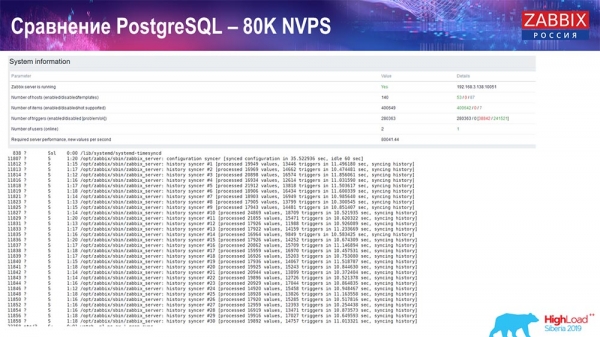
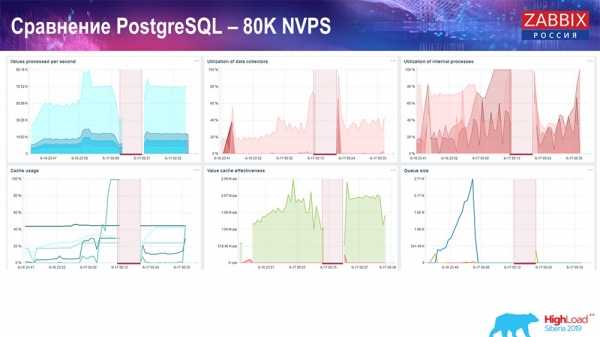
This was approximately 400,000 data items, 280,000 triggers. The insertion, as you can see, based on the load of the history syncers (there were 30 of them) was already quite high. I then adjusted various parameters: history syncers, cache... On this hardware, the load on the history syncers started to approach maximum capacity, virtually 'on the shelf' - accordingly, HistoryCache went into a very high load:
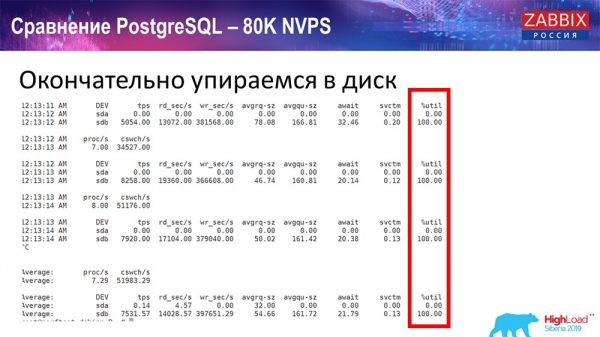
All this time I monitored all system parameters (how the CPU is used, RAM) and found that disk utilization was at maximum - I reached the disk's maximum capability on this hardware, on this virtual machine. 'Postgres' began to actively flush data at such intensity, and the disk could not keep up with writing and reading...
I took another server, which already had 48 processors and 128 gigabytes of RAM:
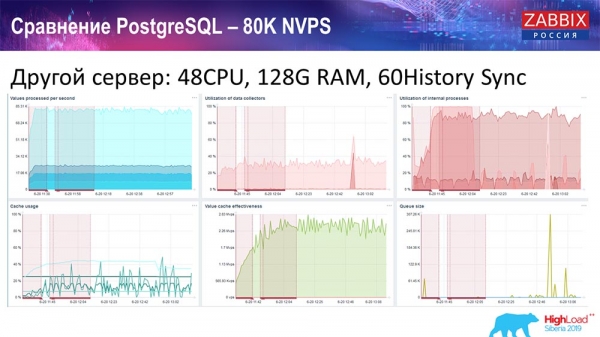
I also 'tuned it' - installed 60 History syncers and achieved acceptable performance. In fact, we are not 'on the shelf', but this is probably the performance limit where something needs to be done.
Performance Test. TimescaleDB: 80,000 NVPs
My main task was to use TimescaleDB. Each graph shows a drop:
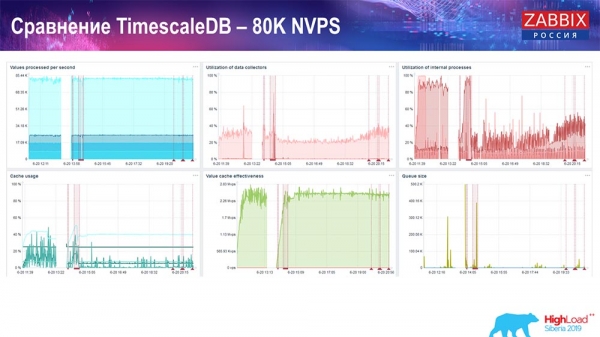
Need kaovad on andmete migreerimine. Pärast seda on Zabbix-serveris ajaloosünkronisaatorite laadimisprofiil, nagu näete, väga tugevalt muutunud. See võimaldab praktiliselt kolm korda kiiremini andmeid sisestada ja kasutada vähem HistoryCache'i – seega saadetakse teile andmed õigeaegselt. Jälle, 80 tuhat väärtust sekundis on piisavalt kõrge kiirus (muidugi mitte Yandexi jaoks). Üldiselt on see piisavalt suur seadistus ühel serveril.
PostgreSQL jõudluse test: 120 tuhat NVP-d
Seejärel suurendasin andmeelementide arvu poolmiljonini ja sain arvutatud väärtuseks 125 tuhat sekundis:
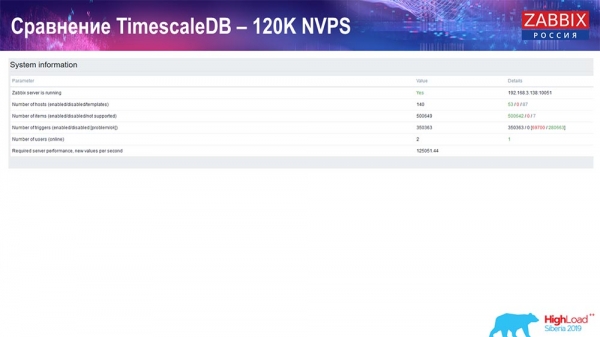
Ja sain sellised graafikud:
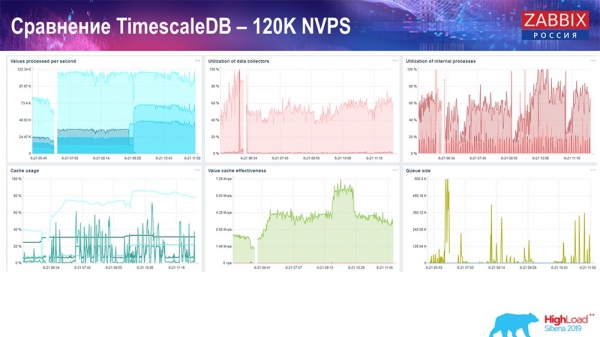
Põhimõtteliselt on see töökorras seadistus, mis saab piisavalt kaua töötada. Kuid kuna mul oli ainult 1,5 terabaidise suurusega kõvaketas, siis kulutasin selle paariga päevaga. Kõige tähtsam on see, et samal ajal loodi uusi partitsioone TimescaleDB-s ja see ei mõjutanud jõudlust üldse, mida ei saa öelda MySQL kohta.
Tavaliselt luuakse partitsioonid öösel, kuna see blokeerib täielikult sisestamise ja töö tabelitega, mis võib viia teenuse halvenemiseni. Sel juhul seda pole! Peamine ülesanne oli kontrollida TimescaleDB võimekust. Tuli välja selline number: 120 tuhat väärtust sekundis.
Samuti on kogukonnas näiteid:
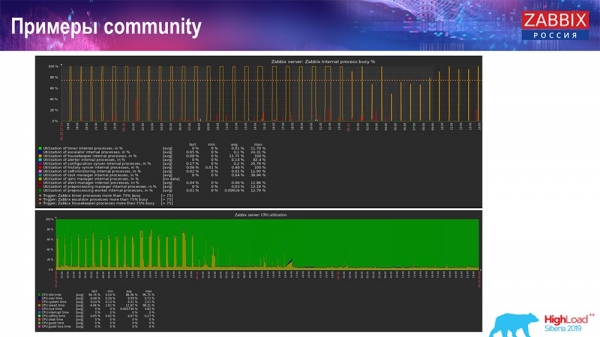
Inimene lülitas ka TimescaleDB sisse ja IO kaalumise koormus protsessoris langes; samuti vähenes sisemiste protsesside kasutamine TimescaleDB sisselülitamise tõttu. Ja need on tavalised plaadid, st tavaline virtuaalmasin tavalistel ketastel (mitte SSD)!
Mõne väikese seadistuse jaoks, mis jääb ketta jõudluse piiridesse, on TimescaleDB, nagu mulle tundub, väga hea lahendus. See võimaldab suhteliselt hästi jätkata töötamist enne, kui migreerite kiiremaks andmebaasi riistvaraks.
Kutsun teid kõiki meie üritustele: Konverents Moskvasse, Tippkohtumine Riiga. Kasutage meie kanaleid – Telegram, foorum, IRC. Kui teil on küsimusi – tulge meie stendile, võime rääkida kõigest.
Küsimused publikult
Küsimus publikust (edaspidi – A): – Kui TimescaleDB on nii lihtne seadistada ja see pakub sellist jõudluse kasvu, kas siis tasub seda kasutada kui parimat praktikat „Zabbixi“ seadistamiseks koos „PostgreSQL-iga“? Kas sellel lahendusel on mingeid peidetud probleeme või miinuseid, või võin ma rahulikult võtta „PostgreSQL-i“, paigaldada sinna „Timescale-i“ kohe, kasutada seda ja mitte muretseda probleemide pärast?
AG: – Jah, ma ütleksin, et see on hea soovitus: kasutada „PostgreSQL-i“ kohe koos TimescaleDB laiendusega. Nagu ma juba mainisin, on palju häid arvustusi, vaatamata sellele, et see „funktsioon“ on eksperimentaalne. Kuid tegelikult näitavad testid, et see on suurepärane lahendus (koos TimescaleDB-ga), ja ma arvan, et see areneb edasi! Me jälgime, kuidas see laiendus areneb ja teeme vajalikud parandused.
Oleme isegi arendamise ajal toetanud ühte nende tuntud „funktsiooni“: seal sai chunk-dega veidi teisiti töötada. Kuid see eemaldati järgmistes väljaannetes, ja me pidime lõpetama selle koodi toetamise. Soovitaksin seda lahendust kasutada paljudes seadistustes. Kui te kasutate MySQL... Keskmiste seadistuste jaoks töötab igasugune lahendus hästi.
A: – Viimastel graafikutel, mis tulid kogukonnalt, oli graafik „Housekeeper'ist“:
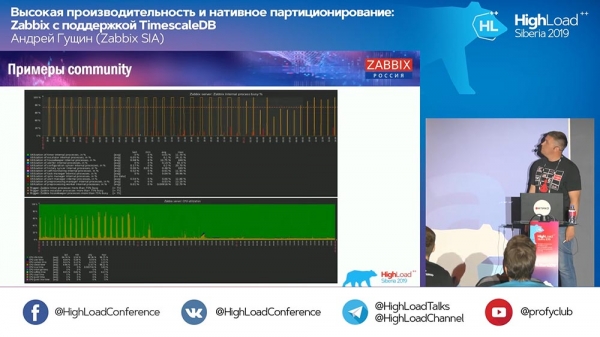
Ta jätkas tööd. Mida teeb „Housekeeper“ TimescaleDB korral?
AG: – Praegu ei oska ma täpselt öelda – vaatan koodi ja ütlen rohkem üksikasju. Ta kasutab TimescaleDB päringuid mitte chunk-de eemaldamiseks, vaid agregatsiooniks. Praegu ei ole ma valmis sellele tehnilisele küsimusele vastama. Täna või homme selgitame seda standil.
A: – Mul on sarnane küsimus – Timescale-i kustutamise operatsiooni jõudluse kohta.
A (küsimus publikust): – Kui kustutate andmeid tabelist, kui teete seda delete kaudu, peate te tabeliga läbi käima – kustutama, puhastama, märkima kõik tulevase tühi. Timescale'is, kuna teil on chunk'id, saate neid kas maha visata. Ütleme nii, et te ütlete failile, mis asub suurtes andmetes: „Kustuta!“
«TimeScale» lihtsalt mõistab, et sellist chunk'i enam ei ole. Ja kuna see integreerub päringute ajakavasse, püüab see teie tingimusi select'is või muudes operatsioonides hook'ide kaudu ja mõistab kohe, et seda chunk'i enam ei ole – «Ma sinna enam ei lähe!» (andmed puuduvad). Nii et kõik – tabeli skaneerimine asendatakse binaarfaili kustutamisega, seega on see kiire.
A: – Oleme juba puudutanud mitte-SQLi teemat. Nii palju kui ma aru saan, ei ole «Zabbixile» väga vajalik andmete modifitseerimine, ja kõik see on midagi sarnast logiga. Kas on võimalik kasutada spetsialiseeritud andmebaase, mis ei saa oma andmeid muuta, kuid samas salvestavad, koguvad ja annavad palju kiiremini – näiteks Clickhouse, miski Kafka-taoline?.. Kafka on ju ka log! Kas neid on võimalik kuidagi integreerida?
AG: – Ekspordi saab teha. Meil on alates versioonist 3.4 teatud «funktsioon»: saate kirjutada kõik ajaloolised failid, sündmused ja kõik muu failidesse; ja seejärel saata need mõne töötleja kaudu mis tahes teise andmebaasi. Tegelikult paljud teevad ümber ja kirjutavad otse andmebaasi. Kõik need ajaloo-sünkronisaatorid kirjutavad otse failidesse, pööravad neid ja nii edasi, ja selle saate edastada «Clickhouse'i». Ma ei saa planeeringutest rääkida, kuid võib-olla jätkub tulevane toetus NoSQL-lahendustele (nagu «Clickhouse»).
A: – Kas on üldse võimalik täielikult loobuda Postgresist?
AG: – Loomulikult on «Zabbixis» kõige keerulisem osa ajaloolised tabelid, mis tekitavad kõige rohkem probleeme, ja sündmused. Sel juhul, kui te ei hoia sündmusi kaua ja hoiate ajaloo trende mõnes muus kiiremas salvestuses, siis üldiselt ei tohiks probleeme olla.
A: – Kas saaksite hinnata, kui palju kiiremini kõik töötab, kui lähete näiteks «Clickhouse'i»?
AG: – Ma ei ole testinud. Arvan, et vähemalt samu numbreid on üsna lihtne saavutada, arvestades, et «Clickhouse'il» on oma liides, kuid ei saa kindlalt öelda. Parim on testida. Kõik sõltub konfiguratsioonist: kui palju teil on hoste ja nii edasi. Salvestamine on üks asi, kuid andmete hankimine on veel vajalik – Grafana või millegi muu kaudu.
A: – Nii et jutt on võrdsest võitlusest, mitte nende kiirete andmebaaside suurest eelisega?
AG: – Arvan, et kui integreerime, siis on täpsemad testid.
A: – Kus jäi vanamoodne RRD? Mis tõi kaasa ülemineku SQL-andmebaasidele? Alguses koguti kõik mõõdikud ju RRD-s.
AG: – "Zabbixis" oli RRD võibolla väga vanas versioonis. SQL-andmebaasid on alati olnud - klassikaline lähenemine. Klassikaline lähenemine on MySQL, PostgreSQL (need on juba väga kaua olemas). Meil on ühine kasutajaliides SQL-andmebaaside jaoks ja RRD-d oleme praktiliselt kunagi ei kasutanud.

Veidi reklaami 🙂
Aitäh, et olete meiega. Kas teile meeldivad meie artiklid? Kas soovite näha rohkem huvitavat sisu? Toetage meid, tellides teenuse või soovitades meid tuttavatele. , ainulaadne entry-level serverite analoog, mille oleme teie jaoks välja mõelnud: (saadaval RAID1 ja RAID10 variandid, kuni 24 tuuma ja kuni 40GB DDR4).
Dell R730xd on Equinixi Tier IV andmekeskuses Amsterdamis kaks korda odavam? Ainult meie juures Hollandis! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — alates $99! Lugege sellest
Allikas: habr.com
