

Oleme välja töötanud and keskusete võrgu kujunduse, mis võimaldab rakendada arvutusklastreid, mille suurus ületab 100 000 serverit ja mille piiksuliin (bisection bandwidth) ületab ühe petabaiti sekundis.
Dmitri Afanasevi ettekandest saad teada uue disaini põhialustest, selle topoloogiate skaleerimisest, nende probleemidest ja lahendusvariantidest, suunamisfunktsioonide ning kaasaegsete võrguseadmete forwarding plane skaleerimise omadustest tihedalt ühendatud (densely connected) topoloogiates, kus esineb palju ECMP marsruute. Lisaks rääkis Dima lühidalt välise ühenduse, füüsilise tasandi, kaabelduse süsteemi ja mahtuvuse edasise suurendamise viisidest.
— Tere päevast kõigile! Minu nimi on Dmitri Afanasev, olen Yandexi võrgu arhitekt ja tegelen peamiselt and keskusete võrgu kujundamisega.
Minu ettekande teema on Yandexi uuendatud and keskusete võrk. See on suuresti evolutsioon meie seni olnud disainist, kuid samas on ka mõned uued elemendid. See on ülevaatlik esitlus, kuna pidime kokku panema palju teavet lühikesse aega. Alustame loogilise topoloogia valikust. Järgnevalt vaatame control plane'i ja data plane'i skaleerimisprobleeme ning valime, mis juhtub füüsilisel tasandil, tutvume mõnede seadmete omadustega. Veidi puudutame ka and keskusel toimuvat MPLS-i, millest me rääkisime mõni aeg tagasi.
Nii et mis on Yandex koormuste ja teenuste vaatenurgast? Yandex on tüüpiline hüper-skaalija. Kui vaadata kasutajate poole, toimub meil peamiselt kasutajate päringute töötlemine. Samuti on meil erinevad kordusvoogude teenused ja andmete edastamine, kuna meil on ka salvestusteenused. Kui liikuda lähemale taustale, siis ilmnevad seal infrastruktuuri koormused ja teenused, näiteks jaotatud objekti salvestamisruumid, andmete replikatsioon ja loomulikult püsivad järjekorrad. Üks peamisi koormatüüpe on MapReduce ja sarnased süsteemid, voogedastus, masinõpe jne.
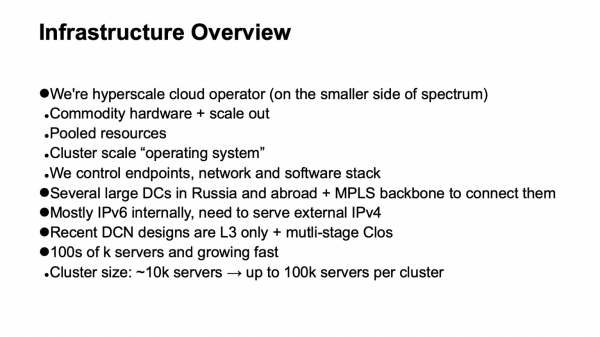
Kuidas on üles ehitatud infrastruktuur, millel kõik see toimub? Me oleme üsna tüüpiline hüperkerija, ehkki võime-olla oleme veidi lähemal sellele spektri poole, kus on väiksemad hüperkerijad. Kuid meil on kõik atribuudid. Me kasutame tavalist riistvara ja horisontaalset skaleerimist igal pool, kus see on võimalik. Meil on täielikult olemas ressursside ühendumine: me ei tööta eraldi masinate, eraldi riiulitega, vaid ühendame nad suurde vahetatavate ressursside basseini koos lisateenustega, mis tegelevad planeerimise ja allokatsiooniga ning töötame kogu selle basseini kallal.
Nii tekib meil järgmine tase – arvutiklastri operatsioonisüsteem. On väga oluline, et me kontrollime täielikult kasutatavat tehnoloogia steki. Me kontrollime lõpppunkte (hoste), võrku ja tarkvarasteki.
Meil on mitmeid suuri andmekeskusi Venemaal ja välismaal. Need on ühendatud MPLS tehnoloogiat kasutava selgrooga. Meie sisemine infrastruktuur on praktiliselt täielikult üles ehitatud IPv6-le, aga kuna me peame teenindama väliseid andmeid, mis tulevad peamiselt IPv4 kaudu, peame leidma viisi, kuidas edastada IPv4 kaudu saabuvad päringud frontend-i.serverid, ja veidi käima veel välises IPv4 internetis - näiteks indekseerimise jaoks.
Viimased paar andmekeskuse võrgukujunduse iteratsiooni kasutavad mitmetasandilisi Clos-topoloogiaid ja neis rakendatakse ainult L3-d. Me oleme L2-st loobunud juba mõnda aega tagasi ja hingasime kergendatult. Lõpuks sisaldab meie infrastruktuur sadu tuhandeid arvutiseadmestikke (servereid). Klaster maksimaalse suurusega oli mõni aeg tagasi umbes 10 tuhat serverit. See on suures osas tingitud sellest, kuidas need klassi operatsioonisüsteemid, planeerijad, ressursside allokatsioon jne saavad töötada. Kuna infrastruktuuri tarkvara osas on toimunud edusamme, on nüüd eesmärk, et klastris oleks umbes 100 tuhat serverit, ja meil on tekkinud ülesanne - osata ehitada võrgutehaseid, mis võimaldavad tõhusalt ressursse sellises klastris ühendada.
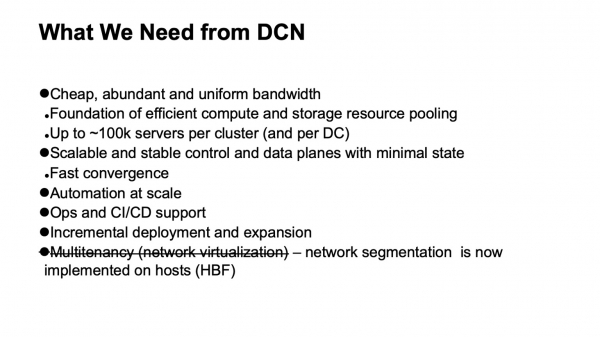
Mida me tahame andmekeskuse võrgust? Esiteks palju odavat ja piisavalt ühtlaselt jaotatud ribalaiust. Sest võrk on see aluspind, mille abil saame ressursse koondada. Uus sihtmoodustuse suurus on umbes 100 000 serverit ühes klastris.
Me soovime ka loomulikult skaleeritavat ja stabiilset juhtimisplaani, sest nii suurel infrastruktuuril tekib üsna palju peavalu isegi juhuslike sündmuste tõttu, ja me ei taha, et meile toob peavalu ka juhtimisplaan. Samal ajal tahame maksimeerida selle seisundit. Mida vähem on seisundit, seda paremini ja stabiilsemalt kõik töötab, seda lihtsam on diagnostika.
Loomulikult vajame automatiseerimist, sest sellise infrastruktuuri käsitsi haldamine on võimatu, ja see oli juba mõni aeg tagasi võimatu. Me vajame, kui võimalik, operatiivsete tegevuste tuge ja CI/CD toetust, nii palju kui see on võimalik.
Selle suuruse tõttu andmekeskustes ja klastrites on tekkinud äärmiselt terav vajadus toetada järkjärgulist arendamist ja laiendamist teenuse katkestamata. Kui tuhandete masinatega klastrite puhul, võib-olla, lähedal kümnes tuhande masina juurde, oli neid veel võimalik välja anda kui ühte operatsiooni — see tähendab, et me plaanime infrastruktuuri laiendamist ja mitu tuhat masinat lisatakse kui üks operatsioon, siis sadade tuhandete masinate klastri puhul ei teki see kohe, see ehitatakse teatud aja jooksul. Ja on soovitav, et kogu selle aja vältel oleks see, mis juba on välja antud, see infrastruktuur, mis on rakendatud, saadaval.
Ja üks nõue, mis meil oli ja kadus: see on multitenantsi toetamine, see tähendab virtualiseerimist või võrgu segmentimist. Nüüd ei pea me seda tegema võrgu tehase tasemel, sest segmentimine on läinud hostidele, ja see on meile oluliselt lihtsustanud skaleerimist. Tänu IPv6-le ja suurele aadressiruumile ei pidanud me sisemises infrastruktuuris kasutama dubleeritud aadresse, kogu aadressimine oli ja on unikaalne. Ja kuna me oleme võrgu filtreerimise ja segmentimise viinud hostidele, ei pea me looma mingisuguseid virtuaalseid võrguüksusi andmekeskuse võrkudesse.
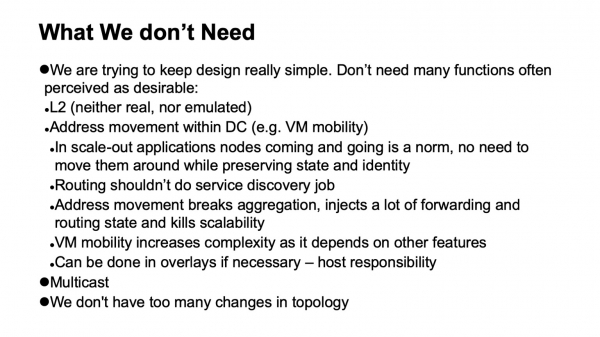
Eriti oluline asi on see, et meil ei ole vaja. Kui mõningaid funktsioone saab võrgust eemaldada, muudab see elu tunduvalt lihtsamaks ja tavaliselt suurendab see saadavalolevate seadmete ja tarkvara valikut, samuti lihtsustab see diagnoosi.
Nii et mis on see, millest me loobuda saame, millest me saime loobuda, mitte alati rõõmuga hetkel, kui see juhtus, kuid suurima kergendusega, kui protsess lõpetati?
Esiteks loobumine L2-st. Meile ei ole vajalik ei reaalne ega emuleeritud L2. Seda ei kasutata ulatuslikult, kuna me kontrollime rakenduste pilti. Meie rakendused skaleeruvad horisontaalselt, need töötavad L3 adresseerimisega, nad ei ole eriti mures selle üle, et mõni üksik instants kustub, lihtsalt lükatakse välja uus, mis ei pea liikuma vanal aadressil, kuna on olemas eraldi teenuse avastamise ja monitoring tasand, mis tegeleb klastri masinate jälgimisega. Me ei üleüldse ei delegeteeri seda ülesannet võrgule. Võrgu ülesanne on edastada pakette punktist A punkti B.
Samuti ei ole meil olukordi, kus aadresse tuleb võrgus liigutada ja seda jälgida. Paljudes disainides on see tavaliselt vajalik, et toetada VM-i mobiilsust. Me ei kasuta virtuaalmasinate mobiilsust Yandexi sisemises infrastruktuuris ja usume ka, et isegi kui see on vajalik, ei tohiks seda teha võrgutoe abil. Kui on hädasti vaja, tuleb seda teha hostide tasandil ja panna aadressid, mis võivad migreeruda, overlay-desse, et mitte puudutada ja mitte teha liiga palju dünaamilisi muudatusi marsruutimisprotsessis, nimelt underlay (transportvõrk).
Veel üks tehnoloogia, mida me ei kasuta, on multicast. Soovijatele võin rääkida, miks see on nii. See kergendab elu märkimisväärselt, kuna kui keegi on sellega kokku puutunud ja näinud, milline on multicast'i control plane — kõigis paigaldustes, välja arvatud lihtsaimad, on see suur peavalu. Veelgi enam, on raske leida hästi töötavat avatud rakendust, näiteks.
Ja lõpuks projekteerime meie võrgud nii, et neis ei toimuks liiga palju muudatusi. Saame loota, et väliste sündmuste voog marsruutimisüsteemis on väike.
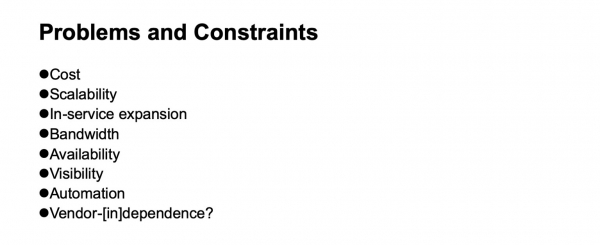
Millised probleemid ja piirangud tuleb arvestada, kui arendame andmekeskuse võrku? Muidugi hind. Skaleeritavus, kuni kui kaugele me soovime kasvada. Vajadus laiendada ilma teenuse katkestamiseta. Laitsmine, kättesaadavus. Nähtavus, mis toimub võrgus, süsteemide jälgimise jaoks, operatiivmeeskondade jaoks. Automatiseerimise tugi — jälle, niivõrd, kuivõrd see on võimalik, kuna erinevaid ülesandeid saab lahendada erinevatel tasanditel, sealhulgas täiendavate kihtide loomisega. Ja mitte-[võimalikult]-sõltumatus tarnijatest. Kuigi erinevate ajalooliste perioodide jooksul, sõltuvalt sellest, millise lõike võtame, on see sõltumatus olnud kergem või raskem saavutada. Kui võtame võrguseadmete kiipide lõike, siis seni on võimalik rääkida sõltumatusest tarnijatest, kui soovime ka kiipe, millel on suur läbilaskevõime, väga tinglikult.
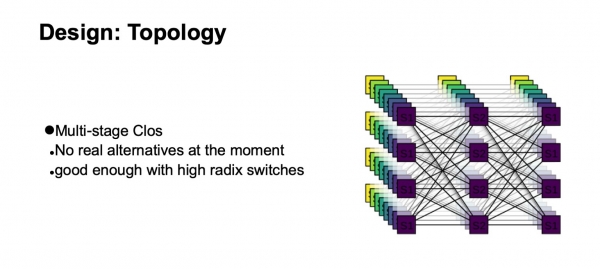
Millise loogilise topoloogia järgi me oma võrgu üles ehitame? See saab olema mitmetasandiline Clos. Tegelikult ei ole hetkel reaalseid alternatiive. Ja Clos-topoloogia on piisavalt hea, isegi kui võrrelda seda erinevate arenenud topoloogiatega, mis praegu rohkem akadeemilise huvi sfääri kuuluvad, kui meil on lülitid, millel on suur radiks.
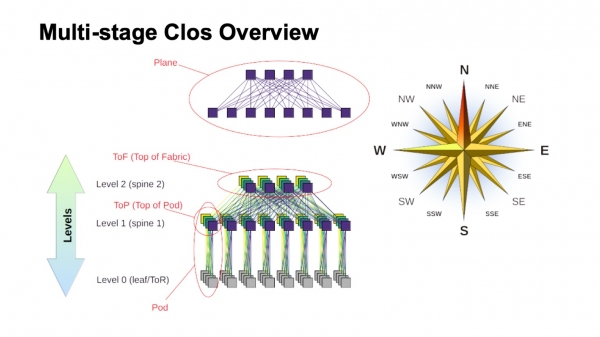
Kuidas on umbkaudu üles ehitatud mitmetasandiline Clos-võrk ja kuidas nimetatakse selles erinevaid elemente? Esiteks, tuulerose, et orienteeruda, kus on põhja, kus lõuna, kus ida, kus lääs. Selliseid võrke ehitavad tavaliselt need, kellel on väga suur läbilaskevõime läänest itta. Mis puutub teistesse elementidesse, siis ülal on kujutatud virtuaalset lülitit, mis on kokku pandud väiksematest lülititest. See on Clos-võrkude rekursiivse ehitamise põhieesmärk. Me võtame elemendid, millel on mingisugune radiks ja ühendame need nii, et see, mis saadakse, oleks võimalik vaadelda kui suurema radiksiga lülitit. Kui on veelgi rohkem vaja, saab protseduuri korrata.
Näiteks kaheastmeliste Closi puhul, kui komponente, mis mu skeemil on vertikaalsed, on selgelt eristatavad, tuntakse neid tasanditena. Kui me ehitaksime Clos-i kolme taseme spine-lülititega (kõik, mis ei ole äärmuslikud ega ToR-lülitid ja mida kasutatakse ainult transiidiks), näeks tasandite struktuur keerulisem välja, kaheastmelised näevad just niimoodi välja. ToR- või leaf-lülitite blokki ja sellega seotud esimese taseme spine-lüliteid nimetameme Pod-iks. Spine-lülitid tasemel spine-1 Pod-i ülaosas on top of Pod, Pod-i tipp. Lülitid, mis asuvad kogu tehase ülaosas, on tehase ülemine kiht, Top of fabric.
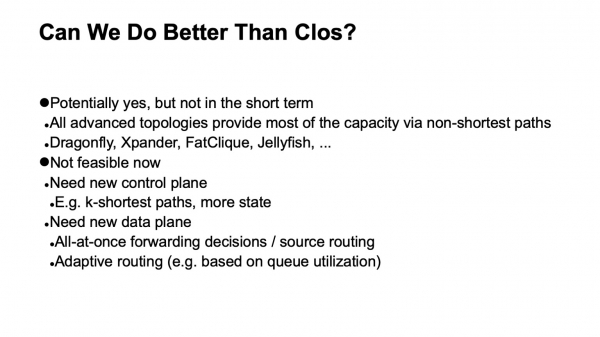
Küsimus on loomulikult: Clos-võrgud on juba mõnda aega ehitatud, idee ise on pärit klassikalise telefonitehnoloogia ja TDM-võrkude ajaloost. Kas on midagi paremat tekkinud, kas on võimalik midagi paremini teha? Jah ja ei. Teoreetiliselt jah, praktikaliselt lähitulevikus kindlasti mitte. Sest on olemas hulk huvitavaid topoloogiaid, millest mõned on isegi tootmises kasutusel, näiteks Dragonfly, mida kasutatakse HPC-rakendustes; samuti on huvitavaid topoloogiaid nagu Xpander, FatClique, Jellyfish. Kui vaadata ettekanne konverentsidelt nagu SIGCOMM või NSDI viimasel ajal, võib avastada üsna palju töid alternatiivsete topoloogiate kohta, mis omavad paremaid omadusi (üht- või teistmoodi) kui Clos.
Kuid kõigil neil topoloogiatel on üks huvitav omadus. See takistab nende rakendamist andmekeskuse võrkudes, mida me püüame ehitada tarbehardware’il ja mis maksavad piisavalt mõistlikult. Kõigis nendes alternatiivsetes topoloogiates on enamiku ribalaius, kahjuks, mitte lühemate teede kaudu kergesti kätte saadav. Seetõttu kaotame kohe võimaluse kasutada traditsioonilist control plane-i.
Teoreetiliselt on ülesande lahendamise meetod teada. Näiteks link staatuse modifikatsioonid, mis kasutavad k-lühemaid teid, kuid taas, ei ole selliseid protokolle, mis oleksid tootmises rakendatud ja massiliselt kergesti kättesaadavad varustuses.
Lisaks, kuna suurem osa mahust ei ole saadaval lühimate teede kaudu, peame modifitseerima mitte ainult juhtimistaset, et see valiks kõik need teed (ja muide, see on oluliselt suurem seisund juhtimistasemel). Peame samuti modifitseerima edastusplaani ning tavaliselt on vaja vähemalt kaht täiendavat funktsiooni. See on võimalus teha kõik edastusotsused korraga, näiteks hostis. Tegelikult on see source routing, mida mõnikord nimetatakse kirjanduses interconnection networks puhul all-at-once forwarding decisions. Ja veel adaptive routing — see on funktsioon, mida vajame meie võrkelementides, mis tähendab näiteks, et valime järgmise hüppe, lähtudes teabest kõige madalama järjekorra koormuse kohta. Näiteks on võimalikud muud variandid.
Nii et suund on huvitav, kuid kahjuks ei saa me seda praegu rakendada.
Okei, peatume loogilisel Clos-topoloogial. Kuidas me seda skaleerime? Vaatame, kuidas see on korraldatud ja mida saame teha.
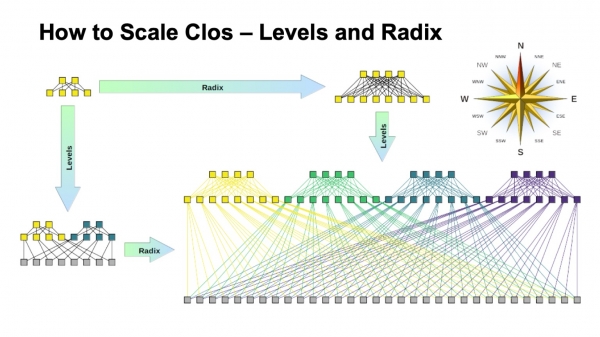
Clos-võrgus on kaks peamist parameetrit, mille abil saame tulemusi varieerida: elementide radix ja korralduse taseme arv. Mul on skeemiliselt kujutatud, kuidas mõlemad mõjutavad suurust. Ideaalis kombineerime mõlemad.
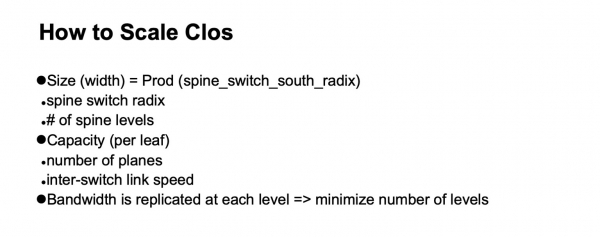
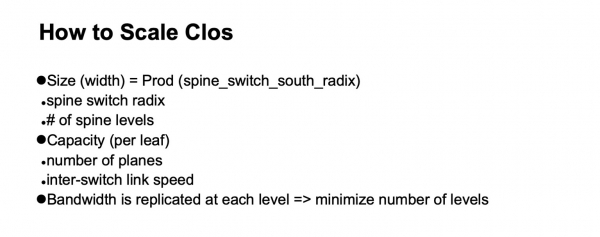
On näha, et Clos-võrgu lõplik laius on lõunapoolsete spainlülitite radiksi kõikide tasemete korrutis, see, kui palju linke meil allapoole on ja kuidas see hargneb. Nii me skaleerime võrgu suurust.
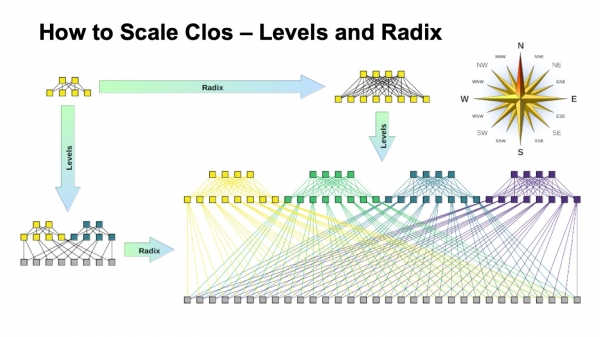
Mis puudutab mahtu, eriti ToR-lülitites, on siin kaks skaleerimisvõimalust. Võime kas säilitada üldise topoloogia, kasutades suurema kiiruslülitusi, või saame lisada rohkem tasandeid.
Kui vaadata avatud Clos-võrgu versiooni (all paremas nurgas) ja naasta selle Clos-võrgu pildi juurde all…
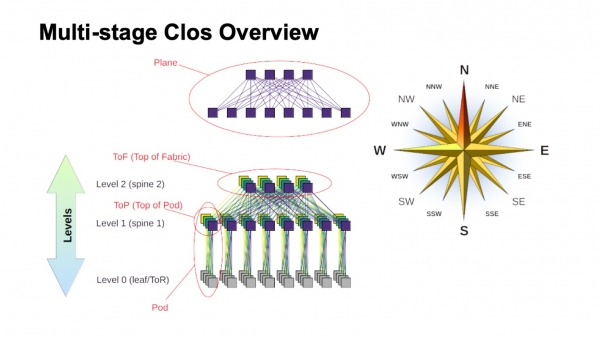
... on see täpselt sama topoloogia, kuid sellel slaidil on see kokkusurutud kompaktselt ja tehasetasandid on üksteise peale asetatud. See on sama asi.
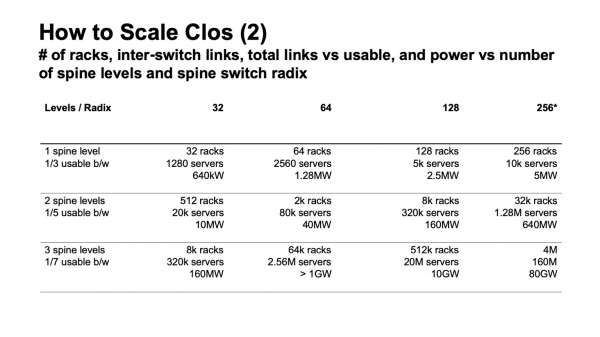
Kuidas näeb välja Clos-võrgu skaleerimine numbrites? Siin on mul andmed selle kohta, kui lai võib võrgu maksimaalselt olla, kui palju seadmeid, ToR-lüliteid või leaf-lüliteid, kui nad ei asu kappidest, saame vastavalt sellel, milline on meie spine-tasandite jaoks kasutatavate seadmete radiks ja kui palju tasandeid me kasutame.
Siin on toodud, kui palju meil võib olla serveririiuleid, palju servereid ja ligikaudu kui palju see kõik võiks tarbida, arvestades 20 kW riiuli kohta. Natuke varem mainisin, et meie siht on 100 000 serveri suurune klaster.
On näha, et kogu selles konstruktsioonis on huvitavad kaks ja pool varianti. On variandid kahe kihiga spine-switch'ide ja 64-portiliste switch'idega, mis jääb pisut alla oodatule. Siis on fantastiliselt sobivad variandid 128-portiliste (radix 128) spine-switch'ide jaoks kahe kihiga või radix 32 switch'id kolme kihiga. Ja igal juhul, kus on kõrgem radix ja rohkem kihte, on võimalik luua väga suur võrk, kuid kui vaadata oodatavat tarbimist, on seal tavaliselt gigavattide jagu. Kaabli saab paigaldada, kuid nii palju elektrit ühel alal on tõenäoliselt keeruline saada. Kui vaadata statistikat, on andmed andmekeskuste kohta väga vähe andmekeskusi, mille hinnanguline võimsus ületab 150 MW. Suuremad on tavaliselt andmekeskuste kompleksid, kus on mitu suurt andmekeskust, mis asuvad üksteisele üsna lähedal.
On veel üks oluline parameeter. Kui vaatate vasakut sammust, on seal toodud kasutatav ribalaius. Pole raske märgata, et Clos-võrgus märkimisväärne osa porte läheb lülitite omavaheliseks ühendamiseks. Kasutatav ribalaius, see, mis saab välja anda suunas serverite poole, on see, mida me saame jagada. Loomulikult räägin ma tinglikest portidest ja just ribalaiusest. Üldiselt on võrgus sisesed lingid kiirem, kui lingid serverite suunas, kuid igale ribalaiusele, mida saame meie serverivarustuse suunas anda, kulub veel osa ribalaiusest, mis jääb võrgus endas. Mida rohkem tasandeid me teeme, seda suuremad on erakulud, et see ribalaius välja anda.
Lisaks sellele, isegi see lisaribalaus ei ole täiesti ühtlane. Seni, kuni vahemaad on lühikesed, saame kasutada midagi DAC (direct attach copper, st twinax-kaablid) või multimode optikat, mis maksab veel enam-vähem mõistlikke hindasid. Kui me liigume pikemate vahemaade juurde — tavaliselt on see single mode optika ja selle lisaribalae hind tõuseb märgatavalt.
Ja taas, kui me pöördume tagasi eelmiseks slaidiks, siis kui me teeme Clos-võrgu ilma ümberregistreerimiseta, siis on lihtne vaadata skeemi, vaadata, kuidas võrk üles ehitatakse — iga spaina-lüliti taseme lisamisega kordame kogu seda ribad, mis oli all. Pluss tase — pluss kõik need samad ribad, veel sama palju, kui oli eelmisel tasemel, porte lülitites, veel sama palju ülemikuid. Seetõttu on soovitav minimaalselt vähendada spine-lülitite arvu.
Selle pildi põhjal on näha, et me tahaksime ehitada midagi, mis sarnaneb 128-radix lülititega.
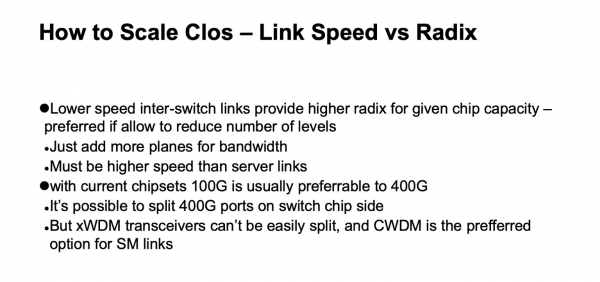
Siin on põhimõtteliselt kõik sama, mida ma praegu rääkisin, see slaid on pigem hilisemaks arutamiseks.
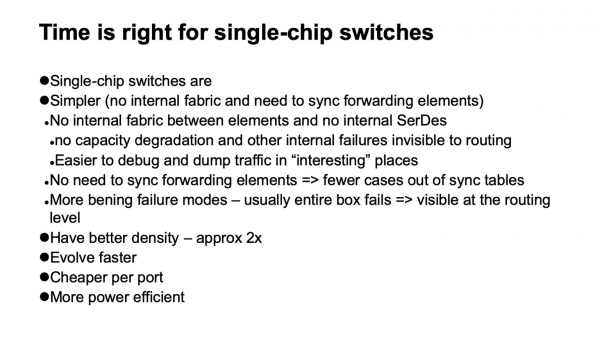
Millised valikud meil on, mida me saame selliste lülitite valimiseks valida? Meie jaoks on väga meeldiv uudis, et nüüd on lõpuks võimalik selliseid võrke ehitada ühekiibiliste lülitite põhjal. Ja see on väga tore, neil on palju meeldivaid omadusi. Näiteks on neil peaaegu puudulik sisemine struktuur. See tähendab, et nad on lihtsamad purunema. Nad purunevad, kus ilma selleta, kuid õnneks purunevad nad täielikult. Moodulise seadmega on palju erinevaid rikkeid (väga ebameeldivad), kui külgne pursue ja control plane tundub töötavat, kuid näiteks on osad tehasest kadunud, ja see töötab mitte täisvõimsusel. Ja liiklus tasakaalustatakse selle põhjal, et see on täiesti funktsionaalne, ning me võime saada ülekoormuse.
Või näiteks tekivad probleemid backplane'iga, kuna ka moodulise seadme sees on kõrge kiirus SerDes'id — see on tõeliselt keeruline seestpoolt. Või sünkroniseeritakse või ei sünkroniseerita tabelid edastamise elementide vahel. Ühesõnaga, ükskõik milline tootlik mooduliseer võrgu seade, mis koosneb suurest hulgast elementidest, sisaldab endas reeglina seda sama Clos-võrku, mida on aga väga raske diagnoosida. Sageli on isegi tootjale endale keeruline diagnoosida.
Ja sellel on palju vigu, mille korral seade degradeerub, kuid ei kao täielikult topoloogiast. Kuna meil on suur võrk, kasutatakse aktiivselt tasakaalustamist identsete elementide vahel, ning võrk on väga regulaarne, mis tähendab, et üks tee, kus kõik toimib, ei erine kuidagi teisest teest. Seetõttu on meile kasulikum kaotada lihtsalt osa seadmeid topoloogiast, kui sattuda olukorda, kus mõned neist näiliselt töötavad, kuid tegelikult ei tööta.
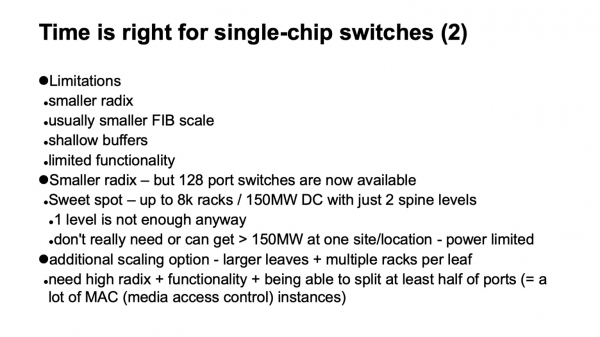
Järgmine meeldiv omadus üheskiibiga seadmetel on see, et need arenevad paremini ja kiiremini. Samuti on neil tavaliselt parem mahutavus. Kui võtta suuremad koostatud konstruktsioonid, mis meil on, siis mahutavus rackiühiku kohta sama kiirusel on peaaegu kaks korda parem, kui moodulitega seadmetel. Üheskiibiga seadmed on märgatavalt odavamad kui moodulid ja tarbivad vähem energiat.
Aga loomulikult pole see kõik ilma probleemideta, on ka miinuseid. Esiteks on tavaliselt väiksem radiks kui moodulitel. Kui me saame üheskiibilise seadme, mis on ehitatud 128 pordi jaoks, siis moodulise seadme puhul saame nüüd ilma eriliste probleemideta mitu sada porti.
See tähendab märgatavalt väiksemat edastuslahenduste ja tavaliselt kõik, mis puudutab andmeplaadi skaleeritavust. Madalad vahemälud. Ja tavaliselt üsna piiratud funktsionaalsus. Kuid selgub, et kui teada neid piiranguid ja õigeaegselt hoolitseda nende ületamise või lihtsalt silmas pidamise eest, ei ole see nii hirmutav. Radiks, mis on väiksem, ei ole uute seadmete puhul, mille radiks on 128, enam probleem, saame ehitada kahte rihma kihti. Ja väiksema kui kahe taseme korral ei saa me ikka midagi huvitavat meie suuruses ehitada. Ühe tasemega tekivad väga väikesed klastrid. Isegi meie eelnevad kujundused ja nõuded ületasid neid endiselt.
Tegelikult, kui lahendus on kuskil piiri peal, on veel üks võimalus skaleerimiseks. Kuna viimane (või esimene) madalaim tase, kuhu serverid ühendatakse, on ToR-lülitid või leaf-lülitid, ei pea me neid ühendama ühe serveririiuliga. Seetõttu, kui lahendus jääb kuskil kaks korda alla, võiks mõelda, et kasutada lihtsalt lülitit, millel on madalamal tasemel suurem radiks ja ühendada, näiteks, kaks-kolm riiulit ühe lülitiga. See on samuti variant, millel on oma kulud, kuid see töötab hästi ja võib osutuda heaks lahenduseks, kui on vaja suurendada kuskil kaks korda suurust.
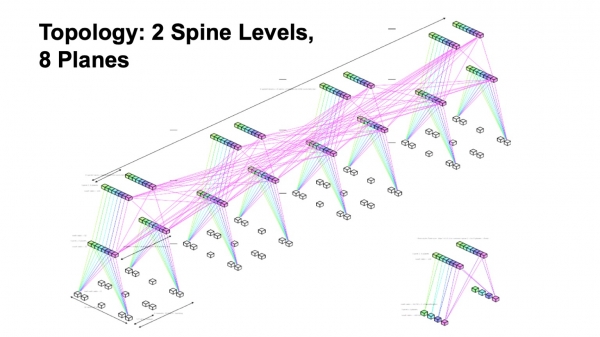
Kokkuvõttes ehitame kahe tasandi spinerite topoloogiaga, koos kaheksakihilise tehasega.
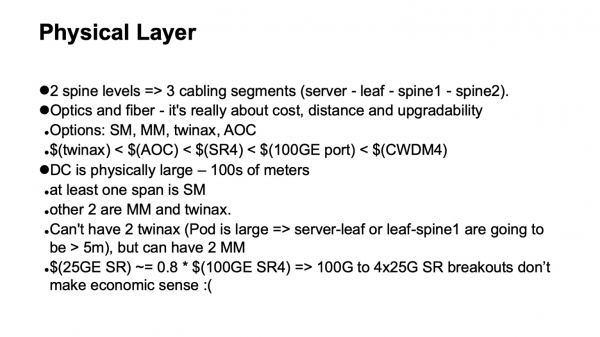
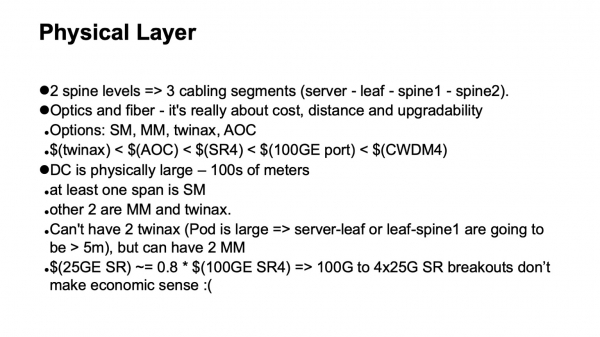
Mis saab füüsikast? Väga lihtsad arvutused. Kui meil on kaks tasandit spinereid, siis on meil kokku kolm tasandit lüliteid ning me ootame, et võrku tuleb kolm kaablisegmenti: serveritest leaf-lülititesse, spiin 1 ja spiin 2. Kasutatavad variandid on twinax, multimode, single mode. Siin tuleb arvestada, milline ribalaius on saadaval, kui palju see maksab, millised on füüsilised mõõdud, millised kaugused me saame katta ning kuidas me uuendame.
Hinnas on kõik võimalik ritta seada. Twinaxid maksavad märgatavalt vähem kui aktiivne optika, odavamad kui multimode'i edastajad, kui lähtuda kaugusest, ja pisut odavamad kui 100-gigabittine lüliti port. Ja tähelepanu, see maksab vähem kui single mode optika, sest kohtades, kus on vaja single mode'i, on andmekeskustes mitmel põhjusel mõistlik kasutada CWDM-i ning paralleelse single mode'iga (PSM) töötamine pole eriti mugav, tekivad väga suured kiudude pakid ning kui jääda nende tehnoloogiate juurde, on hindade hierarhia umbes selline.
Veel üks märkuse: kahjuks ei tööta 100 4x25 multimode'i portide拆解 kasutamine hästi. SFP28 edastajate konstruktsiooni eripära tõttu on see mitte palju odavam kui 100 Gbit QSFP28. Ja selle拆解 multimode'i jaoks ei tööta eriti hästi.
Üks piirang on see, et meie andmekeskused on füüsiliselt suured serverite arvu ja arvutuste klastrite suuruse tõttu. See tähendab, et vähemalt üks vahe peab olema ühe moodiga. Jällegi, Pods'i füüsilise suuruse tõttu ei saa kahta vahet läbi twinax-kaablite teha.
Kui optimeerida hinna kohaselt ja arvestades selle konstruktsiooni geomeetriat, saame ühe twinax vahe, ühe multimood vahe ja ühe ühemoode vahe kasutades CWDM-i. See arvestab võimalikke uuenduste teid.
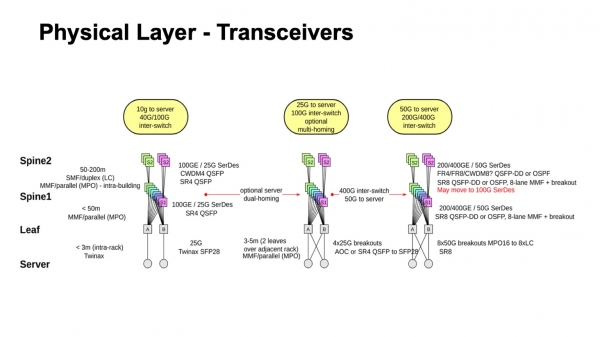
Umbes nii näeb välja see, mis oli hiljuti, kuhu me suundume ja mis on võimalik. On selge, et vähemalt on suund 50-gigabitiste SerDes-ide poole, nii multimoodile kui ka ühemoodele. Veelgi enam, kui vaadata, mis on praegu ühemoode transiivide maailmas ja tulevikus 400G puhul, siis sageli kui tulevad 50G SerDesid elektrilise poolelt, siis optilisse võivad juba minna 100 Gbps ribal. Seega on täiesti võimalik, et 50-le ülemineku asemel toimub üleminek 100-gigabitistele SerDes-idele ja 100 Gbps ribal, sest paljude müüjate sõnul oodatakse nende saadavust üsna pea. Aeg, mil 50G SerDes olid kõige kiirem, tundub, et ei jää kauaks, sest 100G SerDes-i esimesed mudelid on peagi tulemas.
Veel üks nüanss füüsika valiku osas. Põhimõtteliselt saame juba praegu kasutada 400- või 200-gigabitisi porte 50G SerDes-ide abil. Kuid selgub, et selles pole erilist mõtet, sest nagu ma varem rääkisin, tahame me lülitites piisavalt suurt radikast, loomulikult mõistlikus ulatuses. Me soovime 128. Ja kui meie kiibi maht on piiratud ja me suurendame linki kiirus, siis radikas loomulikult väheneb.
Kuid me saame üldist mahtu suurendada tasapindade arvu kaudu, ja sellega pole erilisi kulusid, saab lisada tasapindade arvu. Ja kui me kaotame radika, tuleb lisada täiendav tase. Seega, praeguste arvutuste tõttu, praeguse maksimaalse kergesti kätte saadava mahu ühe kiibi kohta, selgub, et tõhusam on kasutada 100-gigabitisi porte, sest need võimaldavad saavutada suuremat radikat.
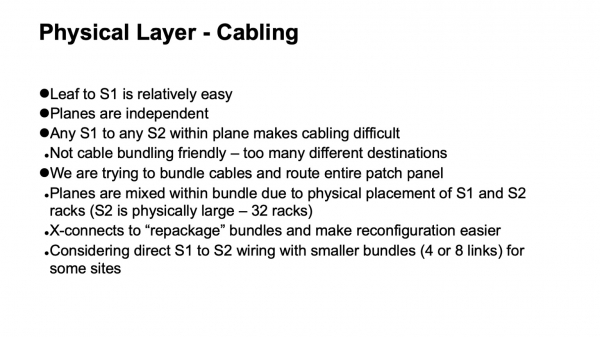
Järgmine küsimus on, kuidas on korraldatud füüsika, kuid juba kaabelinfrastuktuuri vaatenurgast. Selgub, et see on korraldatud üsna lõbusalt. Kaablite ühendamine leaf-lülitite ja esimese taseme spine'ide vahel pole nii palju linke, seal on kõik suhteliselt lihtne. Kuid kui me vaatame ühte taset, siissee, mis toimub sees, tuleb kõiki esimese taseme spine'e ühendada kõigi teise taseme spine'idega.
Pluss, tavaliselt on teatud soovid selle kohta, kuidas see peaks välja nägema andmekeskuses. Näiteks soovisime väga kaablid bundeldada ja tõmmata neid nii, et üks kõrge tihedusega patch-paneel läheks täielikult ühte patch-paneeli, et ei tekiks pikkuste zood. Meil õnnestus see probleem lahendada. Kui algselt vaadata loogilist topoloogiat, siis on näha, et tasemed on iseseisvad, iga taset saab ehitada eraldi. But kui me lisame sellise bundeldamise ja tahame tõmmata täieliku patch-paneeli ühte patch-paneeli, siis tuleb ühe bundli sees segada erinevaid tasemeid ja tutvustada vaheüksust optiliste ristühendustega, et pakkida need ümber selliselt, nagu nad olid kogutud ühes segmendis, selliselt, nagu nad kogutakse teises segmendis. Selle tõttu saame meeldiva omaduse: kogu keeruline kommuteerimine ei lähe rack'ide piiridest välja. Kui on vaja midagi väga tugevalt punuda, "tasa tasemed ümber pöörata", nagu neid mõnikord Clos-võrkudes nimetatakse, on see kõik keskendunud ühte racki. Meil ei ole tugevalt lahti võetud, kuni individuaalsete linkideni, kommuteerimisi rack'ide vahel.
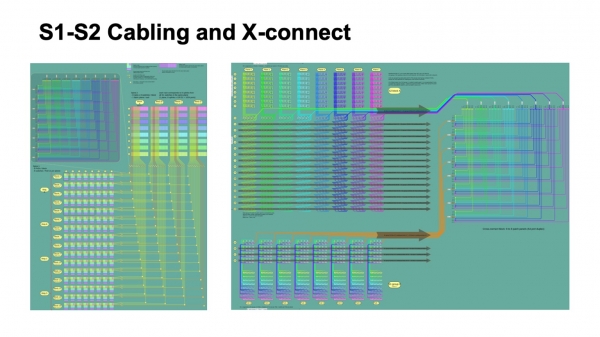
Nii see välja näeb kaabelinfrastuktuuri loogilise korralduse vaatenurgast. Pildil vasakul tähistavad erinevat värvi plokid esimese taseme spine-lülitite plokke, neid on kaheksa, ja nendest lähtuvad neli kaablite bundli, mis lähevad ja ristuvad bundlitega, mis tulevad spine-2 lülitite plokkidelt.
Väikesed ruudud tähistavad ristumiskohti. Üleval vasakul on iga sellise ristumiskoha skeem, mis on tegelikult 512x512 sadamatega ristühenduse moodul, mis pakib kaablid nii, et need jõuavad täielikult ühte kapisse, kus on ainult üks spine-2 tasand. Paremal on selle pildi skeem, mis on pisut detailsem seoses mitme Pods'iga spine-1 tasemel ja kuidas see pakitakse ristühenduses ning kuidas see jõuab spine-2 tasemele.
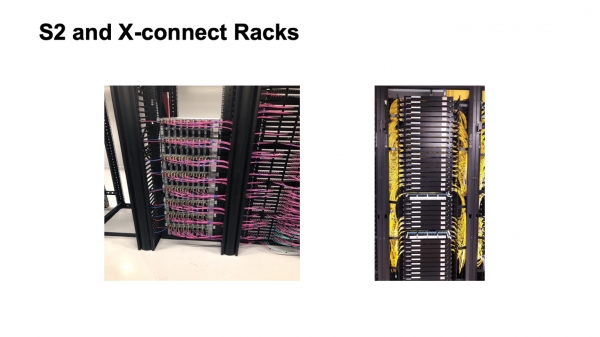
Nii see välja näeb. Mitte täielikult kokku pandud spine-2 kapp (vasakul) ja ristühenduse kapp. Kahjuks ei ole seal väga palju nähtaval. Kogu see konstruktsioon paisatakse praegu ühe meie suurima andmekeskuse juurde, mis laiendab oma ala. See on protsess, mis on pooleli, see näeb välja kaunim ja täidetakse paremini.
Oluline küsimus: valiti loogiline topoloogia, ehitati füüsika. Mis saab control plane'ist? Kasutuskogemusest on hästi teada, et on mõned esitlused, et link state protokollid on head, nendega on meeldiv töötada, kuid kahjuks ei skaala need tihedalt seotud topoloogias hästi. Ja on üks peamine tegur, mis sellele takistuseks saab — see, kuidas flooding link state protokollides töötab. Kui võtta flooding algoritm ja vaadata, kuidas meie võrk on üles ehitatud, siis on iga sammu juures väga suur fanout ja see üle ujutab control plane'i uuendustega. Konkreetsetes topoloogiates ja traditsioonilise flooding algoritmiga link state protokollides seguneb see väga halvasti.
Valik — kasutada BGP-d. Kuidas seda õigesti ette valmistada, on kirjas RFC 7938-s BGP kasutamise kohta suurtes andmekeskustes. Põhiideed on lihtsad: minimaalne eelliste arv hostil ja üldiselt minimaalne eelliste arv võrgus, kasutada agregatsiooni, kui see on võimalik, ja summutada path hunting. Soovime väga hoolikat, väga kontrollitud uuenduste levikut, seda, mida nimetatakse valley free. Tahame, et uuendused, liikudes mööda võrgustikku, leviksid täpselt üks kord. Kui need pärinevad alt, liiguvad nad üles, levinevad mitte rohkem kui üks kord. Ei tohi olla zigs- ja zags-mustreid. Zigzagid on väga halvad.
Selleks kasutame piisavalt lihtsat skeemi, et rakendada BGP põhimehhanisme. See tähendab, et meil on kasutusel eBGP, mis töötab link local, ja autonoomsed süsteemid on määratud järgmiselt: autonoomne süsteem ToR-l, autonoomne süsteem kogu spain-1-lülitite ploki jaoks ühe Pod-i sees ja üldine autonoomne süsteem kogu Top of Fabrici jaoks. Pole raske vaadata ja veenduda, et isegi BGP normaalne käitumine annab meile selle uuenduste leviku, mida me soovime.
Loomulikult tuleb projekteerida adresseerimine ja aadresside agregatsioon nii, et see oleks kooskõlas marsruutimise ülesehitusega, et tagada control plane stabiilsus. L3 adresseerimine transportimise ajal on seotud topoloogiaga, sest ilma selleta ei saavutata agregatsiooni, ilma selleta üksteised aadressid pääsevad marsruutimisüsteemi. Ja veel üks asi — agregatsioon, paraku, ei segune väga hästi multi-path'iga, sest kui meil on multi-path ja agregatsioon, on kõik hästi, kui kogu võrk töötab, kus ei ole tõrkeid. Paraku, kui võrku ilmuvad tõrked ja topoloogia sümmeetria kaob, võime sattuda punkti, kus aggregaat, millest anunseeritud on, ei ole edasi liikuda sinna, kuhu me tahame. Seetõttu on parem agregatsioon teostada seal, kus edasi ei ole multi-path, meie puhul ToR-lülitites.
Tegelikult on agregatsiooni teostamine võimalik, kuid ettevaatlikult. Kui suudame luua kontrollitud de-agregatsiooni võrgu tõrgete ilmnemisel. Kuid see on piisavalt keeruline ülesanne, oleme isegi arvutanud, kas see on teostatav, kas on võimalik lisada lisamehhanisme, ja lõppautomaatide süsteem, mis tõukab BGP-d õigesse käitumisse. Kahjuks on nurgajuhtumite käsitlemine väga ebaselge ja keeruline, ning BGP-le väliste lisade seadistamine ei lahenda seda probleemi hästi.
Selles osas on RIFT protokolli raames väga huvitav töö tehtud, millest räägitakse järgmises ettekandes.
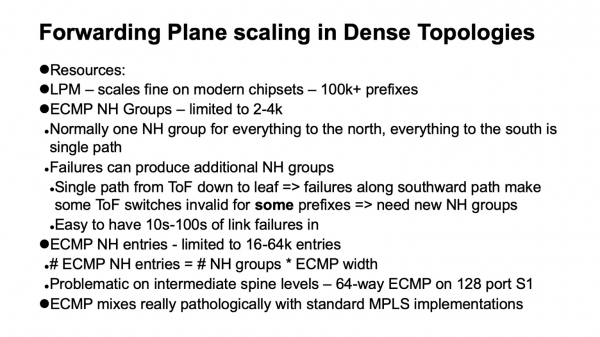
Veel üks oluline asi on see, kuidas andmeplaanid skaleeruvad tihedate topoloogiate korral, kus on palju alternatiivseid teid. Selleks kasutatakse mitmeid täiendavaid andmestruktuure: ECMP rühmad, mis omakorda kirjeldavad Next Hop rühmad.
Tavaliselt toimivas võrgus, ilma tõrgeteta, kui liigume ülespoole Clos-topoloogias, on piisav kasutada ainult ühte gruppi, kuna kõik, mis ei ole lokaalne, kirjeldatakse vaikimisi, võime liikuda üles. Kui liigume ülemiselt allapoole lõuna suunas, siis kõik teed ei ole ECMP, need on ühe tee teed. Kõik on hästi. Probleem on aga see, ja Clos-topoloogia klassikaline eripära on see, et kui vaatame Top of fabric, on igal elemendil, mis asub all, üks tee. Kui selle tee mööda toimuvad tõrked, siis see konkreetne element ülemises osas muutub kehtetuks just nende prefiksite jaoks, mis asuvad katki minnes. Kuid teiste jaoks on see kehtiv ja meid on sunnitud purustama ECMP gruppe ja tutvustama uut olekut.
Kuidas näeb välja andmeplaadi skaleeritavus tänapäevastes seadmetes? Kui teeme LPM (pikima prefiksi vaste), siis on kõik piisavalt hästi, üle 100 tuhande prefiksi. Kui räägime Next Hop gruppidest, siis on olukord halvem, 2-4 tuhat. Kui räägime tabelist, mis sisaldab Next Hops (või adjacencies) kirjeldust, siis see on kuskil 16k kuni 64k. Ja see võib muutuda probleemiks. Ja siin jõuame huvitava kõrvalepõikeni: mis juhtus MPLS-iga andmekeskustes? Põhimõtteliselt soovisime seda rakendada.
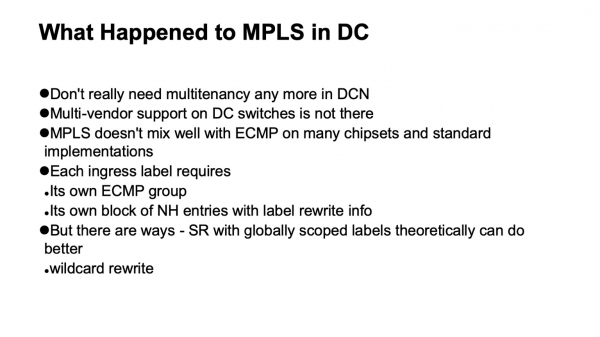
Juhtus kaks asja. Me rakendasime mikrosegmentatsiooni hostides, seega ei olnud meil vaja seda teha võrgus. Erinevate tootjate toetusega polnud kõik väga head, veel vähem avatud rakendustega valgetes kastides, mis kasutavad MPLS-i. Lisaks on MPLS, vähemalt selle traditsioonilised rakendused, kahjuks väga halvasti ECMP-ga ühtlustatud. Ja see on põhjus.
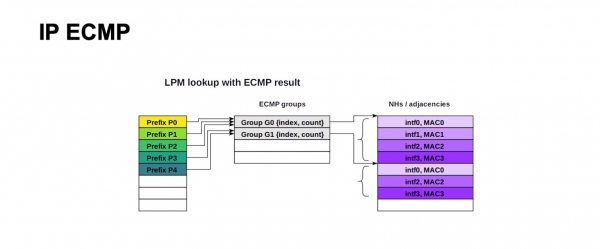
N niimoodi näeb välja ECMP edastamise struktuur IP jaoks. Suur hulk prefikseid võib kasutada ühte ja sama gruppi ning sama Next Hops bloki (või adjacencies, erinevates dokumentatsioonides võivad need erinevalt nimetada). Idee on selles, et seda kirjeldatakse kui väljundporti ja sellele, kuidas MAC-aadressi ümber kirjutada, et jõuda õige Next Hop'i juurde. IP jaoks on kõik lihtne, saab kasutada väga suurt hulka prefikseid sama grupi, sama Next Hops ploki peal.
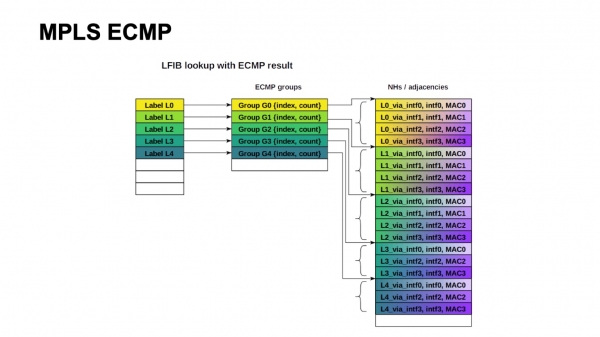
Klassikaline MPLSi arhitektuur eeldab — sõltuvalt väljundliidest, võib silt ümber kirjutada erinevatele väärtustele. Seetõttu peame hoidma igas grupis ja iga Next Hops bloki jaoks iga sisendmärgi kohta. Ja see, kahjuks, ei skaleeru.
Ei ole raske näha, et meie konstruktsioonis vajasime umbes 4000 ToR-lülitit, maksimaalne laius – 64 teed ECMP-le, kui liikuda spina-1-st spina-2 suunas. Me vaevu mahume ühte ECMP-gruppide tabelisse, kui ainult üks prefiks ToR-ist lahkub, ja ei mahtu üldse Next Hopide tabelisse.
Kõik ei ole lootusetu, kuna Segment Routing tüüpi arhitektuurid eeldavad globaalseid silte. Formaalselt võiks kõik need Next Hopide plokid taas koondada. Selleks on vajalik operatsioon tüüpi wild card: võtta silt ja kirjutada sama silt ilma konkreetse väärtuseta. Kuid kahjuks ei ole see saadaval olevates rakendustes kuigi hästi esindatud.
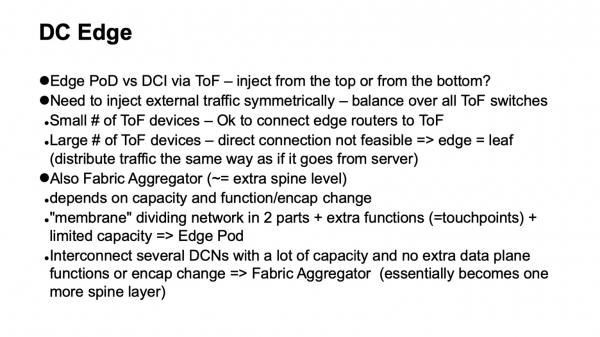
Ja lõpuks, peame tooma andmekeskusesse välise liikluse. Kuidas seda teha? Varem viidi liiklus Clos-võrku ülevalt. See tähendab, et olid piiratud marsruuterid, mis ühendasid kõik seadmed Top of fabric-iga. See lahendus töötab üsna hästi väikestes ja keskmise suurusega seadmetes. Kahjuks, et viia liiklust selliselt sümmeetriliselt kogu võrku, tuleb jõuda korraga kõikidele Top of fabric elementidele, ja kui neid on rohkem kui sada, selgub, et vajame suuri radikaale ka piiratud marsruuterites. Üldiselt maksab see raha, kuna piiratud marsruuterid on funktsionaalsemad, nende portide hind on kõrgem ja see osutub mitte just ilusaks konstruktsiooniks.
Teine variant on tuua sellist liiklust alt. Ei ole raske veenduda, et Clos-topoloogia on üles ehitatud nii, et alt tulev liiklus, st ToR-ilt, jaguneb ühtlaselt tasemete vahel kogu Top of fabrici ulatuses kahe iteratsiooni jooksul, laadides kogu võrku. Seetõttu tutvustame spetsiaalset tüüpi Pod-i, Edge Pod-i, mis tagab välist ühenduvust.
On veel võimalusi. Näiteks teeb nii Facebook, kellel on see tuntud kui Fabric Aggregator või HGRID. Lisatakse täiendav spinaal, et ühendada mitu andmekeskust. Selline struktuur on võimalik, kui meil pole liidestes täiendavaid funktsioone või kapseldumise muutusi. Kui need on olemas, siis on need täiendavad touch points, mis teeb asja keeruliseks. Üldiselt tekib rohkem funktsioone ja mingisugune membraan, mis eraldab erinevaid andmekeskuse osi. Suurt membraani pole vaja teha, aga kui see on mingil põhjusel väga vajalik, on mõistlik kaaluda selle üleviimist, teha see võimalikult laiek ja viia hostidesse. Niimoodi toimivad näiteks paljud pilveteenuse operaatorid, kellel on overlay-d, mis algavad hostidest.
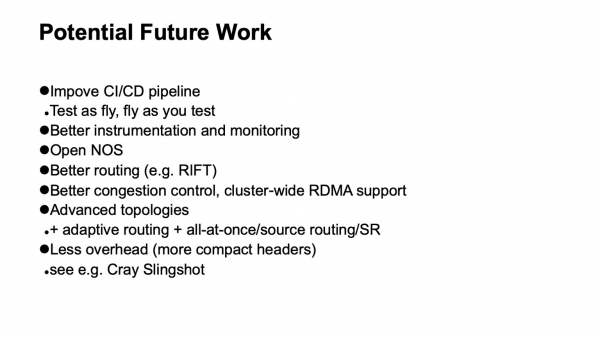
Milliseid arengu võimalusi me näeme? Esiteks — CI/CD torustiku toe parandamine. Me soovime lennata nii, nagu me testime, ja testida nii, nagu me lendame. See ei õnnestu väga hästi, kuna infrastruktuur on suur ja selle kopeerimine testimiseks on võimatu. Tuleb mõista, kuidas tuua testimise elemendid tootmisinfrastruktuuri, samal ajal seda kokku kukkumata.
Parim instrumentatsioon, parim jälgimine ei ole peaaegu kunagi liig. Kogu küsimus on pingutuste ja tasu tasakaalus. Kui mõistlike jõududega on võimalik midagi juurde lisada — on see suurepärane.
Avaoperatsioonisüsteemid võrgu seadmete jaoks. Parimad protokollid ja parimad marsruutimisüsteemid, nagu RIFT. Samuti on vajalikud uuringud parimate ummistuse kontrollimise skeemide rakendamise kohta ja võib-olla RDMA toe sisselaskmine vähemalt mõnes punktis klastrite piires.
Kui vaadata kaugema tuleviku poole, on vajalikud täiustatud topoloogiad ja võib-olla võrgud, mis kasutavad väiksemat overhead'i. Uudsetest asjadest — hiljuti ilmusid publikatsioonid HPC Cray Slingshot tehnoloogia kohta, mis põhineb odaval Ethernetil, kuid millel on võimalus kasutada palju lühemaid pealkirju. Tulemuseks on overhead'i vähenemine.
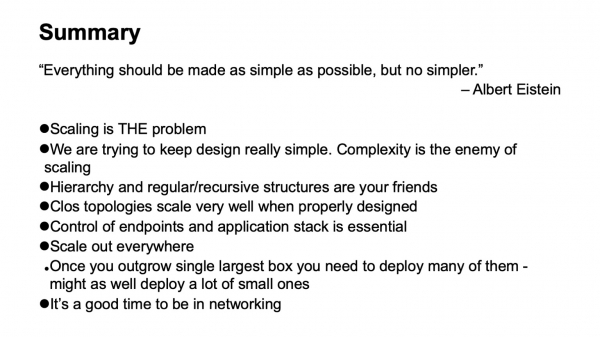
Kõik tuleks teha nii lihtsaks kui võimalik, kuid mitte lihtsamaks. Keerukus on skaleeritavuse vaenlane. Lihtsus ja regulaarne struktuur on meie sõbrad. Kui kuskil on võimalik teha scale out — tehke seda. Ja üldiselt on praegu tore tegeleda võrgutehnoloogiatega. Toimub palju huvitavat. Aitäh.
Allikas: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish