

Märkus tõlke kohta.: Tutvustame teie tähelepanu tehnilisi üksikasju hiljutise katke otsimine pilveteenuse töös, mida haldavad Grafana loojad. See on klassikaline näide sellest, kuidas uus ja näiliselt erakordselt kasulik funktsioon, mis on mõeldud infrastruktuuri kvaliteedi parandamiseks… võib kahjustada, kui ei arvestata paljude nüanssidega selle kasutamisel tootmisrežiimis. Suurepärane, kui sellised materjalid ilmuvad, võimaldades õppida mitte ainult enda vigadest. Üksikasjad – selle teksti tõlkes Grafana Labs toote asepresidendi poolt.
Reedel, 19. juulil, lõpetas Hosted Prometheus teenus Grafana Cloudis töötamise umbes 30 minutiks. Vabandan kõigi klientide ees, kes said häire tõttu kannatada. Meie ülesanne on pakkuda vajalikke tööriistu seireks ja me mõistame, et nende puudumine raskendab teie elu. Me võtame seda intsidenti äärmiselt tõsiselt. Selles märkmes selgitatakse, mis juhtus, kuidas me reageerisime ja mida teeme, et sarnased olukorrad ei korduks.
Eellugu
Grafana Cloud Hosted Prometheuse teenus põhineb – CNCF projekt, mille eesmärk on luua horisontaalselt skaleeritav, suure kättesaadavuse ja mitmeüürilise (multi-tenant) Prometheuse teenus. Cortexi arhitektuur koosneb rühmast eraldi mikroteenustest, millest igaühel on oma funktsioon: replikatsioon, salvestamine, päringud jne. Cortexi arendamine on aktiivne, sellele lisatakse pidevalt uusi võimalusi ja selle jõudlus suureneb. Me jagame regulaarselt uusi Cortexi versioone klastritesse, et kliendid saaksid nendest võimalustest kasu – õnneks oskab Cortex uuendada ilma katkestusteta.
Katkestusteta uuenduste jaoks nõuab Cortex Ingester teenus uuendusprotsessi ajal täiendavat Ingesterit. (Märkus tõlke kohta.: – Cortexi põhi komponent. Selle ülesanne on koguda pidevat voogu proove, grupeerida need Prometheuse chunk'idesse ja salvestada andmebaasidesse nagu DynamoDB, BigTable või Cassandra. See on võimaldanud vanadel Ingesteritel edastada praeguseid andmeid uutega Ingesteritele. Oluline on märkida, et Ingesterid on ressursinõudlikud. Nende tööks on vajalik 4 südamikku ja 15 GB mälu iga podi kohta, st 25% protsessorivõimsusest ja mälust meie Kubernetes klastrites. Üldiselt on meil tavaliselt palju rohkem kasutamata ressursse klastris kui 4 südamikku ja 15 GB mälu, seega saame neid täiendavaid Ingestereid hõlpsasti ajakohastamise ajal käivitada.
Kuid sageli on nii, et normaalsete tööde käigus ei ole ühelgi masinal neid 25% kasutamata ressursse. Jah, me ei püüdle selle poole: CPU ja mälu on alati kasulikud teiste protsesside jaoks. Selle probleemi lahendamiseks otsustasime kasutada . Idee seisneb selles, et anda Ingesteritele kõrgem prioriteet kui muudele (stateless) mikrosüsteemidele. Kui meil on vaja käivitada täiendav (N+1) Ingester, siis surume ajutiselt tagasi teised, madalama prioriteediga podid. Need podid kolitakse teistesse masinatesse vabadessse ressurssidesse, jättes piisavalt suured "auku" täiendava Ingesteri käivitamiseks.
Käesoleval neljapäeval, 18. juulil, käivitasime oma klastrites neli uut prioriteetide taset: kriitiline, kõrge, keskmine ja madal. Need testiti sisemises klastris ilma kliendiliikluse umbes nädal. Vaikimisi said prioriteedita podid keskmine prioriteedi, Ingesteritele anti klass kõrge prioriteedi järjekorda. Kriitiline oli reserveeritud jälgimiseks (Prometheus, Alertmanager, node-exporter, kube-state-metrics jne). Meie konfiguratsioon on avatud ja PR-i saab vaadata .
Hädaolukord
Reedel, 19. juulil, käivitas üks insener uue eraldatud Cortex klastrite suure kliendi jaoks. Selle klastrite konfiguratsioon ei sisaldanud uusi podide prioriteete, seega anti kõigile uutele podidele vaikimisi prioriteet — keskmine.
Kubernetes klastris ei jätkunud ressursse uue Cortex klastrite jaoks, ning olemasolevat tootmisühtset Cortex klastrit ei uuendatud (Ingesterid jäid kõrge prioriteedita). Kuna uue klastrite Ingesterid omasid vaikimisi keskmine prioriteedi, samas kui tootmisühtsetes podides ei olnud üldse prioriteeti, surusid uue klastrite Ingesterid alla tootmisühtses Cortex klastris asuvate Ingesterid.
ReplicaSet-i väljatõrjutud Ingester'ile tootmisklassis avastas välja tõrjutud pod'i ja lõi uue, et säilitada määratud koopiate arv. Uuele pod'ile anti vaikimisi keskmine prioriteet, ja järgmine "vana" Ingester tootmises jäi ilma ressurssidest. Tulemuseks oli lumepalliprotsess, mis viis kõigi pod'ide välja tõrjumiseni Ingester'iga tootmisklasside Cortex’is.
Ingester'id on olekuga (stateful) ja hoiavad andmeid viimase 12 tunni jooksul. See võimaldab meil neid tõhusamalt tihendada enne, kui need salvestatakse pikaajalisse laostamisse. Cortex teostab andmete jagamist seeriate vahel, kasutades jaotatud räsitamistabelit (Distributed Hash Table, DHT), ja repliiseerib iga seeria kolmele Ingester'ile läbi kvoraumide kokkuleppe stiilis Dynamo. Cortex ei kirjuta andmeid Ingester'itesse, mis on välja lülitatud. Seega, kui suur hulk Ingester'eid lahkub DHT-st, ei suuda Cortex tagada piisavat replikatsiooni kirjetest ning need "langevad".
Avastamine ja kõrvaldamine
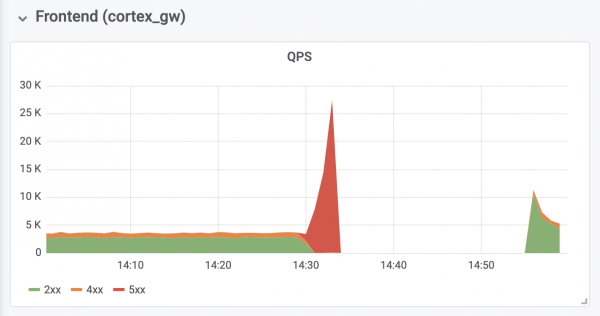
Uued Prometheuse teavitused, mis põhinevad "veabudžetil" (error-budget-based — üksikasjad ilmuvad tulevikus artiklis) hakkasid alarmi lööma 4 minuti möödudes katkestuse algusest. Järgneva viie minuti jooksul tegime diagnostikat ja suurendasime alapaneeli Kubernetes klassi nii uute kui ka olemasolevate tootmisklasside jaoks.
Viie minuti pärast õnnestus vanadel Ingester'eil oma andmed salvestada ning uued käivitusid, ja Cortex'i klassid said taas kättesaadavaks.
Veel 10 minutit läks diagnostiikaks ja out-of-memory (OOM) vigade parandamiseks, mis esinesid Cortex'i ees asuvate autentimisproksiserverite tõttu. OOM-vead olid põhjustatud kümnekordsest QPS kasvust (eeldame, et see tulenes liiga agressiivsetest päringutest kliendi Prometheuse serveritest).
Mõjud
Kokku kestis seiskamine 26 minutit. Andmeid ei kaotatud. Ingester'id said edukalt lahti kõik in-memory andmed pikaajalisse laostamisse. Katkestuse ajal salvestasid kliendi Prometheuse serverid eemaldatud (remote) kirjed uue API remote_write Callum Styan Tootmisklassi kirjutamisoperatsioonid
Oluline on õppida selle juhtumi õppustest ja võtta vajalikud meetmed, et vältida selle kordumist.
Järeldused
On oluline õppida sellest juhtumist ja võtta vajalikud meetmed, et vältida selle kordumist.
Tagasis vaatamata tuleks tunnistada, et me ei pidanud vaikimisi seadma keskmine prioriteeti, kuni kõik Ingester’id tootmises on saanud kõrge prioriteedi. Samuti oleks pidanud eelnevalt muretsema nende kõrge prioriteedi. Nüüd on kõik parandatud. Loodame, et meie kogemus aitab teisi organisatsioone, kes kaaluvad pod'ide prioriteetide kasutamist Kuberneteses.
Lisame täiendava kontrolli taseme igasuguste täiendavate objektide juurutamisel, mille seadistused on globaalsetele klastritele. Edaspidi hindame selliseid muudatusiilotkasuurema arvu inimeste poolt. Lisaks, muudatus, mis viis tõrkeni, peeti liiga ebaoluliseks igaühe projektidokumendi jaoks — sellest arutleti ainult GitHubi probleemis. Edaspidi saadavad kõik sellised konfiguratsioonimuudatused vastava projektidokumendiga.
Lõpuks automatiseerime autentimisproksi tagasivahetuse suuruse muutmise, et vältida OOM-i ülevoolu, mida olime tunnistajaks, ja analüüsime mõõdiku vaikeseadeid, mis on seotud tagasivõtmise ja skaleerimisega, et tulevikus sarnaseid probleeme ennetada.
Kogenud tõrkel oli ka mõned positiivsed tagajärjed: saadud vajalike ressursside abil taastus Cortex automaatselt ilma täiendava sekkumiseta. Saime ka väärtuslikku kogemust töötades — meie uue logide kogumise süsteemiga, — mis aitas veenduda, et kõik Ingester’id käitusid õigesti tõrke ajal ja pärast seda.
P.S. tõlkijalt
Lugege ka meie blogist:
- «»;
- «»;
- «»;
- «».
Allikas: habr.com
