

Meile tekkis mõte jälgimissüsteemi loomisest tootegruppide loomise etapis. Selgus, et meie roll - ekspluateerimine - ei kuulu nende ridadesse.
Asi on selles, et kõik meie meeskonnad on üles ehitatud eraldi infotehnoloogiliste süsteemide, mikroteenuste ja frontide ümber, mistõttu nad ei näe kogu süsteemi üldiselt. Näiteks ei pruugi nad teada, kuidas mõni väike osa sügavas tagaküljel mõjutab fronti. Nende huvi piirneb süsteemidega, millega nende süsteem on integreeritud. Kui meeskond ja tema teenus A ei ole peaaegu üldse seotud teenusega B, siis on see teenus meeskonnale peaaegu nähtamatu.
Meie meeskond töötab omakorda süsteemidega, mis on omavahel tihedalt integreeritud: nende vahel on palju seoseid, tegemist on suurte infrastruktuuridega. Ja kõigi nende süsteemide (millel on muide tohutu hulk) olemasolu sõltub internetipoe toimimisest.
Nii ongi meie osakond veidi kõrvale jäetud, kuuludes mitte ühtegi meeskonda. Kogu selles loos on meie ülesanne mõista kompleksis, kuidas infotehnoloogilised süsteemid töötavad, nende funktsionaalsust, integratsioone, tarkvara, võrku, riistvara ja kuidas kõik see omavahel seotud on.
Platvorm, millel meie internetipoed toimivad, näeb välja niimoodi:
- front
- middle-office
- back-office
Kuigi me igatseksime, et kõik süsteemid töötaksid sujuvalt ja veatult, ei ole see siiski võimalik. Asjaolu on selles, et süsteemide ja integratsioonide hulk - meie puhul - toob paratamatult kaasa teatud intsidente, hoolimata testimise kvaliteedist. See kehtib nii sisemises eraldi süsteemis kui ka nende integratsioonide osas. Ja tuleks jälgida kogu platvormi seisukorda komplekselt, mitte mõne eraldi osa järgi.
Ideaalis tuleks kogu platvormi terviseseisundi jälgimist automatiseerida. Ja me jõudsime otsuseni, et monitooring on selle protsessi vältimatu osa. Alguses oli see loodud ainult frontide jaoks, samal ajal kui süsteemide jälgimisvõtted kihtide järgi olid ja on olemas võrguekspertide, tarkvarahaldurite ja riistvara haldurite seas. Kõik need inimesed jälgisid monitooringut ainult oma tasemel, keegi ei omanud kompleksset arusaamist.
Näiteks, kui virtuaalmasin kukub, teab sellest enamasti ainult administraator, kes vastutab riistvara ja virtuaalmasina eest. Eesrinde meeskond näeb sellistes olukordades ainult rakenduse kukkumise fakti, kuid neil pole andmeid virtuaalmasina kohta. Administrator võib teada, kes on tellija, ja ligikaudselt mõista, mis just sellel virtuaalmasinal käib, eeldusel, et see on mingi suur projekt. Väikeste projektide kohta ei pruugi ta tõenäoliselt midagi teada. Igatahes peab administraator minema omaniku juurde, küsima, mis sellel masinal oli, mida tuleb taastada ja mida muuta. Kui midagi tõeliselt tõsist purunes, algab ringjooks — sest keegi ei näinud süsteemi tervikuna.
Lõppkokkuvõttes mõjutavad sellised killustatud lood kogu eesrinde, kasutajaid ja meie peamist ärifunktsiooni — veebimüüki. Kuna me ei kuulu meeskondadesse ja tegeleme kõigi e-kaubanduse rakenduste haldamisega veebipoe raames, oleme endale seadnud ülesande luua töökindel jälgimissüsteem e-kaubanduse platvormile.
Süsteemi struktuur ja tehnoloogia virnad
Alustasime sellega, et eraldasime meie süsteemide jaoks mitmeid jälgimise kihte, mille kaudu me peame mõõdikud koguma. Ja kogu see tuli omavahel siduda, mida me esimese etapina tegime. Praegu viime selle etapi raames lõpule kvaliteetse mõõdikute kogumise kõigilt meie kihtidelt, et luua korrelatsioon ja mõista, kuidas süsteemid üksteist mõjutavad.
Kompleksse jälgimise puudumine rakenduste käivitamise algfaasides (sest alustasime selle ehitamist, kui enamik süsteeme oli töös) viis selleni, et me kogusime märkimisväärse tehnilise võla kogu platvormi jälgimise seadistamisel. Keskenduda ühe teabe süsteemi jälgimise seadistamisele ja selle detailsele väljatöötamisele me endale ei saanud lubada, sest teiste süsteemide jälgimise puudumine tooks ajutiselt kaasa probleemid. Selle probleemi lahendamiseks määrasime kõige vajalikud mõõdikud teabe süsteemi seisundi hindamiseks kihtide kaupa ja alustasime nende rakendamist.
Seetõttu otsustasime, et söödame elevanti tükkideks.
Meie süsteem koosneb järgmistest komponentidest:
- riistvarast;
- operatsioonisüsteemist;
- tarkvarast;
- Rakenduse jälgimise kasutajaliidese osad;
- äri näitajad;
- integreerimise rakendused;
- teabe turvalisus;
- võrgud;
- koormuse tasakaalustaja.
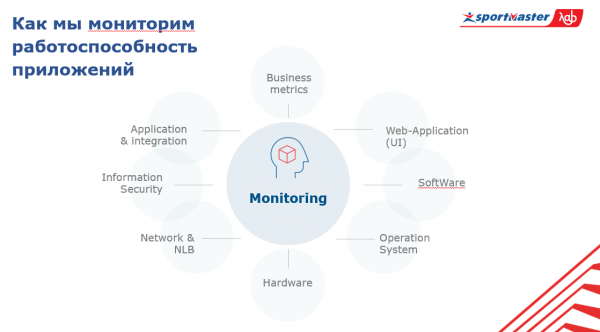
Selle süsteemi keskmes on jälgimine. Et mõista kogu süsteemi seisundit, tuleb teada, mis toimub rakendustega kõigil nendel tasanditel ja läbi nende paljude rakenduste.
Nii et, räägime tehnoloogiast.
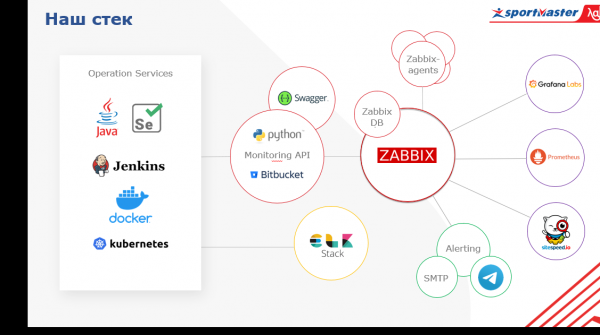
Kasutame avatud lähtekoodiga tarkvara. Meie keskmes on Zabbix, mida me kasutame eelkõige häirete süsteemina. Kõik teavad, et see sobib ideaalselt infrastruktuuri jälgimiseks. Mis selle taga peitub? Just need madalamatasemelised näitajad, mis igal ettevõttel, kes haldab oma andmekeskust (ja Sportmasteril on oma andmekeskused), on — serveri temperatuur, mälu seisund, RAID, võrgu seadmete näitajad.
Me oleme integreerinud Zabbixi Telegrami ja Microsoft Teamsiga, mida meeskondades aktiivselt kasutatakse. Zabbix katab füüsilise võrgu, riistvara ja osaliselt tarkvarakiht, kuid see pole imerohi. Me rikastame neid andmeid mõnede teiste teenustega. Näiteks riistvara tasandi puhul ühendame otse API kaudu meie virtualiseerimissüsteemiga ja saame andmeid.
Veel. Lisaks Zabbixile kasutame Prometheust, mis võimaldab jälgida dünaamilise keskkonna rakenduste näitajaid. See tähendab, et saame HTTP lõpp-punkti kaudu rakenduse näitajaid ja ei pea muretsema, milliseid näitajaid sinna laadida ning milliseid mitte. Sellel alusel saab koostada analüütilisi päringuid.
Ülejäänud kihtide andmeallikad, näiteks äri näitajate jaoks, jagunevad meil kolme komponenti.
Esiteks on need välised ärisüsteemid, Google Analytics, kogume näitajaid logidest. Nendest saame andmed aktiivsete kasutajate, konversioonide ja muude, äri jaoks oluliste asjade kohta. Teiseks on see kasutajaliidese jälgimise süsteem. Sellest tasub rääkida lähemalt.
Kunagi alustasime manuaalse testimisega ja see kasvas funktsionaalsuse ja integratsioonide automaatseteks testideks. Just sellest tekitasime jälgimise, jättes alles ainult põhifunktsionaalsuse ja seondudes markeritega, mis on võimalikult stabiilsed ja ei muutu ajas sageli.
Uus meeskonnastruktuur tähendab, et kogu rakenduste tegevus keskendub toote meeskondadele, seega oleme puhta testimisega lõpetanud. Selle asemel oleme testidest loonud UI-monitooringu, mis on kirjutatud Java, Selenium ja Jenkins'i abil (kasutatakse käivitamise ja raportite genereerimise süsteemina).
Meil oli palju teste, kuid lõpuks otsustasime liikuda peele teele, kõrgema taseme metoodikale. Ja kui meil on palju spetsiifilisi teste, on andmete ajakohasena hoidmine keeruline. Iga järgmine versioon katkestab kogu süsteemi oluliselt, ja me tegeleme ainult selle parandamisega. Seetõttu keskendume midagi tõeliselt põhilist, mis harva muutub, ja jälgime ainult neid.
Lõpuks, kolmandaks, andmeallikaks on tsentraliseeritud logimise süsteem. Logide jaoks kasutame Elastic Stack'i, ja siis saame neid andmeid tõmmata meie ärimeetodite monitooringu süsteemi. Kõigile sellele lisaks töötab meie enda Monitoring API teenus, mis on kirjutatud Python'is ja küsib API kaudu mis tahes teenuseid ning toob Zabbix'isse nende andmed.
Veel üks hädavajalik monitooringu atribuut on visualiseerimine. Meie visualiseerimine põhineb Grafana'l. Teistest visualiseerimissüsteemidest eristub see sellega, et armatuurlaud suudab visualizeerida erinevate andmeallikate mõõdikuid. Saame koguda kõrgema taseme mõõdikuid internetipoest, näiteks viimase tunni jooksul vormistatud tellimuste arvu andmebaasist, operatsioonisüsteemi jõudluse mõõdikuid, millel see internetipood töötab, Zabbix'ist, ja selle rakenduse instantside mõõdikuid Prometheus'elt. Ja kõik see on ühel armatuurlaud. Selgelt ja kergesti kättesaadavalt.
Tahan rõhutada turvalisust — praegu viimistleme süsteemi, mida hiljem integreerime globaalsete monitooringu süsteemidega. Minu arvates on peamised probleemid, millega e-kaubanduse valdkond tegeleb infotehnoloogia turvalisuses, seotud botide, parsimise ja bruteforce'iga. Sellega tuleb tähelepanu pöörata, sest see võib kriitiliselt mõjutada meie rakenduste tööd ja ettevõtte mainet. Ja valitud tehnoloogiastik katab need probleemid edukalt.
Veel tähtis punkt on see, et rakenduste taseme metrikad kogub Prometheus. See on ka meil integreeritud Zabbixiga. Meil on ka sitespeed, teenus, mis võimaldab meil jälgida selliseid parameetreid nagu meie lehe laadimiskiirus, pudelikaelad, lehe renderdamine, skriptide laadimine ja muud, see on samuti API kaudu integreeritud. Seega kogume me Zabbixis metrikad ja alarmeerime ka sealt. Kõik alarmeid saadetakse seni peamiste edastusmeetoditega (praegu on need email ja telegram, lisaks oleme hiljuti lisanud MS Teams). Plaan on täiustada alarmeerimist nii, et nutikad botid töötaksid teenusena ja pakuksid jälgimise teavet kõikidele soovijatele toote meeskondadele.
Meie jaoks on olulised metrikad mitte ainult üksikute infosüsteemide, vaid ka üldised metrikad kogu infrastruktuuri kohta, mida rakendused kasutavad: klastrid füüsilised serverid, mille peal töötavad virtuaalmasinad, koormuse tasakaalustajad, Network Load Balancerid, ise võrgu, sidekanalite kasutamine. Lisaks metrikad meie enda andmekeskuste kohta (meil on neid mitu ja infrastruktuur on üsna suur).
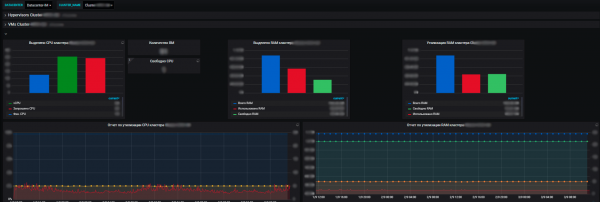
Meie jälgimissüsteemi pluss on see, et selle kaudu näeme kõigi süsteemide tööolekut, saame hinnata nende mõju üksteisele ja ühistele ressurssidele. Lõppkokkuvõttes võimaldab see meil tegeleda ressursside planeerimisega, mis kuulub samuti meie vastutusvaldkonda. Halduse all on serveriressursid — e-kaubanduse vajaduste jaoks, toome ja viime välja uusi seadmeid, ostame uusi, teeme ressursside kasutuse auditi jne. Igal aastal kavandavad meeskonnad uusi projekte, arendavad oma süsteeme, ja meil on oluline tagada nendele ressurssidest.
Ja metrikate abil näeme tendentse ressursside tarbimises meie infosüsteemide poolt. Nende põhjal saame juba midagi planeerida. Virtualiseerimise tasemel kogume andmeid ja näeme teavet saadaval olevate ressursside kohta andmekeskuste lõikes. Ja andmekeskuse sees on näha nii kasutus kui ka tegelik jaotumine, ressursside tarbimine. Nii eraldiseisvate serverite, virtuaalmasinate kui ka füüsiliste serverite klastrite kohta, mille peal kõik need virtuaalmasinad sujuvalt töötavad.
Prospects
Praegu on meie süsteemi tuum üldiselt valmis, kuid meil on veel palju teemasid, millega tuleb tegeleda. Vähemalt on see teabejulgeoleku kiht, kuid oluline on ka jõuda võrku, arendada häirete süsteemi ja lahendada korrelatsiooni küsimus. Meil on palju kihte ja süsteeme ning igas kihis on veel mitu mõõdikut. Tulemuseks on matryoshka matryoshka sees.
Meie eesmärk on lõpuks luua õiged häired. Näiteks, kui tekib probleem riistvaraga, jälle, virtuaalmasinaga, kus oli oluline rakendus ja teenust ei olnud üldse reserveeritud. Me saame teada, et virtuaalmasin on kukkunud. Siis häiritakse äri mõõdikuid: kasutajad on kuhugi kadunud, konversioone ei ole, kasutajaliides pole kätte saadav, tarkvara ja teenused on samuti kukkunud.
Sellise olukorra korral saame me häirete rikka spam'i, mis ei sobi juba korraliku monitooringu süsteemi formaati. Kätkeb küsimus korrelatsioonist. Seetõttu peaks meie monitooringusüsteem ideaalis ütlema: "Mehed, teie füüsiline masin on kukkunud, koos sellega ka see rakendus ja sellised mõõdikud," ühe häire kaudu, mitte ei peaks meid sadade häiretega üle ujutama. See peaks teavitama peamisest — põhjusest, mis aitab probleemide kiiret kõrvaldamist nende lokaliseerimise kaudu.
Meie häirete süsteem ja häirete töötlemine on üles ehitatud ööpäevaringselt töötavale hädaabi teenusele. Kõik häired, mis on meie jaoks must-have ja kuuluvad kontrollnimekirja, edastatakse sinna. Igal häirel peab olema kindlasti kirjeldus: mis juhtus, mida see tegelikult tähendab, millele see mõjub. Ja veel lingi juhendile, et mida selles olukorras teha.
Need on kõik häirimise nõuded. Edasi võib olukord areneda kahes suunas — kas probleem on olemas ja seda tuleb lahendada, või on toimunud monitooringu süsteemi rike. Kuid igal juhul tuleb minna ja selgeks teha.
Keskmiselt saavad meile nüüd ühe päeva jooksul umbes sada häiret, arvestatuna asjaoluga, et häirete korrelatsioon ei ole veel korralikult seadistatud. Ja kui on vaja teha tehnilisi töid ja me midagi sunniviisiliselt välja lülitame, suureneb nende arv kordades.
Lisaks süsteemide jälgimisele, mida me kasutame, ja mõõdikute kogumisele, mida meie poolest peetakse oluliseks, võimaldab jälgimissüsteem koguda andmeid toote meeskondade jaoks. Need saavad mõjutada mõõdikute koostamist meie jälgitavate infosüsteemide raames.
Meie kolleeg võib tulla ja paluda lisada mõni mõõdik, mis osutub kasulikuks nii meie jaoks kui ka meeskonnale. Või näiteks, võib juhtuda, et meeskonnale ei piisa olemasolevatest põhimõõdikutest, nad vajavad mingit spetsiifilist jälgimist. Grafanas loome iga meeskonna jaoks tööruumi ja anname administraatori õigused. Samuti, kui meeskond vajab juhtpaneele ja nad ei oska/kui nad ei tea, kuidas seda teha, aitame neid.
Kuna me ei ole tiimi väärtuse loomise, väljaande ja planeerimise protsessis, jõuame järk-järgult olukorrani, kus kõigi süsteemide väljaanded on sujuvad ja neid saab iga päev välja panna, ilma et peaksime sellega kooskõlastama. Meie jaoks on oluline neid väljaandeid jälgida, sest need võivad potentsiaalselt mõjutada rakenduse tööd ja midagi katki teha, mis on kriitiline. Väljaannete haldamiseks kasutame Bamboo't, kust saame API kaudu andmeid ja saame näha, millised väljaanded millistes infosüsteemides on välja tulnud ja nende staatust. Ja kõige olulisem - millal. Väljaannete markerid paneme peamistesse kriitilistesse mõõdikutesse, mis visuaalselt on üsna näitlik probleemide korral.
Nii saame näha korrelatsiooni uute väljaannete ja tekkivate probleemide vahel. Peamine idee on mõista, kuidas süsteem töötab kõikidel tasanditel, kiiresti lokaliseerida probleem ja samuti kiiresti see lahendada. Lõppude lõpuks on sageli nii, et kõige rohkem aega kulub mitte probleemi lahendamisele, vaid põhjuse leidmisele.
Ja selle suuna osas soovime tulevikus keskenduda proaktiivsusele. Ideaalis tahaksime eelnevalt teada, kui probleem on tulemas, mitte alles siis, kui see on juba juhtunud, et tegeleda selle ennetamisega, mitte lahendamisega. Mõnikord esinevad valehäired seire süsteemis, olgu need inimlike vigade või rakenduse muutuste tõttu. Me töötame selle kallal, lihvime seda ja püüame teavitada kasutajaid, kes süsteemi koos meiega kasutavad, enne kui teeme seire süsteemis mingeid muudatusi, või viia läbi need tegevused tehnilisel aknal.
Nii et süsteem on käivitatud ja toimib edukalt alates kevade algusest… ning näitab üsna reaalselt kasumit. Muidugi ei ole see selle lõplik versioon, me plaanime veel palju kasulikke lisandeid. Hetkel, nii paljude integratsioonide ja rakendustega, ei saa me ilma seire automatiseerimiseta tõeliselt hakkama.
Kui ka teie jälgite suuri projekte tõsise integratsioonide arvuga — kirjutage kommentaaridesse, millist hõbepüssi leidsisite selleks.
Allikas: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish