

Linuxis on palju tööriistu kerneli ja rakenduste silumiseks. Enamik neist mõjutab negatiivselt rakenduste jõudlust ning ei saa tootmisrežiimis kasutada.
Mõni aasta tagasi loodi — eBPF. See võimaldab jälgida südamikku ja kasutajarakendusi madala ülekattega ning ilma vajaduseta programme uuesti kompileerida ja laadida kolmandate osapoolte mooduleid südamikku.
Praegu on juba mitmeid rakenduslikke tööriistu, mis kasutavad eBPF-d, ja selles artiklis uurime, kuidas kirjutada oma töötlemistööriista, mis põhineb teegil . Artikkel põhineb tõelistel sündmustel. Me läbime tee probleemist lahenduseni, et näidata, kuidas olemasolevaid tööriistu saab konkreetses olukorras kasutada.
Ceph on aeglane
Lisati uus host Ceph klastrisse. Pärast andmete osalist migratsiooni sellele avastasime, et kirjutamisvõime kiirus on palju madalam kui teistel serveritel.
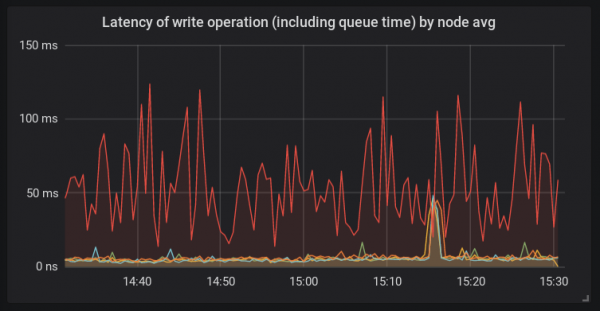
Erinevalt teistest platvormidest kasutati sellel hostil bcache'i ja uut linuxi 4.15 kernelit. Sellise konfiguratsiooniga hosti kasutatakse siin esmakordselt. Ja sel hetkel oli selge, et probleemide juur võib teoreetiliselt olla mis tahes.
Hosti uurimine
Alustame sellest, et vaatame, mis toimub ceph-osd protsessi sees. Selleks kasutame ja (rohkema teabe saamiseks lugege ):
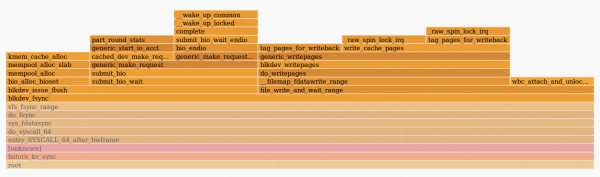
Pilt ütleb meile, et funktsioon fdatasync() veetis palju aega päringu saatmisel funktsiooni generic_make_request(). See tähendab, et probleemide põhjus on tõenäoliselt kusagil väljaspool ise osd deemonit. See võib olla kas süda või kettad. iostat-i väljund näitas kõrgeid viivitusi bcache kettadega seotud päringute töötlemisel.
Hosti kontrollimise ajal avastasime, et systemd-udevd deemon kasutab palju CPU aega — umbes 20% mitmel tuumal. See kummaline käitumine vajab uurimist. Kuna Systemd-udevd töötab ueventidega, otsustasime neid vaadata läbi udevadm monitori. Selgus, et süsteemis genereeritakse iga plokiseadmest palju change-sündmusi. See on üsna ebatavaline, seega tuleb uurida, mis genereerib kõik need sündmused.
BCC tööriistakomplekti kasutamine
Nagu me juba tuvastasime, kulutab süda (ja ceph deemon süsteemi kutses) palju aega generic_make_request(). Proovime mõõta selle funktsiooni töötamise kiirus. Seda juba olemasolevat suurepärast tööriista — funclatency. Me tracime demonit tema PID ja infosalongide vaheajaga 1 sekund ja kuvame tulemuse millisekundites.
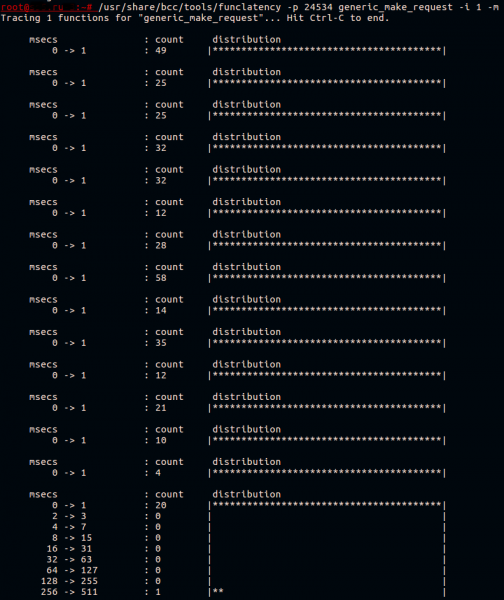
Tavaliselt töötab see funktsioon kiiresti. Kõik, mida ta teeb – edastab päringu seadme draiveri järjekorda.
Bcache on keeruline seade, mis tegelikult koosneb kolmest kettast:
- toetav seade (vahemälu ketas), sel juhul aeglane HDD;
- vahemälu seade (vahemälu ketas), siin on see ühe NVMe seadme partitsioon;
- virtuaalne bcache seade, millega rakendus töötab.
Teame, et päringu edastamine on aeglane, kuid millise nende seadmete puhul? Uurime seda natuke hiljem.
Praegu teame, et uevent'id põhjustavad tõenäoliselt probleeme. Leida, mis täpselt nende genereerimist põhjustab, pole nii lihtne. Eeldame, et see on mingi tarkvara, mis käivitatakse perioodiliselt. Vaatame, milline tarkvara süsteemis käivitatakse, kasutades skripti execsnoop samast . Käivitame selle ja suuname väljundi faili.
Näiteks nii:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Ei hakka siin tooma täishulgaga execsnoop'i väljundit, kuid üks meid huvitav rida nägi välja nii:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
Kolmas veerg on PPID (vanema PID) protsessist. Protsess, millel on PID 5802, oli üks meie jälgimis süsteemi lõime. Jälgimis süsteemi konfiguratsiooni kontrollimisel leiti valesti seadistatud parameetreid. HBA-adapteri temperatuur mõõdeti iga 30 sekundi järel, mis oli palju oftükk aegade jooksul. Pärast kontrollimise vahemaa pikendamist avastasime, et päringute töötlemise viivitus ei olnud enam teiste hostide seas eristatav.
Kuid endiselt ei ole selge, miks bcache seade nii aeglaselt töötas. Valmistame ette testplatvormi identse konfiguratsiooniga ja proovime probleemi uuesti esile kutsuda, käivitades fio bcache'l, aeg-ajalt käivitades udevadm trigger'i, et genereerida uevents.
BCC-põhiste tööriistade kirjutamine
Proovime kirjutada lihtsa utiliidi jälgimiseks ja ekraanile kuvamiseks kõige aeglasemaid kutseid generic_make_request(). Meid huvitab ka ketta nimi, mille jaoks see funktsioon kutsuti.
Plaani on lihtne:
- Registreerime kprobe . Tundub, et generic_make_request():
- Kasutame mälus ketta nime, mis on saadaval funktsiooni argumendina;
- Salvesta ajatempos.
- Registreerime kretprobe tagasi pöördumise korral generic_make_request():
- Saame praeguse ajatempo;
- Otsime salvestatud ajatempo ja võrreldame seda praegusega;
- Kui tulemus on suurem kui määratud, siis leiame salvestatud ketta nime ja kuvame selle terminalis.
Kprobes ja kretprobes kasutavad funktsioonide koodi muutmiseks peatuspunkte. Saate lugeda ja artikkel selle teema kohta. Kui vaadata erinevate utiliitide koodi , siis on nende struktuur ühesugune. Seega jätame selles artiklis skripti argumentide analüüsi vahele ja liikume edasi BPF-programmi juurde.
eBPF teksti python-skripti sees näeb välja järgmine:
bpf_text = """ # Siia tuleb bpf programmi kood """
Andmete vahetamiseks funktsioonide vahel kasutavad eBPF programmid . Teeme ka nii. Võtame võtmeks protsessi PID ja väärtuseks määrame struktuuri:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Siin registreerime hash-tabelle, mida nimetatakse p, võtme tüübiga u64 ja väärtuse tüübiga struct data_t. Tabel on meie BPF-programmi kontekstis kergesti ligipääsetav. Makros BPF_PERF_OUTPUT registreerib teise tabeli nimega events, mida kasutatakse kasutajaruumi.
Kutsumisviisi ja tagastamise vaheliste viiviste mõõtmisel, kas erinevate funktsioonide vahel, tuleb arvestada, et saadud andmed peavad kuuluma samasse konteksti. Teisisõnu, tuleb meeles pidada võimalike funktsioonide paralleelset täitmist. Meil on võimalus mõõta viivitust funktsiooni kutse ja tagasipöörde vahel, koos ühes protsessis, aga see on tõenäoliselt kasutu. Hea näitena võib tuua , kus hash-tabeli võtmena kasutatakse näidikut struct request, mis kajastab ühte kettakutsungit.
Seejärel peame kirjutama koodi, mis käivitatakse uuritava funktsiooni kutse tulemuseks:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Siin on teise argumendina esimese argumendi kutse . Pärast seda saame protsessi PID, mille kontekstis töötame, ja praeguse ajatempli nanosekundites. Salvestame kõik värskelt eraldatud struct data_t data. Ketaste nime saame struktuurist bio, mis edastatakse kutse puhul generic_make_request(), ja salvestame selle samasse struktuuri data. Viimasena lisame kirje varem mainitud hash-tabelisse.
Järgmine funktsioon kutsub end tagasi generic_make_request():
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts)/1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
See funktsioon on sarnane eelnevale: me saame protsessi PId ja ajatempli, kuid ei reserveeri uut mälu data jaoks. Selle asemel otsime hash-tabelist juba olemasolevat struktuuri, mille võti on praegune PID. Kui struktuur leidub, teame käivitatud protsessi nime ja lisame selle sellele.
Siin kasutatav binaarset nihutust kasutatakse, et saada niisugune thread GID, st. põhiprotsessi PID, mis käivitab niidi, mille kontekstis me töötame. Meie kutsutav funktsioon tagastab nii thread GID kui ka selle PID ühes 64-bitises väärtuses.
Kuna me ei huvita voogu terminali väljundis, huvita meid põhiprotsess. Kui saadud viivitus võrreldakse seatud lävega, edastame oma struktuuri data kasutajaruumis tabeli kaudu events, pärast mida kustutame kirje p.
Python-skriptis, mis seda koodi laadib, peame asendama MIN_US ja FACTOR viivituse läve ja ajayksuse väärtustega, mille anname argumendina:
bpf_text = bpf_text.replace('MIN_US',str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR','data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR','')
	label = "usec"
Nüüd peame valmistama ette BPF programmi kasutades ja registreerima katsepunktid:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request",fn_name="start")
b.attach_kretprobe(event="generic_make_request",fn_name="stop")
Peame ka määratlema struct data_t meie skriptis, vastasel juhul ei saa me midagi lugeda:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk",ct.c_char * DISK_NAME_LEN)]
Viimane samm – andmete väljastamine terminalis:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# формата вывода
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Skripti on saadaval . Proovime seda testplatvormil käivitada, kus fio kirjutab bcache'i ja kutsume esile udevadm monitor:
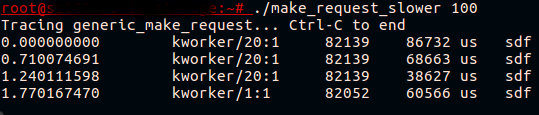
Lõpuks! Nüüd näeme, et see, mis näis olevat bcache-seadmest tulenev viivitus, oli tegelikult viivitus вызова generic_make_request() kaheks kassatava kettale.
Kaevume süvitsi Kernelisse
Mis täpselt põhjustab päringu edastamisel viivituse? Näeme, et viivitus tekib isegi enne, kui päringu arvestamine algab, st konkreetse päringu arvestamine edasiseks statistika esitamiseks (\/proc\/diskstats või iostat) ei ole veel alanud. Seda on lihtne kontrollida, käivitades iostat probleemide reprodutseerimise ajal, või , mis põhineb päringute arvestamise algusel ja lõpule. Ükski neist utiliitidest ei näita probleeme kassatava ketta päringutega.
Kui vaatame funktsiooni generic_make_request(), siis näeme, et enne päringu arvestamise algust kutsutakse üles veel kaks funktsiooni. Esimene — generic_make_request_checks(), kontrollib päringu legitiimsust ketta seadetega. Teine — , milles on huvitav kutse :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
Sellega ootab kernel järjekorra sulgemist. Mõõdame viivituse blk_queue_enter():
~# \/usr\/share\/bcc\/tools\/funclatency  blk_queue_enter -i 1 -m
Jälgimine 1 funktsiooni jaoks "blk_queue_enter"... Vajutage Ctrl-C lõpetamiseks.

 	msecs           	: count 	distribution
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Tundub, et oleme lahenduse lähedal. Funktsioonid, mida kasutatakse järjekorra "külmutamiseks\/sulgemiseks", on ja . Need on kasutusel, kui on vaja muuta päringute järjekorra seadeid, mis võivad olla ohtlikud selle järjekorra päringutele. Kui kutsub blk_mq_freeze_queue() funktsioon suurendab arvestit q->mq_freeze_depth. Pärast seda ootab tuum, kuni järjekord tühjeneb .
Ootamisaja pikkus, et see järjekord tühjendataks, on võrreldav ketta latentsusega, kuna tuum ootab kõigi järjekorda seatud toimingute lõpuleviimist. Kui järjekord on tühi, rakendatakse seade muutused. Pärast seda kutsutakse üles , vähendades arvestit freeze_depth.
Nüüd me teame piisavalt, et olukorda parandada. Käsk udevadm trigger toob kaasa seadete rakendamise plokiseadmest. Need seaded on kirjeldatud udev reeglites. Saame teada, millised seaded „külmutavad“ järjekorda, proovides neid muuta sysfs kaudu või vaadates tuumakoodi. Samuti saame proovida BCC utiliiti , mis väljastab terminalile tuuma ja kasutajaruumi steki jäljed iga blk_freeze_queue, näiteks:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Udev reeglid muutuvad üsna harva ja tavaliselt toimub see kontrollitud viisil. Nii et me näeme, et isegi juba seadistatud väärtuste rakendamine põhjustab rakenduse ja ketta vahelise päringu edastamise viivituse tõusu. Loomulikult ei ole udev sündmuste genereerimine, kui ketta konfiguratsioonis ei toimu mingeid muutusi (näiteks seade ei tõmmata välja ega ühendata), eriti hea praktika. Siiski saame aidata tuumale mitte teha mõttetut tööd ja mitte „külmutada“ päringute järjekorda, kui see pole vajalik. parandavad olukorda.
Kokkuvõte
eBPF on väga paindlik ja võimas tööriist. Artiklis vaatasime ühte praktilist juhtumit ja demonstreerisime vaid väikest osa sellest, mida on võimalik teha. Kui olete huvitatud BCC utiliitide arendamisest, tasub vaadata , mis selgitab hästi töö aluseid.
On veel muid huvitavaid eBPF-põhiseid silumis- ja profileerimistööriistu. Üks neist on , mis võimaldab kirjutada võimsaid ühesirgelisi skripte ja väikeseid programme awk-taolises keeles. Teine on , mis võimaldab koguda madala taseme kõrge eraldusvõimega mõõdikuid otse teie prometheus serverisse, võimaldades hiljem saada ilusat visualiseerimist ja isegi häireid.
Allikas: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish