

Kübernetesest on räägitud juba paar aastat tagasi Essentsiaalselt esinevad rakendustes juhuslikud võrgu viivitused, mis ulatuvad 100 ms või rohkem, mis toob kaasa ajautusi või uuesti proovimise. Ootused olid, et teenused suudavad päringutele palju kiiremini vastata kui 100 ms. Kuid see pole võimalik, kui ise ühendus võtab nii kaua aega. Eraldi oleme jälginud väga kiireid MySQL päringuid, mis pidid võtma millisekundeid, ja MySQL tõepoolest täitis vastuse millisekunditega, kuid päringu rakenduse seisukohalt kestis vastus 100 ms või kauem.
Selgelt tuli välja, et probleem ilmneb ainult Kubernetese sõlmega ühendamisel, isegi kui kõne tuli Kubernetese väljast. Probleemi on kõige lihtsam paljastada testis
, mis käivitatakse igalt sisemiselt hostilt, testib Kubernetese teenust kindlal pordil ja sporaadiliselt registreerib suurt viivitust. Käesolevas artiklis käsitleme, kuidas õnnestus meil selle probleemi põhjus jälile saada. Eemaldame ebaolulise keerukuse rikke ahelast
Korrates sama näidet, soovisime kitsendada probleemi fookust ja eemaldada tarbetud keerukuse kihid. Alguses oli Kubernetese ja pod'ide vahelises voos liiga palju elemendid. Sügava võrgu probleemi kindlakstegemiseks tuleb mõned neist välja jätta.
Kliendi (Vegeta) TCP-ühenduse loomine igasuguse sõlmiga klastris. Kubernetese töötab kui ülevõtuv võrk (olemasoleva andmekeskuse võrgu kohal), mis kasutab
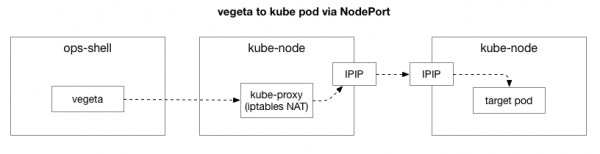
IPIP Võrguaadresside tõlkimine (NAT) olekseisuhteet Kubernetes-solmun IP-osoitteen ja portin muuntamiseksi IP-osoitteeksi ja portiksi ylikerroksessa (erityisesti sovelluspodille). Saapuneille pakkauksille suoritetaan käänteinen järjestys. Tämä on monimutkainen järjestelmä, jossa on suuri määrä tiloja ja elementtejä, jotka päivittyvät ja muuttuvat jatkuvasti palveluiden käyttöönoton ja siirron myötä.
Utiliit tcpdump testissä Vegeta aiheuttaa viivettä TCP-kättelyssä (SYN ja SYN-ACK välillä). Tämän ylimääräisen monimutkaisuuden poistamiseksi voidaan käyttää hping3 yksinkertaisille «ping» SYN-pakkauksille. Tarkistamme, onko vastauspakkauksessa viivettä, ja sitten suljemme yhteyden. Voimme suodattaa tiedot, sisältäen vain yli 100 ms:n paketit, ja saada yksinkertaisemman tavan ongelman toistamiseen kuin täydellinen verkkotason 7 -testi Vegetassa. Tässä ovat Kubernetes-solmun «pingit» käyttäen TCP SYN/SYN-ACK palvelun «solmun portilla» (30927) 10 ms:n välein, suodatettuna hitaimmista vasteista:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -S -p 30927 -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1485 win=29200 rtt=127.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1486 win=29200 rtt=117.0 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1487 win=29200 rtt=106.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1488 win=29200 rtt=104.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5024 win=29200 rtt=109.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5231 win=29200 rtt=109.2 ms
Voimme heti tehdä ensimmäisen havainnon. Järjestysnumeroista ja aikarajoista on selvää, että nämä eivät ole kertaluonteisia tukoksia. Viive kertyy usein, ja lopulta se käsitellään.
Haluamme selvittää, mitkä komponentit voivat olla osallisina tukoksen syntymisessä. Onko se jokin sadoista iptables-säännöistä NAT:ssä? Tai onko kyseessä IPIP-tunneloinnin ongelmat verkossa? Yksi tapa tarkistaa tämä on käydä läpi järjestelmän jokainen vaihe poistamalla se. Mitä tapahtuu, jos poistamme NAT:in ja palomuurin logiikan, jättäen vain osan IPIP:stä:
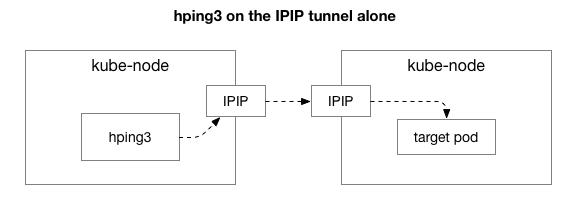
Onneksi Linuxin avulla on helppo käyttää suoraan IP-ylikerrosta, jos kone kuuluu samaan verkkoon:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7346 win=0 rtt=127.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7347 win=0 rtt=117.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7348 win=0 rtt=107.2 ms
Tulemuste põhjal on probleem ikka veel olemas! See välistab iptables ja NAT. Tähendab, probleem on TCP-s? Vaatame, kuidas tavaline ICMP-ping käib:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=28 ip=10.125.20.64 ttl=64 id=42594 icmp_seq=104 rtt=110.0 ms
len=28 ip=10.125.20.64 ttl=64 id=49448 icmp_seq=4022 rtt=141.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49449 icmp_seq=4023 rtt=131.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49450 icmp_seq=4024 rtt=121.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49451 icmp_seq=4025 rtt=111.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49452 icmp_seq=4026 rtt=101.1 ms
len=28 ip=10.125.20.64 ttl=64 id=50023 icmp_seq=4343 rtt=126.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50024 icmp_seq=4344 rtt=116.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50025 icmp_seq=4345 rtt=106.8 ms
len=28 ip=10.125.20.64 ttl=64 id=59727 icmp_seq=9836 rtt=106.1 ms
Tulemused näitavad, et probleem ei ole kadunud. Võib-olla on tegemist IPIP tunneliga? Vaatame testi veel lihtsamaks:
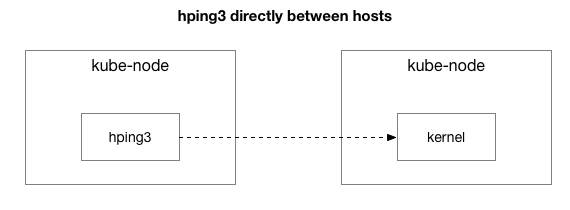
Kas kõik paketid saadetakse nende kahe hosti vahel?
theojulienne@kube-node-client ~ $ sudo hping3 172.16.47.27 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 id=41127 icmp_seq=12564 rtt=140.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41128 icmp_seq=12565 rtt=130.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41129 icmp_seq=12566 rtt=120.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41130 icmp_seq=12567 rtt=110.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41131 icmp_seq=12568 rtt=100.7 ms
len=46 ip=172.16.47.27 ttl=61 id=9062 icmp_seq=31443 rtt=134.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9063 icmp_seq=31444 rtt=124.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9064 icmp_seq=31445 rtt=114.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9065 icmp_seq=31446 rtt=104.2 ms
Oleme lihtsustanud olukorda kahe Kubernetes sõlmpunktiga, mis saadavad üksteisele igasuguseid pakette, isegi ICMP pinge. Nad näevad ikka viivitust, kui sihtkohaks on 'halb' host (mõned halvemad kui teised).
Nüüd viimane küsimus: miks viivitus tekib ainult kube-node serverites? Ja see juhtub, kui kube-node on saatja või vastuvõtja? Õnneks on seda üsna lihtne selgitada, saates paketti Kubernetesest väljaspool hostist, kuid sama 'tuntud halva' vastuvõtja juurde. Nagu näeme, probleem ei ole kadunud:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=312 win=0 rtt=108.5 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=5903 win=0 rtt=119.4 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=6227 win=0 rtt=139.9 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=7929 win=0 rtt=131.2 ms
Seejärel teeme samu päringuid eelnevalt mainitud kube-node poolt välisele hostile (mis välistab algse hosti, kuna ping sisaldab nii RX kui TX komponenti):
theojulienne@kube-node-client ~ $ sudo hping3 172.16.33.44 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
 ^C
 --- 172.16.33.44 hping statistika ---
 22352 paketti saadetud, 22350 paketti vastu võetud, 1% paketi kadu
 ümbermineku minimaalne/keskmine/maksimaalne = 0.2/7.6/1010.6 ms
Pakettide hilinemise analüüsimisel saime mõningast täiendavat teavet. Eelkõige, et saatja (allpool) näeb seda aegumist, samas kui saaja (üles) ei näe - vt veerg Delta (sekundites):
Lisaks, kui vaadata TCP ja ICMP pakettide järjekorra erinevust (järjekorranumbrite järgi) saaja poolel, siis ICMP paketid jõuavad alati samas järjekorras, nagu need saadeti, aga erineva ajastusega. Samal ajal vahelduvad TCP paketid mõnikord, ja osa neist jääb pidama. Eelkõige, kui uurida SYN pakettide porte, siis saatja poolel need on järjestatud, saaja poolel aga mitte.
On peen erinevus selles, kuidas Veel üks uus tähelepanek: selle perioodi jooksul näeme ICMP viivitusi kõikides suhtluses kahe hosti vahel, kuid TCP-l ei ole. See annab meile märku, et põhjus on tõenäoliselt seotud RX järjekordade häsheerimisega: peaaegu kindlasti tekib ummik pakettide RX töötlemisel, mitte vastuste saatmisel.
See välistab võimalikest põhjustest pakettide saatmise. Nüüd teame, et pakettide töötlemise probleem on osaliselt seotud mõnede kube-node serveritega.
Selgitame välja pakettide töötlemise Linuxi tuumas
Kuna mõistame, miks probleem tekkib saaja poolel mõnedel kube-node serveritel, vaatame, kuidas Linuxi tuum töötleb pakette.
Naastes kõige lihtsamasse traditsioonilisse rakendusse, võrgukaart saab paketi ja saadab
katkestuse Linuxi kernelile, et saabunud on pakett, mida tuleb töödelda. Kernel peatab muud toimingud, lülitab konteksti katkestusekäsitlejale, töötleb paketi ja naaseb seejärel käimasolevate ülesannete juurde.
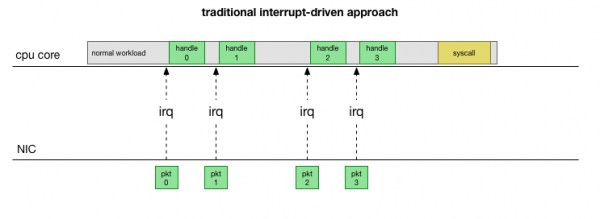
Kontexti vahetamine toimub aeglaselt: kuigi 10-megabitiste võrgukaartide puhul 90-ndatel võis viivitus jääda märkamatuks, siis tänapäevastes 10G kaartides, mille maksimaalne läbilaskevõime on 15 miljonit paketti sekundis, võivad iga tuuma väikese kaheksatuumalise serveri katkestused toimuda miljoneid kordi sekundis.
Kuna katkestuste pideva töötlemisega tegelemine pole praktiline, lisati Linuxisse juba mitu aastat tagasi : võrgurakendusprogrammide liides, mida kasutavad kõik kaasaegsed draiverid, et suurendada jõudlust kõrgetel kiirusel. Madalatel kiirusel võtab tuum ikka veel katkestusi võrgu kaardilt vana meetodi järgi. Kui piisav kogus pakette, mis ületab künnise, saabub, keelab tuum katkestused ja asub selle asemel võrgukaarti küsitlema ning pakette partii kaupa koguma. Töötlemine toimub softirq kontekstis, see tähendab süsteemikõnede ja riistvarakatkestuste järel, kui tuum (erinevalt kasutajaruumi) on juba käivitatud.
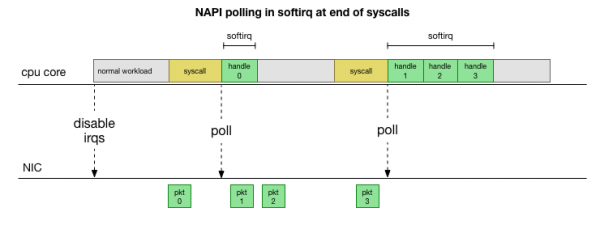
See on palju kiirem, kuid tekitab teisi probleeme. Kui pakette on liiga palju, kulub kogu aeg võrgu kaardilt pakettide töötlemiseks ja kasutajaruumi protsessid ei jõua neid järjekordadest reaalselt tühjendada (näiteks lugedes TCP-ühendustest jne). Lõpuks täituvad järjekorrad ja hakkame pakette tagasi viskama. Tasakaalu leidmiseks seab tuum maksimaalse pakettide arvu, mis töötlemise kontekstis softirq-s saab töödeldud. Kui see eelarve ületatakse, käivitatakse eraldi thread ksoftirqd (näete ühte neist igas ps tuumas), mis käsitleb neid softirq-sid tavapärase syscall/ katkestuste teest väljaspool. See teema plaanitakse standardse protsesside ajakava abil, mis püüab hoolikalt jagada ressursse.
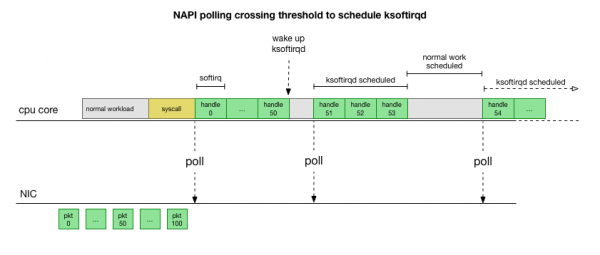
Uurides, kuidas tuum pakette töötleb, võib märgata, et siin on teatav tõenäosus ummikute tekkimiseks. Kui softirq-kõnesid tuleb harvemini, peavad paketid mõnda aega ootama võrgu kaardil RX järjekorras töötlemist. Võib-olla juhtub see mingist ülesandest, mis blokeerib protsessorituuma, või midagi muud takistab tuumast softirq käivitamist.
Piirame töötlemise tuuma või meetodini.
Softirq viivitused on praegu vaid oletus. Kuid see on mõistlik ja me teame, et meil on jälgida midagi väga sarnast. Seega on järgmine samm selle teooria kinnitamine. Ja kui see kinnitub, leida viivituste põhjus.
Naaseme meie aeglaste pakettide juurde:
len=46 ip=172.16.53.32 ttl=61 id=29573 icmp_seq=1953 rtt=99.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29574 icmp_seq=1954 rtt=89.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29575 icmp_seq=1955 rtt=79.2 ms
len=46 ip=172.16.53.32 ttl=61 id=29576 icmp_seq=1956 rtt=69.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29577 icmp_seq=1957 rtt=59.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29790 icmp_seq=2070 rtt=75.7 ms
len=46 ip=172.16.53.32 ttl=61 id=29791 icmp_seq=2071 rtt=65.6 ms
len=46 ip=172.16.53.32 ttl=61 id=29792 icmp_seq=2072 rtt=55.5 ms
Nagu varem arutatud, on need ICMP paketid hakatud ühe NIC RX järjekorda ja töödeldud ühe CPU tuuma poolt. Kui me tahame mõista Linuxi toimimist, on kasulik teada, kus (millisel CPU tuumal) ja kuidas (softirq, ksoftirqd) neid pakette töödeldakse, et jälgida protsessi.
Nüüd on aeg kasutada tööriistu, mis võimaldavad reaalajas jälgida Linuxi tuuma tööd. Siin kasutasime . See tööriistade komplekt võimaldab kirjutada väikeseid C programme, mis tabavad juhuslikke funktsioone tuumas ja puhvrivad sündmusi kasutaja ruumi Python programmile, mis suudab neid töödelda ja tagastada teile tulemuse. Juhuslikud funktsioonide tahvlid tuumas on keeruline teema, kuid utiliit on kavandatud maksimaalse turvalisuse tagamiseks ja mõeldud jälgima just selliseid tootmisprotsesside probleeme, mida on keeruline kopeerida testimis- või arenduskeskkonnas.
Plaan on lihtne: me teame, et tuum töötleb neid ICMP pingeid, seega paneme taha juure funktsiooni , mis vastuvõtab sissetuleva ICMP-paketi "echo request" ja algatab ICMP-vastuse "echo response" saatmise. Me saame paketti tuvastada icmp_seq arvu suurenemise järgi, mis näitab hping3 kõrgem.
Kood tundub keeruline, kuid see pole nii hirmus, kui näib. Funktsioon icmp_echo edastab struct sk_buff *skb: see on "echo request" pakk. Me saame selle jälgida, eemaldada järjestuse echo.sequence (mis vastab icmp_seq hping3-st üle), ja saata selle kasutaja ruumi. Samuti on mugav jäädvustada praegune protsessi nimi/identifikaator. Allpool on näidatud tulemused, mida näeme pakettide töötlemise ajal tuuma poolt:
TGID    PID     PROCESS NAME    ICMP_SEQ
0       0       swapper/11      770
0       0       swapper/11      771
0       0       swapper/11      772
0       0       swapper/11      773
0       0       swapper/11      774
20041   20086   prometheus      775
0       0       swapper/11      776
0       0       swapper/11      777
0       0       swapper/11      778
4512    4542   spokes-report-s  779
Siin tuleb märkida, et kontekstis softirq protsessid, mis tegid süsteemikõnesid, kuvatakse kui „protsessid“, kuigi tegelikult töödeldakse pakette ohutult tuuma kontekstis.
Selle tööriistaga saame seostada konkreetseid protsesse konkreetsete paketidega, mis näitavad viivitust hping3. Teeme lihtsa grep sellel salvestusel teatud väärtuste jaoks icmp_seq. Paketid, mis vastavad ülalmainitud icmp_seq väärtustele, on märgitud koos nende RTT-ga, mida me ülal nägime (sulgudes on oodatud RTT väärtused pakettide puhul, mille filtreerisime välja väärtuste alla 50 ms tõttu):
TGID    PID     PROCESS NAME    ICMP_SEQ ** RTT
--
10137   10436   cadvisor        1951
10137   10436   cadvisor        1952
76      76      ksoftirqd/11    1953 ** 99ms
76      76      ksoftirqd/11    1954 ** 89ms
76      76      ksoftirqd/11    1955 ** 79ms
76      76      ksoftirqd/11    1956 ** 69ms
76      76      ksoftirqd/11    1957 ** 59ms
76      76      ksoftirqd/11    1958 ** (49ms)
76      76      ksoftirqd/11    1959 ** (39ms)
76      76      ksoftirqd/11    1960 ** (29ms)
76      76      ksoftirqd/11    1961 ** (19ms)
76      76      ksoftirqd/11    1962 ** (9ms)
--
10137   10436   cadvisor        2068
10137   10436   cadvisor        2069
76      76      ksoftirqd/11    2070 ** 75ms
76      76      ksoftirqd/11    2071 ** 65ms
76      76      ksoftirqd/11    2072 ** 55ms
76      76      ksoftirqd/11    2073 ** (45ms)
76      76      ksoftirqd/11    2074 ** (35ms)
76      76      ksoftirqd/11    2075 ** (25ms)
76      76      ksoftirqd/11    2076 ** (15ms)
76      76      ksoftirqd/11    2077 ** (5ms)
Tulemused räägivad meile mitmest asjast. Esiteks, kõik need paketid töödeldakse kontekstis ksoftirqd/11. See tähendab, et selle konkreetse masinate paari jaoks hakatakse ICMP-pakette hashima tuuma 11 vastuvõtva poolele. Me näeme ka, et iga ummistuse ajal on olemas pakette, mida töödeldakse süsteemikõne kontekstis cadvisor. Siis ksoftirqd võtab ülesande enda kanda ja töötleb akumuleeritud järjekorra: see on sama palju pakette, mis on kogunenud pärast cadvisor.
See, et vahetult enne seda töötab alati cadvisor, viitab tema osalusele probleemis. Irooniliselt on tema eesmärk — „analüüsida ressursside kasutamist ja käivitatud konteinerite jõudluse omadusi“, mitte tekitada seda jõudlusprobleemi.
Nagu teiste konteinerite töö aspektidega, on see kõik äärmiselt keeruline tööriist, millelt võib oodata jõudlusprobleeme teatud ettenägematutes oludes.
Mida teeb cadvisor, mis aeglustab paketijärjekorda?
Nüüd on meil üsna hea arusaam, kuidas tõrked toimuvad, milline protsess need põhjustab ja millisel CPU-l need esinevad. Näeme, et Linuxi tuuma tõttu ei suuda range lukustamine õigel ajal planeerida. ksoftirqd. Ja me näeme, et pakette töödeldakse kontekstis. cadvisor. On loogiline eeldada, et cadvisor käivitab aeglase syscall'i, mille järel töödeldakse kõik selle aja jooksul kuhjunud paketid:
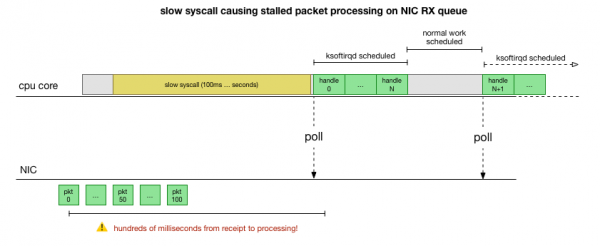
See on teooria, aga kuidas seda kontrollida? Mis me saavad teha, on jälgida CPU tuuma tööd kogu selle protsessi vältel, leida punkt, kus pakettide hulga ületamine toimub ja ksoftirqd käivitatakse, ning seejärel vaadata veidi varem — mis täpselt tuuma CPU-l selles hetkes töötas. See on nagu röntgenpilt CPU-st iga paar millisekundi järel. See näeb välja umbes nii:
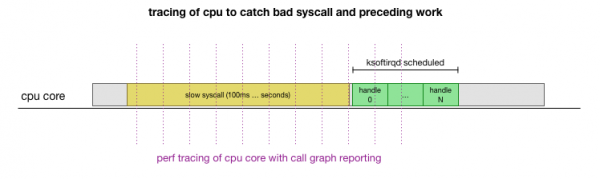
Kena on see, et kogu seda saab teha olemasolevate tööriistadega. Näiteks kontrollib määratud aegade järel antud CPU tuuma ja suudab genereerida töötava süsteemi kutsete graafiku, sealhulgas nii kasutajaruumi kui ka Linuxi tuuma. Saame võtta selle salvestuse ja töödelda seda väikese forki abil programmist Brendan Greggilt, mis säilitab virnastamise järjekorra. Saame salvestada ühekordsed virnastamisjäljed iga 1 ms järel ja seejärel eraldada ja salvestada näidise 100 millisekundi enne, kui jälgimus salvestatakse. ksoftirqd:
# record 999 times a second, or every 1ms with some offset so not to align exactly with timers
 sudo perf record -C 11 -g -F 999
 # take that recording and make a simpler stack trace.
 sudo perf script 2>/dev/null | ./FlameGraph/stackcollapse-perf-ordered.pl | grep ksoftir -B 100
Siin on tulemused:
(sajaid jälgi, mis näevad välja sarnased)
cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_iter cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;ixgbe_poll;ixgbe_clean_rx_irq;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;bond_handle_frame;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;ipip_tunnel_xmit;ip_tunnel_xmit;iptunnel_xmit;ip_local_out;dst_output;__ip_local_out;nf_hook_slow;nf_iterate;nf_conntrack_in;generic_packet;ipt_do_table;set_match_v4;ip_set_test;hash_net4_kadt;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;hash_net4_test ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;gro_cell_poll;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;dev_queue_xmit_nit;packet_rcv;tpacket_rcv;sch_direct_xmit;validate_xmit_skb_list;validate_xmit_skb;netif_skb_features;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;__dev_queue_xmit;dev_hard_start_xmit;__bpf_prog_run;__bpf_prog_run
Siin on palju, kuid peamine, et leidsime mustri „cadvisor enne ksoftirqd“, mida oleme varem näinud ICMP jälgijas. Mis see tähendab?
Iga rida on CPU jälgimine kindlal ajahetkel. Iga allavoolu kutse reas on eraldatud semikooloniga. Ridade keskel näeme kutset: read(): .... ;do_syscall_64;sys_read; .... Nii et cadvisor veedab palju aega süsteemi kutsele read(), mis on seotud funktsioonidega mem_cgroup_* (kutsu üles väljund/reana lõpus).
Kutsumisjälgides on ebamugav vaadata, mida täpselt loetakse, seega käivitame strace ja vaatame, mida cadvisor teeb, ja leiame rohkem kui 100 ms kestvaid süsteemi kutseid:
theojulienne@kube-node-bad ~ $ sudo strace -p 10137 -T -ff 2>&1 | egrep '<0.[1-9]'
 [pid 10436]  ) = 0
 [pid 10432]  ) = 0
 [pid 10137]  ) = 0
 [pid 10384]  ) = 0
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 658
 [pid 10384]  ) = 0
 [pid 10436]  ) = 0
 [pid 10436]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10427]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10411]  ) = 0
 [pid 10382]  ) = 0 (Timeout)
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 660
 [pid 10417]  ) = 0
 [pid 10436]  ) = 0
 [pid 10417]  ) = 0
 [pid 10417]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 576
Nagu oodata võis, näeme siin aeglaseid kutseid. read(). Lugemisoperatsioonide ja konteksti sisu mem_cgroup on selge, et need kutsed read() on seotud failiga memory.stat, mis näitab mälukasutust ja cgroupide piirmäärasid (Dockeris ressursside isolatsiooni tehnoloogia). Cadvisor tööriist küsib seda faili, et saada teavet konteinerite ressursside kasutamise kohta. Kontrollime, kas see on tuuma põhjus või teeb cadvisor midagi ootamatut:
theojulienne@kube-node-bad ~ $ time cat /sys/fs/cgroup/memory/memory.stat >/dev/null
real 0m0.153s
user 0m0.000s
sys 0m0.152s
theojulienne@kube-node-bad ~ $
Nüüd saame vea taasluua ja mõistame, et Linuxi tuum seisab silmitsi patoloogiaga.
Miks on lugemise operatsioon nii aeglane?
Selles etapis on oluliselt lihtsam leida teiste kasutajate sõnumeid sarnaste probleemide kohta. Selgus, et cadvisor tracker'is on selle vea kohta teatatud kui , kuid keegi ei pannud tähele, et viivitus peegeldub ka juhuslikult võrgu stäkis. Tõepoolest on märgata, et cadvisor kasutab rohkem protsessori aega, kui oodatud, kuid sellele ei pööratud erilist tähelepanu, kuna meie serveritel on palju protsessorivõimsust, seega ei uuritud probleemi põhjalikult.
Probleem seisneb selles, et kontrollrühmad (cgroups) arvestavad mälukasutust nimespetsiifilises (konteineris). Kui kõik protsessid selles cgroupis lõpetavad, vabastab Docker mälukontrollrühma. Kuid "mälu" ei ole lihtsalt protsessi mälu. Kuigi protsesside mälu ei ole enam kasutuses, selgub, et tuum määrab veel vahemälu sisu, nagu dentrid ja inode'id (kataloogide ja failide metaandmed), mis on vahemälu memory cgroupis. Probleemi kirjeldusest:
cgroups-zombid: kontrollerühmad, mis ei sisalda protsesse ja on eemaldatud, kuid millele on endiselt eraldatud mälu (minu juhul dentry vahemälust, kuid see võib samuti tulla lehe vahemälust või tmpfs-lt).
Tuuma kontrollimine kõigi lehtede puhul vahemälus cgroupi vabastamisel võib olla väga aeglane, seetõttu valitakse laisk protsess: oodata, kuni need lehed uuesti küsitakse, ja alles siis, kui mälu on tõeliselt vajalik, lõpuks cgroup puhastada. Enne seda hetke arvestatakse cgroupi ikka veel statistika kogumisel.
Tulemuslikkuse osas ohverdasid nad mälu tõhususe nimel: esialgne tühjendus kiirenes vähese vahepealse mälu arvelt. See on normaalne. Kui südamik kasutab viimast osa vahepealsest mälust, tühjendatakse cgroup lõpuks, seega ei saa seda pidada "lekkele". Kahjuks toob selle tuuma (4.9) otsingumehhanismi konkreetne teostus koos tohutu mäluhulgaga meie serverites kaasa selle, et viimaste vahepealsete andmete taastamiseks ja cgroup-zombi puhastamiseks kulub palju rohkem aega. memory.stat Selgub, et mõnel meie sõlmel oli nii palju cgroup-zombies, et lugemine ja latentsus ületasid sekundi.
Cadvisor'i probleemi ümbersõiduks on koheselt vabastada dentries/inodes mälu kogu süsteemis, mis eemaldab viivituse lugemisel ja samuti võrgu latentsuse hostis, kuna vahepealse mälu eemaldamine hõlmab ka cgroup-zombi vahepealseid lehti, mis vabastatakse samuti. See ei ole lahendus, kuid kinnitab probleemi põhjust.
Tuli välja, et uuemates tuuma versioonides (4.19+) on väljundite tõhusus parem, seega üleminek sellele tuumale eemaldas probleemi. Samuti oli meil vahendid probleemsete sõlmede tuvastamiseks Kubernetes'i klastrites, nende elegantseks väljavõtmiseks ja taaskäivitamiseks. Käisime kõik klastrid läbi, leidsime sõlmed, mille latentsus oli piisavalt kõrge, ja taaskäivitasime nad. See andis meile aega operatsioonisüsteemi uuendamiseks teistel serveritel.
Kuna see tõrge peatas NIC RX järjekordade töötlemise saatmiseks sadu millisekundeid, põhjustas see samal ajal suurt latentsust lühikestes ühendustes ja latentsust ühenduse keskel, näiteks MySQL päringute ja vastuspakettide vahel. memory.statKubernetes'i kõige põhivõrkude tõhususe mõistmine ja toetamine on kriitilise tähtsusega kõikide nende põhjal toimivate teenuste usaldusväärsuse ja kiirus. Kubernetes'i tõhususe parendamised toovad kasu kõigile käivitatavatele süsteemidele.
Kokkuvõtteks
🥇Silmusme parandamine Kubernetes'is | ProHoster
🥇 Veaotsing võrgu viivitustes Kubernetesis | ProHoster
Allikas: habr.com
