

Märkus tõlke kohta.: artikli autor (Luc Perkins) — CNCF-i arendaja toetaja, mis on koduks avatud lähtekoodiga projektidele nagu Linkerd, SMI (Service Mesh Interface) ja Kuma (muide, kas olete kunagi mõelnud, miks see nimekiri ei sisalda Istio?..). Korrates enda katset tuua DevOps kogukonda paremat arusaamist trendist, mida nimelt nimetatakse „teenuse võrguks“, toob ta välja 16 iseloomulikku omadust, mida sellised lahendused pakuvad.
Täna ― üks kuumemaid teemasid tarkvaraarenduses (ja see on täiesti õigustatud!). Ma pean seda tehnoloogiat uskumatult paljutõotavaks ja unistan, et saan näha selle laialdast levikut (loomulikult, kui see on mõistlik). Siiski on see enamikule inimestele endiselt ümbritsetud müstilisuse auraga. Samuti isegi need, kes on hästi tuttavad sellega, tihtipeale raskendavad selle eeliste ja sisu sõnastamist (sealhulgas teie alandlik teenija). Artiklis püüan olukorda parandada, loetledes erinevad kasutusstsenaariumid „teenuse võrkude“*.
* Märk. tõlk.: siin ja edaspidi artiklis kasutatakse just sellist tõlget („teenuse võrk“) endiselt uue termini service mesh jaoks.
Kuid enne tahtsin märkida mõningaid asju:
- Ma pole kunagi töötanud teenuse võrkudega ja pole neid kasutanud väljaspool projekte, mis on loodud minu hariduse nimel. Teisest küljest olen just mina kirjutanud hulga dokumentatsiooni Twitteri ettevõtte sise-teenuse võrgu kohta 2015. aastal (toona ei olnud see isegi veel „teenuse võrk“ nagu nimetud) ja osalenud veebisaidi ja dokumentatsiooni arenduses , nii et see tähendab midagi.
- Minu nimekiri on umbkaudne ja mitte täielik. On täiesti võimalik, et mulle on tundmatud kasutusstsenaariumid, ja ajaga kindlasti tekivad uued variandid, kui tehnoloogia areneb ja selle populaarsus suureneb.
- Samas ei toeta kaugelki iga olemasolev teenuse võrgu rakendus kõiki nimetatud kasutusjuhtumeid. Seega tuleks minu väljendeid, nagu „teenuse võrk võib…“, lugeda kui „individuaalsed, ja võib-olla kõik populaarsed teenuse võrgu rakendused võivad…“.
- Näidete järjekord ei oma mingit tähtsust.
Lühike nimekiri:
- teenuste avastamine;
- krüpteerimine;
- autentimine ja autoriseerimine;
- koormuse tasakaalustamine;
- circuit breaking;
- automaatne skaleerimine;
- kanarikülgede rakendused;
- sinine-roheline rakendused;
- olekute kontroll;
- koormuse vähendamine;
- liikluse peegeldamine;
- isoleerimine;
- päringute kiiruspiiramine, korduvad katsed ja ajaks;
- telemeetria;
- auditeerimine;
- visualiseerimine.
1. Teenuste avastamine
TL;DR: Ühendage võrgu teised teenused lihtsate nimede abil.
Teenustel peab olema võimalus automaatselt üksteist 'leida' sobivate nimede kaudu — näiteks, service.api.production, pets/staging või cassandra. Pilveteenused on tuntud oma paindlikkuse poolest, ja ühe nime taga võib olla mitu teenuse eksemplari. Selge on, et sellises olukorras on füüsiliselt võimatu kõiki IP-aadresse kõvakoodida.
Lisaks, kui üks teenus leiab teise, peab tal olema võimalus sellele teenusele päringuid saata, kartmata, et need jõuavad selle mitte töötava eksemplari juurde. Teisisõnu, service mesh peab jälgima kõigi teenuse eksemplaride töökindlust ja hoida hostide nimekirja maksimaalselt ajakohasena.
Iga service mesh rakendab teenuste avastamise mehhanismi omal moel. Praegu on kõige levinum meetod delegeerida see välistele protsessidele nagu DNS Kubernetes. Varem kasutasime Twitteris nende eesmärkide saavutamiseks nimede süsteemi . Lisaks võimaldab service mesh tehnoloogia kasutajate nimetamismehhanismide loomise (kuigi ma pole veel kohanud ühtegi SM-i rakendust, kus seda funktsiooni oleks rakendatud).
2. Krüptimine
TL;DR: Vabanege krüpteerimata liiklusest teenuste vahel ning laske sellel protsessil olla automatiseeritud ja skaleeritav.
On meeldiv mõelda, et kurjategijad ei saa teie sisemisse võrku tungida. Datanäidikud teevad selle üsna hästi. Kuid mis juhtub, kui häkker siiski sisse pääseb? Kas ta saab teha kõike, mida soovib sisese teenuste liiklusega? Lootkem, et see ei juhtu. Sellise stsenaariumi vältimiseks tuleks rakendada null-usaldusvõrku (zero-trust), kus kogu teenuste vahel liikuv liiklus on krüpteeritud. Enamik kaasaegseid teenuste võrke saavutab selle vastastikuse (mutual TLS, mTLS) abil. Mõningatel juhtudel töötab mTLS terve cloudides ja klastrites (ma arvan, et ka planeetidevahelised suhtlused on kunagi sarnased).
Kui muidugi, mTLS service mesh ei ole kohustuslik. Iga teenus saab ise hoolitseda oma TLS-i eest, kuid see tähendab, et tuleb leida viis sertifikaatide genereerimiseks, nende jagamiseks teenuse hostide vahel ning rakendusse koodi lisamiseks, mis laadib need sertifikaadid failidest. Ja ärge unustage sertifikaatide ajakohastamist teatud ajavahemike järel. Teenusete võrgud automatiseerivad mTLS-i selliste süsteemide abil nagu , mis omakorda automatiseerivad sertifikaatide väljastamise ja rotatsiooni protsessi.
3. Autentimine ja autoriseerimine
TL;DR: Määrake, kes on päringu algataja, ja määratlege, mida tohib tal teha, veel enne, kui päring jõuab teenuseni.
Teenused tahavad sageli teada, kes kes teeb päringu (autentimine), ning kasutades seda teavet, otsustavad, mida kas sellele subjektile on lubatud teha (autoriseerimine). Antud juhul võib `kes` asemele tulla:
- Teised teenused. Seda nimetatakse "peer'i" autentimiseks. ". Näiteks teenustahab pääseda teenusele
webdb. Teenuse võrgud lahendavad sarnaseid probleeme tavaliselt mTLS-i kaudu: sertifikaadid on antud juhul olulise identifikaatorina.Mõned inimesed kasutajad. Seda nimetatakse "päringu" autentimiseks. - ". Näiteks kasutaja haxor69soovib osta uut lampi. Teenuse võrgud pakuvad erinevaid mehhanisme, näiteks
JSON Web Token'id.Paljude meist on tulnud seda rakenduse koodis teha. Tuleb päring, vaatame andmebaasi .jne. Teenuse võrgus toimub see veel enne, kui päring teenuseni jõuab.
usersPärast seda, kui oleme kindlaks teinud, kellelt päring tuli, tuleb määrata, mida sellele subjektile on lubatud teha. Mõned teenuse võrgud võimaldavad määrata põhipoliitika (kes ja mida tohib teha) YAML-failide või käsurea kaudu, samas kui teised pakuvad integreerimist raamistikudega nagupermissions. Lõppeesmärk on saavutada, et teie teenused võtaksid vastu kõiki päringuid, julgelt eeldades, et need pärinevad usaldusväärsest allikast.
see toiming on lubatud. 4. Koormuse jaotamine ja TL;DR: Jagage koormust teenuse eksemplaride vahel kindla mustriga.
4. Koormuse jaotamine
TL;DR: Jagage koormust teenuse eksemplaride vahel kindla mustri järgi.
Teenuset, mis kuuluvad teenuse sektori koosseisu, koosnevad sageli paljusid identsetest eksemplaridest. Näiteks täna koosneb teenus 5 koopiast, kuid homseks võib nende arv tõusta 11-ni. Palve, mis suunatakse cache , tuleks jaotada vastavalt kindlale eesmärgile. Näiteks minimeerida viivitust või maksimeerida tõenäosust, et jõuda töötava eksemplarini. Kõige sagedamini kasutatakse ringja teenindusmeetodit (Round-robin), kuid on ka palju muid — näiteks kaalutud cache(weighted) palveid (saab valida eelistatud sihid), ringkasutamine (ring) hashimine (kasutades kooskõlastatud hashimist upstream-hostide jaoks) või väheseima arvu päringute meetod (eelistatakse eksemplari, millel on kõige vähem päringuid). Klassikalistel tasakaalustajatel on ka teisi funktsioone, nagu HTTP va cache ja DDoS kaitse, kuid need ei ole väga olulised east-west tüüpi liikluse puhul (st liikluse puhul, mis liikumisel on andmekeskuse piires — tõlkija märkus) (teenuse mesh tüüpiline rakendusala). Loomulikult ei ole teenuse mesh kasutamine koormuse tasakaalustamiseks vajalik, kuid see võimaldab määrata ja kontrollida tasakaalustamisstrateegiaid iga teenuse jaoks kesksetelt halduskihtidelt, elimineerides vajaduse käivitada ja seadistada eraldi tasakaalustajaid võrgu kihis.
5. Tsükli katkestamine (circuit breaking)
TL;DR: Peata liiklus probleemse teenuse poole ja kontrolli kahju halvimatel juhtudel.
Kui mingil põhjusel teenus ei suuda liiklust hallata, pakub teenuse mesh mitmeid lahendusi sellele probleemile (teistest räägitakse vastavates osades). Tsükli katkestamine on kõige rangem variant teenuse liiklusest väljalülitamiseks. Kuid see üksi pole mõttekas — on vajalik varuplaan. Võib ettenäha tagasilööki
backpressure () Teenuse mesh'id võimaldavad mitte ainult määrata,
millal väljalülitamine toimub ja järgneb väljalülitamine ja mida selle järgneb. Sellisel juhul võib "millal" hõlmata mistahes määratud parameetrite kombinatsiooni: üldine arv päringuid teatud aja jooksul, samaaegsete ühenduste arv, ootel päringud, aktiivsed uuesti katsetamised jne.
Te tõenäoliselt ei soovi circuit breaking'ut kuritarvitada, kuid on hea teada, et äärmuslikuks juhuks on olemas varuplaan.
6. Automaatne skaleerimine
TL;DR: Suurendage või vähendage teenuse eksemplaride arvu sõltuvalt määratud kriteeriumidest.
Teenuse mesh’id ei ole planeerijad, seega nad ei teosta skaleerimist iseseisvalt. Kuid nad saavad edastada teavet, mille põhjal planeerijad otsuseid teevad. Kuna teenuse mesh’id pääsevad ligi kogu teenuste vahelisele liiklusele, omavad nad ulatuslikku teavet selle kohta, mis toimub: millised teenused on probleemides, millised on täielikult alakoormatud (neile eraldatud ressursid jäävad kasutamata) jne.
Näiteks Kubernetes skaleerib teenuseid vastavalt pod’ide CPU ja mälu kasutusele (vt meie ettekannet «» — tõlkija märkus), kuid kui otsustate skaleerida mis tahes muude näitajate alusel (meie puhul — liiklusega seotud), on vajalik eraldi mõõdik. Juhend näitab, kuidas seda teha , ja , kuid ise protsess on üsna keeruline. Me sooviksime, et teenuse mesh seda lihtsustaks, võimaldades lihtsalt määrata tingimused nagu „suurenda teenuse eksemplaride arvu, auth, kui ootel päringute arv ületab künnise väärtuse ühe minuti jooksul.“
7. Kanaride juurutamine
TL;DR: Testige uusi funktsioone või teenuse versioone väikese kasutajate alamhulga peal.
Oletat, et arendad mingit SaaS-projekti ja soovid välja tuua selle uue ägeda versiooni. Oled seda testinud stagingus ja see töötab suurepäraselt. Kuid siiski on sul teatavad mured selle käitumise osas reaalses keskkonnas. Teisisõnu, tuleb uut versiooni testida reaalsete ülesannete peal, riskimata samas kasutajate usaldusväärsusega. Kanarade juurutamised sobivad selleks suurepäraselt. Need võimaldavad demonstreerida uut funktsiooni teatud alamhulgale kasutajatest. See alamhulk võib koosneda kõige lojaalsematest kasutajatest või nendest, kes töötavad tasuta versiooniga, või kasutajatest, kes on väljendanud soovi olla "katsealuste" seas.
Teenuse struktuurid teostavad seda, võimaldades määrata kriteeriume, mis määravad, kes ja millist rakenduse versiooni näeb, ning suunavad liiklust vastavalt. Samas ei muutu teenuste enda jaoks midagi. Versioon 1.0 teenusest usub, et kõik päringud tulevad kasutajatelt, kes just seda versiooni peaksid nägema, ja versioon 1.1 arvab sama omadest oma kasutajatest. Ja samal ajal saad sa muuta liikluse protsenti vana ja uue versiooni vahel, suunates kasvavat arvu kasutajaid uuele, kui see töötab stabiilselt ja sinu "katsealused" annavad heakskiidu.
8. Sinine-rohelised juurutamised
TL;DR: Väljalase uus äge funktsioon, kuid ole valmis kõik tagasi tooma.
Mõte on juurutada uus "sinine" teenus, käivitades selle paralleelselt vana "roheline" teenusega. Kui kõik läheb sujuvalt ja uus teenus tõestab end hästi, siis saab vana järk-järgult välja lülitada. (Kahjuks kordab ühel päeval ka see uus "sinine" teenus "roheline" teenuse saatust ja kaob…) Sinised ja rohelised juurutamised erinevad kanarade juurutamistest, kuna uus funktsioon katab kõiki kasutajaid (mitte osa); mõte on siin see, et olla valmis "varusadamaks", kui midagi läheb valesti.
Teenuse mesh'id pakuvad väga mugavat viisi 'sinise' teenuse testimiseks ja viivitamatuks üleminekuks 'roheline', kui ilmnevad probleemid. Rääkimata sellest, et nad annavad hulga teavet (vt allpool punkti 'Telemeetria') 'sinise' töö kohta, mis aitab mõista, kas see on täielikult kasutamiseks valmis.
Märkus tõlke kohta.: Erinevate Kubernetes'i juurutamisstrateegiate (sealhulgas mainitud canary, blue/green ja teiste) kohta saab lugeda .
9. Tervisekontroll
TL;DR: Jälgige, millised teenuse eksemplarid on töövõimelised, ja reageerige neile, mis ei ole.
Tervisekontroll (health check) aitab otsustada, kas teenuse eksemplarid on valmis liiklust vastu võtma ja töötlema. Näiteks HTTP-teenuste puhul võib tervisekontrolli mude olla GET-päring teatud endpoint'ile. /health. Vastus 200 OK tähendab, et eksemplar on terve, mistahes muu tähendab, et see ei ole valmis liiklust vastu võtma. Teenuse mesh'id võimaldavad määrata, kuidas töökindlust kontrollitakse, ja selle sageduse, kui sageli see kontroll toimub. Seda teavet saab seejärel kasutada ka muudel eesmärkidel - näiteks koormuse tasakaalustamiseks ja circuit breaking'uks.
Seega, tervisekontroll ei ole iseseisev kasutusstsenaarium, vaid seda kasutatakse tavaliselt muude eesmärkide saavutamiseks. Samuti, sõltuvalt tervisekontrolli tulemustest, võivad olla vajalikud välised (seoses muude teenuse mesh'ide eesmärkidega) tegevused: näiteks oleku lehe värskendamine, GitHubis küsimuse loomine või JIRA-s pileti täitmine. Ja teenuse mesh pakub selle automatiseerimiseks mugavat mehhanismi.
10. Koormuse vähendamine (load shedding)
TL;DR: Suunake liiklust ümber ajutise kasutuse suurenemise korral.
Kui mõni teenus on liiklusest üle koormatud, saate ajutiselt suunata osa sellest liiklusest teise kohta (st 'vabastada', 'üle kanda' (shed) see sinna). Näiteks varu teenusesse või andmekeskusesse, või pidevasse Teema. Selle tulemusena jätkab teenus osade päringute töötlemist, selle asemel et kokku kukkuda ja lõpetada kõiki päringute töötlemine. Koormuse vabastamine on eelistatum kui ahel katkestamine, kuid siiski ei tohiks seda kuritarvitada. See aitab vältida ahelreaktsioone, mille tulemusena kukuvad allapoole suunatud teenused.
11. Paraleliseerimine/Traffic mirroring
TL;DR: Saatke üks päring korraga mitmesse kohta.
Mõnikord on vajalik saata päring (või teatud valik päringute vahel) korraga mitmesse teenusesse. Iseloomulik näide on osa tootmistrafikust saatmine katsetamisteenusele. Tootmisveebiserver saadab päringu allolevale teenusele products.production ja ainult sellele. Teenuste võrk kopeerib selle päringu nutikalt ja saadab selle edasi products.staging, millest veebiserver isegi ei kahtlustagi.
Veel üks seotud teenuste võrgustiku kasutuse võimalik stsenaarium, mida saab ellu viia paralleelsete trafiku haldamise üle, on . See hõlmab samade päringute saatmist erinevatele teenuse versioonidele ja kontrollimist, kas kõik versioonid käituvad ühtmoodi. Ma ei ole veel kohanud teenuste võrku integreeritud tagasiside testimise süsteemiga nagu , kuid idee ise tundub paljutõotav.
12. Isolatsioon
TL;DR: Jagage oma teenuste võrgu mini-võrkudeks.
Tuntud ka kui segmentatsioon, isolatsioon on kunst jagada teenuste võrk loogiliselt eraldatud segmentideks, mis ei tea üksteisest midagi. Isolatsioon on mõneti sarnane virtuaalsete eravõrkude loomisele. Peamine erinevus on see, et saate endiselt kasutada kõiki teenuste võrgu eeliseid (nagu teenuste avastamine), kuid lisanduva turvalisusega. Näiteks, kui kurjategija suudab tungida teenusesse ühes alamvõrgus, ei saa ta näha, millised teenused töötavad teistes alamvõrkudes, ega nende liiklust peata.
Lisaks võivad eelised olla ka organisatsioonilised. Võib-olla soovite jagada teenuseid alamvõrkudeks, sõltuvalt ettevõtte struktuurist ja vabastada arendajad kognitiivsest koormast, mis tuleneb vajadusest meeles pidada kogu teenuste võrku.
13. Päringute sageduse piiramine, uuesti proovimine ja ajutaktid
TL;DR: Pole enam pea koodibaasi lisama tõhusaid päringute haldamise ülesandeid.
Kõiki neid asju võiks käsitleda kui eraldi kasutusjuhtumeid, kuid otsustasin need kombineerida ühe ühise omaduse tõttu: nad võtavad endale päringute elutsükli haldamise ülesandeid, mis tavaliselt on rakenduste raamatukogude kohustus. Kui arendate Ruby on Rails veebiserverit (mis ei ole integreeritud teenuste võrgustikuga), mis teeb päringuid taustteenustele läbi , peab rakendus ise otsustama, mida teha, kui N päringut ebaõnnestub. Samuti tuleb välja selgitada, kui palju liiklust need teenused suudavad töödelda ja 'hardcode' need parameetrid spetsiaalse raamatukogu abil. Veelgi enam, rakendus peab otsustama, millal on aeg loobuda ja lasta päringul aeguda (timeout). Kõigi ülaltoodud parameetrite muutmiseks tuleb veebiserver peatada, uuesti konfigureerida ja uuesti käivitada.
Selliste ülesannete edastamine teenuste võrgustikku tähendab mitte ainult seda, et teenuste arendajad ei pea nende pärast muretsema, vaid ka seda, et neid saab vaadata globaalsetest vaatenurkadest. Kui on keeruline teenuste ahel, näiteks A → B → C → D → E, tuleb arvestada kogu päringu elutsükliga. Kui on eesmärk pikendada teenuse C timeout'e, on loogiline seda teha korraga, mitte osade kaupa: uuendades teenuse koodi ja oodates, kuni tõmmispäring on vastu võetud ja CI-süsteem käivitab uuendatud teenuse.
14. Telemeetria
TL;DR: Koguge kogu vajalik (ja mitte nii vajalik) teave teenustelt.
Telemeetria on üldtermín, mis hõlmab metrikate, jaotatud jälgimise ja logide kogumist. Teenuste võrgustikud pakuvad mehhanisme kolme erineva andmetüübi kogumiseks ja töötlemiseks. Siin muutub asi veidi ebamugavaks, kuna võimalike variantide arv on liiga suur. Metrikate kogumiseks on ja teisi tööriistu, logide kogumiseks võib kasutada , , ja palju muud. (näiteks ClickHouse meie K8s jaoks — tõlke märk.), jaotatud jälgimise jaoks on jne. Iga teenuste võrgu struktuur võib toetada ühte tööriista ja mitte toetada teisi. Huvitav on näha, kas projekt suudab tagada mingit konvergentsi.
Antud juhul on service meshi tehnoloogia eelis see, et sidecar-konteinerid saavad põhimõtteliselt koguda kõik ülalnimetatud andmed oma teenustest. Teisisõnu, teil on käsutuses ühtne telemeetria kogumise süsteem ja service mesh suudab seda teavet erinevate meetoditega töödelda. Näiteks:
- logida mõne teenuse logisid CLI-s;
- jälgida päringute mahtu service meshi juhtpaneelilt;
- koguda jaotatud jälgimisi ning suunata need süsteemi nagu Jaeger.
Pane tähele, subjektiivne arvamus: Üldiselt on telemeetriaga tegelemine ala, kuhu teenusvõrgu tugev sekkumine on soovimatu. Alusinfo kogumine ja mõnede 'kuldsete mõõdikute', nagu eduka päringu protsent ja viivitused, jälgimine on normaalne, kuid loodame, et me ei saa tunnistajaks Frankensteini stekkide tekkimisele, mis püüavad asendada spetsialiseeritud süsteeme, millest mõned on end juba hästi tõestanud ja on hästi uuritud.
15. Audit
TL;DR: Kes unustab ajaloo õppetunnid, on hukule määratud need kordama.
Audit on kunst jälgida olulisi sündmusi süsteemis. Service meshi puhul võib see tähendada jälgimist, kes on teinud päringuid konkreetsetele endpoint'idele teatud teenustes või kui mitu korda on viimase kuu jooksul toimunud mingisugune sündmus, mis on seotud turvalisusega.
On selge, et audit on väga tihedalt seotud telemeetriga. Erinevus seisneb siiski selles, et telemeetriat seostatakse tavaliselt selliste asjadega nagu jõudlus ja tehniline täpsus, samas kui audit võib käsitleda õiguslikke ja muid küsimusi, mis ulatuvad väljapoole rangelt tehnilist sfääri (nt GDPR-i – Euroopa Liidu isikuandmete kaitse määruse – nõuetele vastavus).
16. Visualiseerimine
TL;DR: Elagu React.js – vääritu allikas veidratest liidestest.
Võib-olla on sobivam termin, kuid mina ei tea seda. Pean silmas service meshi või selle komponentide graafilist esitamist. Need visualiseerimised võivad sisaldada näidikuid, nagu keskmised viivitused, sidecar-konteinerite konfigureerimise teave, tervisekontrollide tulemused ja teated.
Töö teeninduspõhises keskkonnas kaasneb palju tugevama kognitiivse koormusega võrreldes Tema Majesteedi Monoliidiga. Seetõttu tuleks kognitiivset survet vähendada igal võimalikul moel. Tavaline graafiline liides service mesh'ile, kus saab nupule klikata ja soovitud tulemus kätte saada, võib olla otsustava tähtsusega selle tehnoloogia populaarsuse kasvule.
Ei kuulunud nimekirja
Alguses kavatsesin nimekirja lisada veel paar kasutusjuhtu, kuid otsustasin seda mitte teha. Siin nad on koos minu otsuse põhjustega:
- Mitme andmekeskuse. Minu arvates ei ole see niivõrd kasutusjuht kui pigem kitsas ja konkreetne teenindusvõrkude rakendamine või teatud funktsioonide kogum, nagu teenuste avastamine.
- Ingress ja egress. See on seotud valdkond, kuid piirdusin (võib-olla kunstlikult) kasutusjuhuga „east-west” liiklus. Ingress ja egress väärivad eraldi artiklit.
Kokkuvõte
Sellega on hetkeks kõik! Jällegi, see nimekiri on väga tinglik ja tõenäoliselt mitteni. Kui arvate, et midagi jäi puudu või eksisin milleski, võtke mind Twitteris (). Palun järgige etiketti.
P.S. tõlkijalt
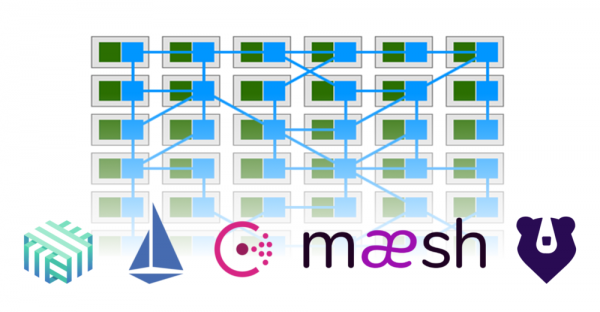
Artikli pealkirja illustratsiooni aluseks on pilt artiklist „“ (autor — Gregory MacKinnon). Sel on näidatud, kuidas osa rakenduste funktsionaalsusest (roheline) on üle läinud service mesh'ile, mis tagab nende vahelised ühendused (sinine).
Lugege ka meie blogist:
- «»;
- «»;
- «».
Allikas: habr.com
