

Kube-scheduler on Kubernetesi lahutamatu komponent, mis vastutab podide planeerimise eest sõlmedele vastavalt määratud poliitikatele. Sageli ei pea me Kubernetes-klastrit kasutades muretsema, milliste poliitikate alusel podid planeeritakse, kuna vaikimisi kube-scheduler'i poliitikakomplekt sobib enamikuks igapäevaseks tööks. Siiski on olukordi, kus on oluline peenelt juhtida podide jaotamise protsessi, ja selle saavutamiseks on kaks teed:
- Loo kube-scheduler kohandatud reeglite kogumiga
- Kirjuta oma enda scheduler ja õpeta seda tööle API-serveri päringutega
Käesolevas artiklis tutvustan ma just esimese punkti elluviimist, et lahendada podide ebaühtlase planeerimise probleem ühes meie projektist.
Lühike sissejuhatus kube-scheduler'i tööle
On oluline märkida, et kube-scheduler ei vastuta podide otsese planeerimise eest — ta vastutab ainult sõlme määramise eest, kuhu pod peaks paigaldama. Teisisõnu, kube-scheduler'i töö tulemus on sõlme nimi, mille ta tagastab API-serverile planeerimispäringu peale ja sellega tema töö lõppeb.
Esmalt koostab kube-scheduler nimekirja sõlmedest, kuhu pod saab vastavalt predicates poliitikatele planeerida. Järgmiseks saab iga see nimekirja kuuluv sõlm teatud arvu punkte vastavalt priorites poliitikatele. Tulemuseks valitakse sõlm, mis on saanud maksimaalse punktide arvu. Kui mitmed sõlmed on saanud sama maksimaalse skoori, valitakse neist juhuslikult. Predicates (filterimise) ja priorites (punkte andmine) poliitikate loendit ja kirjeldust saab tutvuda .
Probleemi kirjeldus
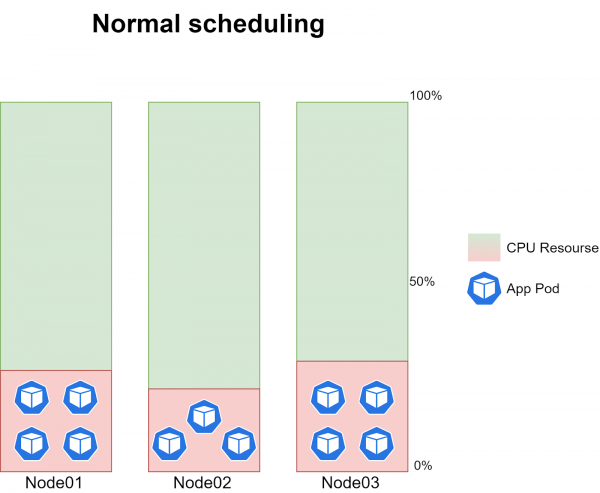
Vaatamata sellele, et meil on Nixysis hoolduses palju erinevaid Kubernetes klastreid, kohtasime podide planeerimise probleemiga esmakordselt alles hiljuti, kui ühes meie projektis tekkis vajadus käivitada suur hulk perioodilisi ülesandeid (~100 CronJob'i üksust). Probleemi kirjeldamise maksimaalselt lihtsustamiseks võtame näiteks ühe mikroteenuse, mille raames käivitatakse iga minut cron-ülesanne, mis tekitab teatud koormuse CPU-le. Cron-ülesannete jaoks on eraldatud kolm täiesti identset sõlme (igal 24 vCPU).
Siiski ei saa täpselt öelda, kui kaua CronJob kestab, kuna sisendandmete maht muutub pidevalt. Keskmiselt töötab normaalses kube-scheduler'i töös igas sõlmes 3-4 tööülesande koopia, mis tekitavad ~20-30% koormust iga sõlme CPU-le:
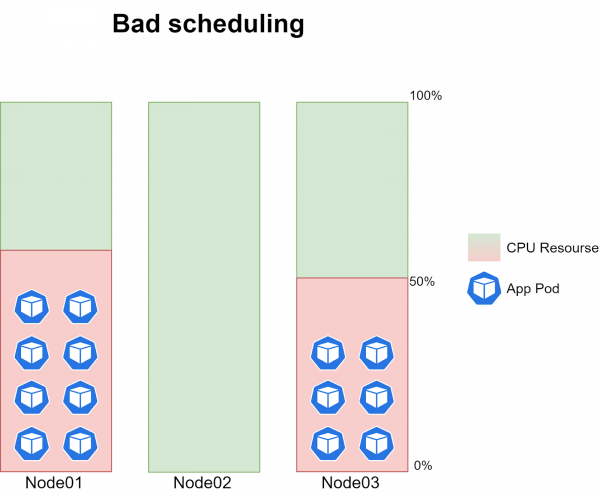
Probleem seisneb selles, et mõnikord ei plaanitud cron-ülesannete pod'e ühele kolmest sõlmest. See tähendab, et mingil ajahetkel ei plaanitud ühtegi pod'i ühte sõlme, samas kui kahes teises sõlmes töötas 6-8 tööülesande koopia, tekitades ~40-60% koormust CPU-le:
Probleem kordus täiesti juhuslike ajavahemike järel ja harva korreleerus uue koodiversiooni väljalaskmise hetkega.
Tõstes kube-scheduler'i logimise taseme 10 tasemeni (-v=10), hakkasime registreerima, kui palju punkte iga sõlm hindamise protsessis kogub. Normaalses planeerimiselogi töös võis logides näha järgmist teavet:
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1387 millicores 4161694720 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1347 millicores 4444810240 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node03: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1387 millicores 4161694720 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1687 millicores 4790840320 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node02: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1347 millicores 4444810240 memory bytes, score 9
resource_allocation.go:78] cronjob-1574828880-mn7m4 -> Node01: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1687 millicores 4790840320 memory bytes, score 9
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: NodeAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node01: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: TaintTolerationPriority, Score: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node02: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node01: SelectorSpreadPriority, Score: (10)
interpod_affinity.go:237] cronjob-1574828880-mn7m4 -> Node03: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node02: SelectorSpreadPriority, Score: (10)
selector_spreading.go:146] cronjob-1574828880-mn7m4 -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574828880-mn7m4_project-stage -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:781] Host Node01 => Score 100043
generic_scheduler.go:781] Host Node02 => Score 100043
generic_scheduler.go:781] Host Node03 => Score 100043
Seega, lähtudes logidest saadud infost, kogusid kõik soliidid võrdselt lõpp-punkte ja juhuslikult valiti üks neist planeerimiseks. Probleemse planeerimise hetkel nägid logid välja järgmiselt:
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1587 millicores 4581125120 memory bytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1087 millicores 3532549120 memory bytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node02: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1587 millicores 4581125120 memory bytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: BalancedResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 987 millicores 3322833920 memory bytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node01: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 987 millicores 3322833920 memory bytes, score 9
resource_allocation.go:78] cronjob-1574211360-bzfkr -> Node03: LeastResourceAllocation, capacity 23900 millicores 67167186944 memory bytes, total request 1087 millicores 3532549120 memory bytes, score 9
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node03: InterPodAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node02: InterPodAffinityPriority, Score: (0)
interpod_affinity.go:237] cronjob-1574211360-bzfkr -> Node01: InterPodAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node03: SelectorSpreadPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: TaintTolerationPriority, Score: (10)
selector_spreading.go:146] cronjob-1574211360-bzfkr -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node03: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: TaintTolerationPriority, Score: (10)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node02: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: NodeAffinityPriority, Score: (0)
generic_scheduler.go:726] cronjob-1574211360-bzfkr_project-stage -> Node01: SelectorSpreadPriority, Score: (10)
generic_scheduler.go:781] Host Node03 -> Score 100041
generic_scheduler.go:781] Host Node02 -> Score 100041
generic_scheduler.go:781] Host Node01 -> Score 100038
Nendest, et üks nodidest kogus vähem lõpp-punkte kui teised, ja seetõttu kavandati töötlemine ainult kahe nodi peale, mis said maksimaalsed punktid. Nii saime kindlalt veenduda, et probleem on seotud just podide kavandamisega.
Edasi liikumine probleemilahendamise algoritmiga oli meile selge — analüüsida logisid, mõista, millise prioriteedi tõttu nod ei kogunud punkte ja vajadusel kohandada vaikimisi kube-scheduler'i poliitikaid. Kuid siin seisime silmitsi kahe olulise väljakutsega:
- Maksimaalsel logimise tasemel (10) kajastatakse punkte ainult mõnede prioriteetide kohta. Ülaltoodud logide lõigus võib näha, et kõigi logides kajastatud prioriteetide osas koguvad nodid normaalsete ja probleemsete kavandamiste korral võrdselt punkte, kuid probleemsete kavandamiste lõpp-tulemus on erinev. Seega võib järeldada, et mõnede prioriteetide osas toimub punktide arvutamine „kaadrivälisel” viisil ning meil ei ole mingit võimalust mõista, millise prioriteedi osas nod punkte ei kogunud. Seda probleemi oleme põhjalikult kirjeldanud Kubernetes'i repozitooriumis GitHubis. Artikli kirjutamise hetkel oli välja saadud arendajate vastus, et logimise toetamine lisatakse Kubernetes v1.15, v1.16 ja v1.17 uuendustes.
- Ei ole lihtsat viisi mõista, millise konkreetse poliitika kogumiga töötas kube-scheduler hetkel. Jah, see nimekiri on loetletud, kuid seal puudub teave, millised konkreetsed kaalud on igale prioriteedile määratud. Näha kaalu või redigeerida vaikimisi kube-scheduler'i poliitikaid saab vaid Oluline on märkida, et korra õnnestus meil fikseerida, et nod ei kogunud punkte ImageLocalityPriority poliitika alusel, mis annab punktid nodile, kui tal on juba olemas pilt, mis on vajalik rakenduse käivitamiseks. St, uue rakenduse versiooni käivitamise hetkel suutis cron-ülesanne käivituda kahel nodil, tõmmates neile uue pildi docker registry'lt, ja seega said kaks nodi suurema lõpp-punktide arvu võrreldes kolmandaga. .
Oluline on märkida, et korra õnnestus meil fikseerida, et nod ei kogunud punkte ImageLocalityPriority poliitika alusel, mis annab punktid nodile, kui tal on juba olemas pilt, mis on vajalik rakenduse käivitamiseks. St, uue rakenduse versiooni käivitamise hetkel suutis cron-ülesanne käivituda kahel nodil, tõmmates neile uue pildi docker registry'lt, ja seega said kaks nodi suurema lõpp-punktide arvu võrreldes kolmandaga.
Nagu ma juba eespool mainisin, ei näe me logides teavet ImageLocalityPriority poliitika hindamise kohta, seega, et oma oletust kontrollida, kopeerisime uue versiooni rakenduse pildi kolmandale sõlmele, mille järel planeerimine töötas õigesti. Just ImageLocalityPriority poliitika tõttu ei olnud planeerimise probleemid piisavalt sageli, sagedamini olid need seotud millegi muuga. Kuna me ei saanud täielikult iga poliitikat, mis oli prioriteetide nimekirjas kube-scheduler'i vaikeseades, siluda, oli meil vaja paindlikku haldamist pod'ide planeerimise poliitikate osas.
Ülesande seadmine
Soovisime, et probleemide lahendamine oleks võimalikult spetsiifiline, see tähendab, et Kubernetes'e põhisüsteemid (siin mõeldakse vaikeseade kube-scheduler) peaksid jääma muutumatuks. Me ei soovinud probleemi lahendada ühes kohas, luues selle samas teises. Seega jõudsime kahele probleemilahenduse variandile, mida käsitleti artikli sissejuhatuses - lisa scheduler'i loomine või enda kirjutamine. Peamine nõue cron-ülesannete planeerimisel on koormuse ühtlane jaotamine kolme sõlme vahel. Seda nõuet saab rahuldada juba olemasolevate kube-scheduler'i poliitikatega, seega ei ole mõtet luua oma scheduler'it meie vajaduste rahuldamiseks.
Lisa kube-scheduler'i loomise ja juurutamise juhised on kirjeldatud . Kuid me arvasime, et Deployment'i entiteedid ei ole piisavad sellise kriitilise teenuse nagu kube-scheduler töö usaldusväärsuse tagamiseks, seega otsustasime juurutada uue kube-scheduler'i Static Pod'ina, mille üle jälgib otse Kubelet. Seega tõusid meie jaoks järgmised nõudmised uuele kube-scheduler'ile:
- Teenust tuleb juurutada Static Pod'ina kõigil klastrite meistritel
- Tugiteenus peab olema tagatud aktiivse kube-scheduler'i pod'i kätte saamata jätmisel
- Peamine prioriteet planeerimisel peab olema saadavalolevate ressursside hulk sõlmes (LeastRequestedPriority)
Lahenduse rakendamine
Tasub kohe märkida, et kõik tööd teeme Kubernetes v1.14.7-s, kuna just see versioon kasutati projektis. Alustame oma uue kube-scheduler'i manifesti kirjutamisest. Tuginedes vaikeseade manifestile ( /etc/kubernetes/manifests/kube-scheduler.yaml ) ja viime selle järgmisse vormi:
tüüp: Pod
metaandmed:
  sildid:
    komponent: scheduler
    tase: control-plane
  nimi: kube-scheduler-cron
  namespace: kube-system
spets:
      konteinerid:
      - käsk:
        - /usr/local/bin/kube-scheduler
        - --address=0.0.0.0
        - --port=10151
        - --secure-port=10159
        - --config=/etc/kubernetes/scheduler-custom.conf
        - --authentication-kubeconfig=/etc/kubernetes/scheduler.conf
        - --authorization-kubeconfig=/etc/kubernetes/scheduler.conf
        - --v=2
        pilt: gcr.io/google-containers/kube-scheduler:v1.14.7
        pildiTõmbepoliitika: IfNotPresent
        elujõudlusKontroll:
          ebaõnnestumiseKünnis: 8
          httpGet:
            host: 127.0.0.1
            tee: /healthz
            port: 10151
            skeem: HTTP
          algneViivitusSekundites: 15
          ajaÜksusSekundites: 15
        nimi: kube-scheduler-cron-konteiner
        ressursid:
          taotlused:
            cpu: '0.1'
        mahud:
        - mountPath: /etc/kubernetes/scheduler.conf
          nimi: kube-config
          ainultLugemiseks: true
        - mountPath: /etc/localtime
          nimi: localtime
          ainultLugemiseks: true
        - mountPath: /etc/kubernetes/scheduler-custom.conf
          nimi: scheduler-config
          ainultLugemiseks: true
        - mountPath: /etc/kubernetes/scheduler-custom-policy-config.json
          nimi: policy-config
          ainultLugemiseks: true
      hostNetwork: true
      prioriteediKlassiNimi: system-cluster-critical
      mahud:
      - hostPath:
          tee: /etc/kubernetes/scheduler.conf
          tüüp: FileOrCreate
        nimi: kube-config
      - hostPath:
          tee: /etc/localtime
        nimi: localtime
      - hostPath:
          tee: /etc/kubernetes/scheduler-custom.conf
          tüüp: FileOrCreate
        nimi: scheduler-config
      - hostPath:
          tee: /etc/kubernetes/scheduler-custom-policy-config.json
          tüüp: FileOrCreate
        nimi: policy-config
Peamised muudatused:
- Muutsime poda ja konteineri nime kube-scheduler-cron-iks
- Määrasime portide 10151 ja 10159 kasutamise, kuna on määratud valik
hostNetwork: trueja me ei saa kasutada samu porte nagu vaikimisi kube-scheduler (10251 ja 10259) - Parameetriga --config määrasime konfiguratsioonifaili, millega teenus käivitub
- Konfigureerisime konfiguratsioonifaili (scheduler-custom.conf) ja planeerimise poliitikafaili (scheduler-custom-policy-config.json) mountimise hostilt
Ärge unustage, et meie kube-scheduler vajab õigusi, mis on sarnased vaikeseadmetele. Muudame tema klasteroll:
kubectl edit clusterrole system:kube-scheduler...
resourceNames:
- kube-scheduler
- kube-scheduler-cron
...Nüüd räägime sellest, mis peaks olema konfiguratsioonifailis ja planeerimise poliitika failis:
- Konfiguratsioonifail (scheduler-custom.conf)
Vaikse kube-scheduler'i konfiguratsiooni saamiseks tuleb kasutada parameetrit--write-config-toAPI-s . Saadud konfiguratsioon paigutatakse faili /etc/kubernetes/scheduler-custom.conf ja viidatakse järgmisele kujule:
apiVersion: kubescheduler.config.k8s.io/v1alpha1
kind: KubeSchedulerConfiguration
schedulerName: kube-scheduler-cron
bindTimeoutSeconds: 600
clientConnection:
  acceptContentTypes: ""
  burst: 100
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /etc/kubernetes/scheduler.conf
  qps: 50
disablePreemption: false
enableContentionProfiling: false
enableProfiling: false
failureDomains: kubernetes.io/hostname,failure-domain.beta.kubernetes.io/zone,failure-domain.beta.kubernetes.io/region
hardPodAffinitySymmetricWeight: 1
healthzBindAddress: 0.0.0.0:10151
leaderElection:
  leaderElect: true
  leaseDuration: 15s
  lockObjectName: kube-scheduler-cron
  lockObjectNamespace: kube-system
  renewDeadline: 10s
  resourceLock: endpoints
  retryPeriod: 2s
metricsBindAddress: 0.0.0.0:10151
percentageOfNodesToScore: 0
algorithmSource:
   policy:
     file:
       path: "/etc/kubernetes/scheduler-custom-policy-config.json"
Peamised muudatused:
- Oleme määranud schedulerName'iks meie teenuse nime kube-scheduler-cron.
- Parameetris
lockObjectNametuleb samuti määrata meie teenuse nimi ja veenduda, et parameeterleaderElecton seatud väärtusele true (kui teil on üksainus põhivõti, võib väärtuse seada false). - Oleme määranud tee failini, kus on kirjeldatud planeerimise poliitikad parameetris
algorithmSource.
Tasub rohkem tähelepanu pöörata teisele punktile, kus me muutame parameetreid võtme leaderElection. Et tagada tõrgeteta toimimine, aktiveerisime (leaderElect) juhtivaks valimise protsessi meie kube-scheduler'i podide vahel, kasutades ühte neile mõeldud endpointi (resourceLock) nimega kube-scheduler-cron (lockObjectName) kube-system nimede ruumis (lockObjectNamespace). Kuidas Kubernetes tagab põhikomponentide (sealhulgas kube-scheduler'i) kõrge saadavuse, saab tutvuda .
- Planeerimise poliitika fail (scheduler-custom-policy-config.json)
Nagu ma varem mainisin — saame teada, milliste täpsete poliitikatega töötab vaikimisi kube-scheduler, analüüsides selle koodi. Seega ei saa me sarnaselt konfiguratsioonifailile saada faili vaikimisi kube-scheduler'i planeerimise poliitikatega. Kirjeldame meie jaoks huvipakkuvaid planeerimise poliitikaid failis /etc/kubernetes/scheduler-custom-policy-config.json järgmiselt:
{
  "kind": "Policy",
  "apiVersion": "v1",
  "predicates": [
    {
      "name": "GeneralPredicates"
    }
  ],
  "priorities": [
    {
      "name": "ServiceSpreadingPriority",
      "weight": 1
    },
    {
      "name": "EqualPriority",
      "weight": 1
    },
    {
      "name": "LeastRequestedPriority",
      "weight": 1
    },
    {
      "name": "NodePreferAvoidPodsPriority",
      "weight": 10000
    },
    {
      "name": "NodeAffinityPriority",
      "weight": 1
    }
  ],
  "hardPodAffinitySymmetricWeight" : 10,
  "alwaysCheckAllPredicates" : false
}
Seega koostab kube-scheduler esmalt nimekirja nodes, kuhu saab pod'i vastavalt GeneralPredicates poliitikale (mis sisaldab PodFitsResources, PodFitsHostPorts, HostName ja MatchNodeSelector poliitika komplekti) kavandada. Ja edasi hinnatakse iga node'it prioritiseerimise poliitikate komplekti alusel. Meie ülesande täitmiseks oleme arvutanud, et selline poliitikate komplekt on optimaalselt lahenduseks. Tuletan meelde, et poliitikate komplekt koos nende üksikasjaliku kirjeldamisega on saadaval . Oma ülesande täitmiseks võite lihtsalt muuta kasutatavate poliitikate komplekti ja määrata neile vastavad kaalud.
Uue kube-scheduler'i manifesti, mille me peatüki alguses lõime, nimetame kube-scheduler-custom.yaml ja paigutame selle järgmisele teele /etc/kubernetes/manifests kolmele master-node'ile. Kui kõik on õigesti tehtud, käivitab Kubelet igas node's pod'i ning meie uue kube-scheduler'i logides näeme teavet, et meie poliitikafail on edukalt rakendatud:
Loome plaanija konfiguratsiooni alusel: {{ } [{GeneralPredicates } ] [{ServiceSpreadingPriority 1 } {EqualPriority 1 } {LeastRequestedPriority 1 } {NodePreferAvoidPodsPriority 10000 } {NodeAffinityPriority 1 } ] [] 10 false}
Registreerimine: GeneralPredicates
Predikaadi tüüp GeneralPredicates on juba registreeritud, kasutatakse uuesti.
Registreerimine: ServiceSpreadingPriority
Prioriteedi tüüp ServiceSpreadingPriority on juba registreeritud, kasutatakse uuesti.
Registreerimine: EqualPriority
Prioriteedi tüüp EqualPriority on juba registreeritud, kasutatakse uuesti.
Registreerimine: LeastRequestedPriority
Prioriteedi tüüp LeastRequestedPriority on juba registreeritud, kasutatakse uuesti.
Registreerimine: NodePreferAvoidPodsPriority
Prioriteedi tüüp NodePreferAvoidPodsPriority on juba registreeritud, kasutatakse uuesti.
Registreerimine: NodeAffinityPriority
Prioriteedi tüüp NodeAffinityPriority on juba registreeritud, kasutatakse uuesti.
Loome plaanijat, mille sobivuse predikaadid on 'map[GeneralPredicates:{}]' ja prioriteetfunktsioonid 'map[EqualPriority:{} LeastRequestedPriority:{} NodeAffinityPriority:{} NodePreferAvoidPodsPriority:{} ServiceSpreadingPriority:{}]'
Nüüd jääb vaid märkida meie CronJob'i spetsiifitseis, et kõik selle pod'ide kavandamise päringud peaks käsitlema meie uut kube-scheduler'it:
...
 jobTemplate:
    spec:
      template:
        spec:
          schedulerName: kube-scheduler-cron
...
Kokkuvõte
Lõppkokkuvõttes saime täiendava kube-scheduler'i, millel on ainulaadne poliitikate komplekt kavandamiseks, mille tegevust jälgib otse kubelet. Lisaks oleme seadnud üles meie kube-scheduler'i pod'ide vahel uue juhi valimise, juhul kui vana juht mingitel põhjustel muutub kättesaamatuks.
Tavalised rakendused ja teenused jätkavad planeerimist läbi vaike kube-scheduler'i, samas kui kõik cron-ülesanded on täielikult üle viidud uuele. Cron-ülesannete koormus jaotatakse nüüd ühtlaselt kõigi sõlmede vahel. Arvestades, et enamik cron-ülesandeid täidetakse samadel sõlmedel, kus asuvad projekti põhiraudvara, on see oluliselt vähendanud riskikoormuse ümberpaiknemise tõttu ressursside puudujäägist. Pärast täiendava kube-scheduler'i juurutamist ei ole enam esinenud probleeme ebavõrdse cron-ülesannete planeerimisega.
Vaata ka teisi artikleid meie blogis:
Allikas: habr.com
