

Tänapäeval ei tekita kellelgi enam küsimust, miks on oluline koguda teenuste mõõdikuid. Järgmine loogiline samm on seadistada hoiatamine kogutud mõõdikute jaoks, mis teavitab teid kõigist andmete kõrvalekalletest mugavates kanalites (e-post, Slack, Telegram). Hotelli broneerimise teenuses kõik meie teenuste mõõdikud voolavad InfluxDB-sse ja kuvatakse Grafanas, kus on seadistatud ka põhihoiatamine. Ülesannete korral, kus on vaja midagi arvutada ja võrrelda, kasutame Kapacitort.
Kapacitor on osa TICK-stäkist, mis oskab töödelda mõõdikuid InfluxDB-st. See suudab ühendada mitu mõõtmist (join), arvutada saadud andmetest midagi kasulikku, salvestada tulemuse tagasi InfluxDB-sse ning saata hoiatuse Slacki/Telegrami/e-postiga.
Kogu stäkk on äärmiselt lahe ja detailne, , kuid alati leidub kasulikke näpunäiteid, mis ei ole manuaalides otseselt välja toodud. Käesolevas artiklis otsustasin koguda rida selliseid kasulikke ja mitte nii ilmselgeid nõuandeid (TICKscipti põhikood on kirjeldatud ) ja näidata, kuidas neid saab rakendada, kasutades näitena ühte meie ülesannet.
Lähme!
float & int, arvutuste vead
Absoluutselt tavaline probleem, lahendatakse kastiga:
var alert_float = 5.0
var alert_int = 10
data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
default() kasutamine
Kui silt/valik ei ole täidetud, tekivad arvutustes vead:
|default()
        .tag('status', 'empty')
        .field('value', 0)
fill join'is (inner vs outer)
Vaikimisi loob join punktid, kus andmeid pole (inner).
fill(‘null’) korral toimub outer join, pärast mida on vaja teha default() ja täita tühjad väärtused:
var data = res1
    |join(res2)
        .as('res1', 'res2')
        .fill('null')
    |default()
        .field('res1.value', 0.0)
        .field('res2.value', 100.0)
Siin on ikkagi nüanss. Kui eespool toodud näites on üks seeriatest (res1 või res2) tühi, on ka lõpptulemus (data) tühi. Selle teema kohta on GitHubis mitmeid piletit (, , ) – ootame parandusi ja kannatame veidi.
Tingimuste kasutamine arvutustes (if lambda's)
|eval(lambda: if("value" > 0, true, false)
Viimased viis minutit pipeline's perioodi jooksul
Näiteks, teil on vaja võrrelda viimase viie minuti väärtusi eelmise nädala omadega. Andmete saamiseks saate võtta kaks partiid eraldi batch'ina või välja tõmmata osa andmeid suuremast perioodist:
|where(lambda: duration((unixNano(now()) - unixNano("time"))/1000, 1u) < 5m)
Viimase viie minuti alternatiiviks võib olla BarrierNode'i kasutamine, mis katkestab andmed varem määratud ajast:
|barrier()
        .period(5m)
Go'ste mallide kasutamise näited message'is
Mallid vastavad paketi , allpool on mõned sageli esinevad ülesanded.
if-else
Korrastame olukorda, mitte ei aktiveeri inimesi tekstiga üleliia:
|alert()
    ...
    .message(
        '{{ if eq .Level "OK" }}Nüüd on kõik korras{{ else }}Ülemus, kõik on katki{{end}}'
    )
Kaks numbrit pärast koma message'is
Parandame sõnumi loetavust:
|alert()
    ...
    .message(
        'nüüdne väärtus on {{ index .Fields "value" | printf "%0.2f" }}'
    )
Muutujate arendamine message'is
Anname sõnumis rohkem teavet küsimusele «Miks see karjub?»
var warnAlert = 10
  |alert()
    ...
    .message(
       'Täna on väärtus vähem kui '+string(warnAlert)+'%'
    )
Alerdi unikaalne identifikaator
Täpne asi, kui andmetes on rohkem kui üks rühm, muidu genereeritakse ainult üks alerd:
|alert()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Kohandatud handler'id
Suures handlerite loendis on exec, mis võimaldab käivitada oma skripti edastatud parameetritega (stdin) – puhas looming!
Üks meie kohandusi on väike python'i skript teavituste saatmiseks slack'i.
Esmalt tahtsime saata sõnumis graafana pilti, mida kaitseb autoriseerimine. Seejärel – kirjutada OK eelneva alerdi teema alla, mitte eraldi sõnumina. Veidi hiljem – lisada sõnumisse kõige sagedasem viga viimase X minuti jooksul.
Eriline teema – ühendus teiste teenustega ja kõik tegevused, mida alerdi initsiatiivil algatada (ainult juhul, kui teie jälgimine töötab piisavalt hästi).
Näide handleri kirjeldusest, kus slack_handler.py on meie käsitsi kirjutatud skript:
topic: slack_graph
id: slack_graph.alert
match: level() != INFO AND changed() == TRUE
kind: exec
options:
  prog: \/sbin\/slack_handler.py
  args: ["-c", "CHANNELID", "--graph", "--search"]
Kuidas tõrkeotsingut teha?
Variant logisse väljastamiseks
|log()
      .level("error")
      .prefix("midagi")
Vaadata (cli): kapacitor -url :9092 logs lvl=error
Variant httpOut
Kuvab andmed praeguses torustikus:
|httpOut('midagi')
Vaata (get): :9092\/kapacitor\/v1\/tasks\/task_name\/midagi
Teostusplaan
- Iga ülesanne tagastab teostuspuu kasulike numbritega formaadis .
- Võtame ploki .
- Kandke viewerisse, .
Kust veel saab kätte grommingud
timestamp influxdb's tagasikiri
Näiteks seame suhtluse alerti, mis põhineb tunni jooksul tehtud päringute arvul (groupBy(1h)), ja soovime salvestada toimunud alerti influxdb-sse (et ilusasti näidata probleemi olemasolu graafikul grafanas).
influxDBOut() salvestab timestampi väärtuse alertist, seega punkt graafikul salvestatakse varem/hiljem, kui alert saabus.
Kui vajalik on täpsus: lahendame selle probleemi kohandatud handleri kutsumise kaudu, mis salvestab andmed influxdb-sse kohaliku timestampiga.
docker, ehitamine ja juurutamine
Kapacitori käivitamisel võib see laadida üles ülesandeid, malle ja handler'eid kaustast, mis on määratud konfiguratsioonis plokis [load].
Korralikuks ülesande loomiseks on vajalikud järgmised asjad:
- Failinimi – laieneb id/nimega skripti
- Tüüp – stream/batch
- dbrp – võtmesõna, et märkida, millises andmebaasis + poliitikas skript töötab (dbrp «supplier».«autogen»)
Kui mõnes batch-töös ei ole rida dbrp, keeldub kogu teenus käivitamast ja kirjutab ausalt sellest logisse.
Chronograf'is see rida aga ei peaks olema, liidese kaudu ei võeta seda vastu ja see annab vea.
Konteineri ehitamise nipp: Dockerfile väljub -1, kui esinevad read, kus on //.+dbrp, mis võimaldab kohe aru saada ehituse ebaõnnestumise põhjusest.
join üks paljude seas
Ülesanne-näide: tuleb võtta 95. protsentiil teenuse tööajast nädala jooksul, võrrelda viimase 10 minuti igat minutit selle väärtusega.
Ühte paljusid join'e ei saa teha, last/mean/median grupi punktide põhjal muudab sõlme streamiks, tagastatakse viga «cannot add child mismatched edges: batch -> stream».
Batchi tulemus, nagu muutujana lambda väljendis, ei too samuti asendatakse.
On võimalus salvestada vajalikud numbrid esimesest batch'ist faili läbi udf ja laadida see fail üles sideload'i kaudu.
Mida me sellega lahendasime?
Meil on umbes 100 hotellide teenusepakkujat, igal neist võib olla mitmeid ühendusi, nimetame neid kanaliteks. Neid kanaleid on umbes 300, iga kanali võib katketa. Kõikide salvestatavate mõõdikute hulgast jälgime vigade määra (requests ja errors).
Miks mitte grafana?
Grafanas seadistatud vigade alertid omavad mitmeid miinuseid. Mõned on kriitilised, teistele võib silma kinni pigistada, olenevalt olukorrast.
Grafana ei oska teha arvutusi mõõdikute vahel + alerting, aga meil on vaja määra (requests-errors)/requests.
Vead näevad välja kohutavad:
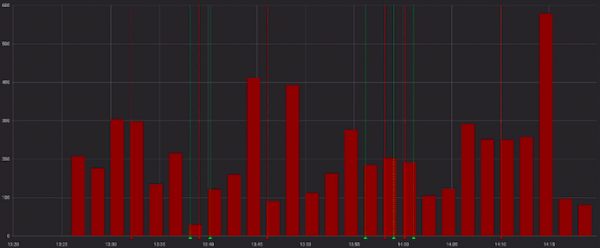
Ja vähem kohutav, kui vaadata koos edukaid päringutega:
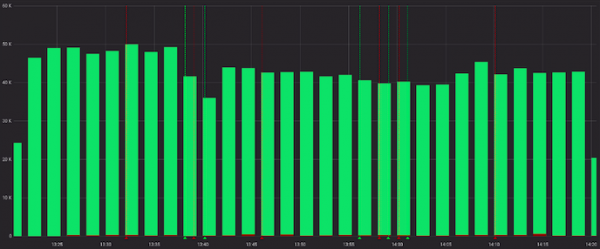
Olgu, me saame teenuse enne Grafanasse sissearvutada reitingu, ja mõnes mõttes sobib see. Kuid mitte meie puhul, kuna iga kanali jaoks arvutatakse oma 'normaalne' suhe, ja häired töötavad staatiliste väärtuste alusel (otsime silmadega, muudame, kui see sageli häirib).
Need on erinevate kanalite 'normaalsed' näited:
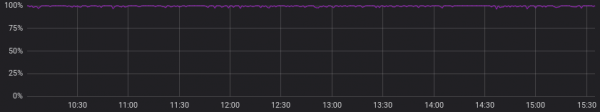
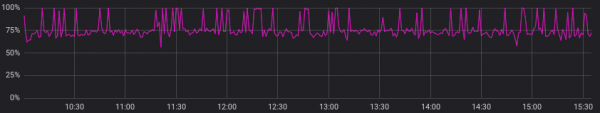
Jätame eelneva punkti tähelepanuta ja oletame, et kõigil teenusepakkujatel on 'normaalne' pilt sarnane. Nüüd on kõik korras ja saame Grafanasse häiretega toime tulla?
Saame küll, kuid ei tahaks seda teha, sest peame valima ühe järgmistest variantidest:
a) teha iga kanali jaoks eraldi palju graafikuid (ja vaeva nende hooldamisega)
b) jätta üks graafik kõigi kanalitega (ja kaotsida end värvikas joonte ja seadistatud häirete seas)
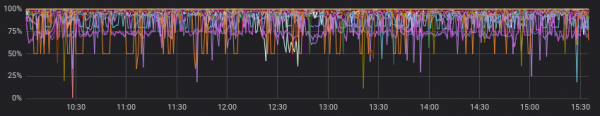
Kuidas tegime?
Jällegi, dokumentatsioonis on hea algusnäide (), saab piiluda või võtta aluseks sarnaste ülesannete puhul.
Mida me lõpuks tegime:
- kahe seeria liitmine mõne tunni jooksul, gruppimise kanalite kaupa;
- täidame seeriad gruppide kaupa, kui andmeid polnud;
- võrdleme viimase 10 minuti mediaani eelmiste andmetega;
- karjume, kui midagi avastame;
- kirjutame arvutatud reitingud ja toimunud häired influxdb-sse;
- saadetame kasulikku sõnumit Slacki.
Minu arvates suutsime maksimaalselt ilusasti kõik, mida sooviksime väljundina saada (ja isegi rohkem, koos kohandatud käsitlejatega).
Github.com-is saab vaadata ja saadud skriptist.
Näide saadud koodist:
dbrp "supplier"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8h
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
 // täidame null-väärtused, kui neid ei olnud
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
 // if lambda: arvutame määr, ainult kui vigu esines
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// salvestame arvutatud väärtused influxisse
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// valime andmeid viimase 10 minuti jooksul, arvutame mediaani
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // kogume sõnumisse lingi grafana armatuurlauale
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} err/req suhe ({{ index .Tags "supplier" }})
{{ if eq .Level "OK" }}Nüüd on kõik korras{{ else }}
'+string(todayPeriod)+' mediaan on {{ index .Fields "today.median" | printf "%0.2f" }}%, eelmise '+string(period)+' on {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/'+string(grafana_dash)+
'?var-supplier={{ index .Tags "supplier" }}&var-channel={{ index .Tags "channel" }}&panelId='+string(grafana_panel)+'&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }} / {{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" dubleerime kui "value", samuti kirjutame influksisse ülejäänud alamd
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
Ja kuidas see väljund on?
Kapacitor oskab suurepäraselt teostada seire- ja häirivusteenuseid koos hulga rühmitamisega, teha täiendavaid arvutusi juba salvestatud mõõdikute põhjal, teostada kohandatud toiminguid ja käivitada skripte (udf).
Sisenemise künnis ei ole väga kõrge – proovige seda, kui grafana või muud tööriistad ei täida täielikult teie soove.
Allikas: habr.com
