

Tere, Habr! Esitlen teile tõlget artiklist
.
Kui jutt käib relatsioonilistest andmebaasidest, ei saa ma jätta mõtlemata, et midagi on puudu. Need on igal pool. On mitmeid erinevaid andmebaase: alates väikesest ja kasulikust SQLite'ist kuni võimsa Teradata'ni. Kuid ainult mõned artiklid selgitavad, kuidas andmebaas töötab. Sa saad ise otsida fraasiga "howdoesarelationaldatabasework" («kuidas töötavad relatsioonilised andmebaasid»), et näha, kui vähe tulemusi on. Veelgi enam, need artiklid on lühikesed. Kui aga otsid viimaseid põnevaid tehnoloogiaid (Big Data, NoSQL või JavaScript), leiad sügavamate selgitustega artikleid.
Kas relatsioonilised andmebaasid on liiga vanad ja igavad, et neist väljaspool ülikooli kursusi, teadusuuringute töid ja raamatuid rääkida?
Arendajana vihkan ma kasutada midagi, mida ma ei mõista. Ja kui andmebaasid on olnud kasutusel üle 40 aasta, peab sellel olema põhjus. Nende aastate jooksul olen kulutanud sadu tunde, et tõeliselt mõista neid kummalisi musti kaste, mida kasutan iga päev. Suhtelised andmebaasid on väga huvitavad, kuna need tuginevad kasulikele ja korduvalt kasutatavatele kontseptsioonidele.Kui sind huvitab andmebaasi mõistmine, kuid sul pole kunagi olnud aega või soovi seda laia teemat uurida, peaks see artikkel sulle meeldima.
Kuigi selle artikli pealkiri on selge, ei ole selle artikli eesmärk mõista, kuidas andmebaasi kasutada.Seetõttu pead sa juba teadma, kuidas kirjutada lihtsat ühenduspäringut ja põhiküsimusi; CRUDvastasel juhul võid sa seda artiklit mitte mõista. See on ainus, mida pead teadma; ma selgitan kõike muud.
Alustan mõningatest arvutitarkuse põhialustest, nagu algoritmide ajakompleksus (Big O). Ma tean, et mõned teist vihkavad seda kontseptsiooni, kuid ilma selleta ei saa sa mõista andmebaasi sisemisi nüansse. Kuna see on tohutu teema, keskendun sellele, mida pean oluliseks,: kuidas andmebaas töötab. SQL taotlusKodan ainult põhialuste kontseptsioonid andmebaasi,et artikli lõpuks oleks sul arusaam, mis toimub kapoti all.
Kuna see on pika ja tehnilise artikli, mis sisaldab paljusid algoritme ja andmestruktuure, ärge kiirustage selle lugemisega. Mõned kontseptsioonid võivad olla keerulised mõista; võite need vahele jätta ja ikkagi saada üldise ülevaate.
Teie teadlikumate jaoks on see artikkel jagatud kolmeks osaks:
- Andmebaasi madala ja kõrge taseme komponentide ülevaade
- Küsimuste optimeerimise protsessi ülevaade
- Tehingute ja puhverpanga haldamise ülevaade
Tagasi põhialuste juurde
Palju aastaid tagasi (kauges, kauges galaktikas…) pidid arendajad täpselt teadma, kui palju toiminguid nad kodeerivad. Nad teadsid oma algoritme ja andmestruktuure peast, kuna nad ei saanud endale lubada oma aeglaste arvutite CPU ja mälu raiskamist.
Selles osas meenutan teile mõningaid neist kontseptsioonidest, kuna need on vajalikud andmebaasi mõistmiseks. Tutvustan ka mõistet andmebaasi indeks.
O(1) vs O(n2)
Praegu ei hooli paljud arendajad algoritmide ajaloogilisest keerukusest… ja nad on õiged!
Kuid kui tegelete suure andmemahuga (ma ei räägi tuhandetest) või kui võitlete millisekundite eest, on ülioluline mõista seda kontseptsiooni. Nagu te teate, peavad andmebaasid tegelema mõlema olukorraga! Ma ei lase teil kulutada rohkem aega, kui on vajalik, et haarata olemus. See aitab meil hiljem mõista kulupõhise optimeerimise kontseptsiooni (cost based optimization).
Kontseptsioon
Algoritmi ajaloogiline keerukus kasutatakse, et näha, kui kaua peab algoritm andmemahu töötlemiseks aega võtma.Selle keerukuse kirjeldamiseks kasutatakse suurte O matemaatilisi tähistusi. Seda märkust kasutatakse funktsiooniga, mis kirjeldab, kui palju toiminguid on algoritmil antud sisendandmete hulga jaoks vaja.
Näiteks kui ma ütlen, "see algoritm on keerukusega O (some_function() )", tähendab see, et teatud andmehulgaga töötlemiseks on algoritm vajanud some_function(a_certain_amount_of_data) toimingut.
Selle juures tähtis ei ole andmete hulk**, vaid see, ** kuidas toimingute arv kasvab andmemahu suurenedes.Ajakeerukus ei anna täpset toimingute arvu, vaid on hea viis ajakulu hindamiseks.
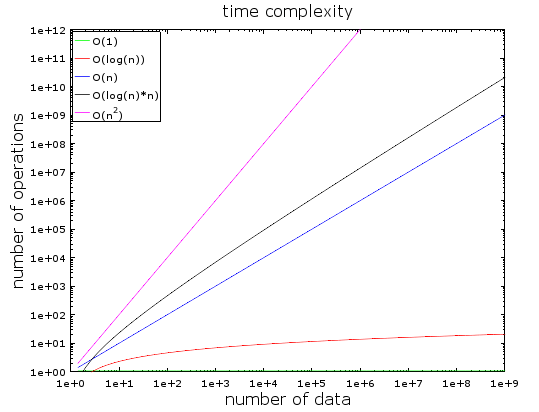
Sellel diagrammil näete seost operatsioonide arvu ja sisendandmete mahtu erinevate ajakulu keerukuse tüüpide vahel. Kasutasin logaritmilist skaala nende kuvamiseks. Teisisõnu, andmete hulk kasvab kiiresti 1-st kuni 1 miljardi. Saame näha, et:
- O(1) või konstantne keerukus jääb pidevaks (vastasel juhul ei saaks seda nimetada konstantseks keerukuseks).
- O(log(n)) jääb madalaks isegi miljardite andmetega.
- Halvim keerukus on O(n2), kus operatsioonide arv kasvab kiiresti.
- Kaks muud keerukust kasvavad samuti kiiresti.
Näited
Väikese andmemahu korral on erinevus O(1) ja O(n2) vahel ebaoluline. Näiteks oletame, et teil on algoritm, mis peab töötlema 2000 elementi.
- O (1) algoritm maksab teile 1 operatsiooni
- O (log (n)) algoritm maksab teile 7 operatsiooni
- O (n) algoritm maksab teile 2000 operatsiooni
- O (n * log (n)) algoritm maksab teile 14 000 operatsiooni
- O (n2) algoritm maksab teile 4 000 000 operatsiooni
O(1) ja O(n2) vahe tundub suur (4 miljonit operatsiooni), kuid te kaotate maksimaalselt 2 ms, lihtsalt silmapilgutamise aja. Tõepoolest, tänapäevased protsessorid suudavad töödelda . Seetõttu ei ole paljude IT-projektide puhul jõudlus ja optimeerimine probleem.
Nagu juba mainitud, on selle kontseptsiooni tundmine endiselt oluline, kui töötate tohutu andmemahuga. Kui seekord peab algoritm töötlema 1 000 000 elementi (mis ei ole eriti palju andmebaasi jaoks):
- O (1) algoritm maksab teile 1 operatsiooni
- O (log (n)) algoritm maksab teile 14 operatsiooni
- O (n) algoritm maksab teile 1 000 000 operatsiooni
- O (n * log (n)) algoritm maksab teile 14 000 000 operatsiooni
- O (n2) algoritm maksab teile 1 000 000 000 000 operatsiooni
Ma ei ole arvutusi teinud, aga ma ütleksin, et O (n2) algoritmiga on teil aega kohvi juua (isegi kaks!). Kui lisate veel 0 andmemahule, on teil aega uinuda.
Läheme sügavamale
Teabe jaoks:
- Heas hash-tabelis leidmine leiab elemendi O (1) ajaga.
- Hästi tasakaalustatud puus leidmine annab tulemuse O (log (n)) ajaga.
- Massiivis leidmine annab tulemuse O (n) ajaga.
- Parimatel sortimisalgoritmidel on keerukus O (n * log (n)).
- Halval sortimisalgoritmil on keerukus O (n2).
Märkus: järgmistes osades vaatame neid algoritme ja andmestruktuure.
On mitu algoritmi ajaliselt keerulist tüüpi:
- keskmise stsenaariumi korral
- parima arengusena
- ja halvim stsenaarium
Ajaliselt keerukus on sageli halvim stsenaarium.
Ma rääkisin ainult algoritmi ajalisest keerukusest, kuid keerukus kehtib ka:
- algoritmi mälu kasutus
- algoritmi ketta sisendi / väljundi kasutus
Muidugi on keerukusi, mis on halvemad kui n², näiteks:
- n⁴: see on kohutav! Mõned mainitud algoritmid omavad sellist keerukust.
- 3n: see on veel hullem! Üks algoritm, mida me näeme artikli keskosas, omab seda keerukust (ja seda kasutatakse tõeliselt paljude andmebaaside puhul).
- faktoriaal n: te ei saa oma tulemusi isegi väikese andmehulgaga.
- nn: kui te puutute kokku selle keerukusega, peaksite küsima endalt, kas see on tõesti teie ala ...
Märkus: ma andsin teile mitte reaalse määratletud «suur O» tähenduse, vaid lihtsalt idee. Võite lugeda seda artiklit reaalse (asümptootilise) määratluse jaoks.
MergeSort (Sorteerimine ühendamisega)
Mida teete, kui peate kollektsiooni sorteerima? Mida? Kutsute välja funktsiooni sort () ... Okei, hea vastus ... Kuid andmebaaside jaoks peate mõistma, kuidas see sort () funktsioon töötab.
On mitmeid häid sorteerimisalgoritme, seega keskendun kõige olulisemale: ühendamisega sorteerimine. Võib-olla te ei saa hetkel aru, miks andmete sorteerimine on kasulik, kuid peate selle mõistma pärast küsimuste optimeerimise osale pühendatud osa. Veelgi enam, ühendamisega sorteerimise mõistmine aitab meil hiljem mõista andmebaaside üldoperatsiooni, mida nimetatakse merge join (ühendamine ühendamisega).
Merge (ühendamine)
Nagu paljude kasulike algoritmide puhul, põhineb ühendamisega sorteerimine nipil: kahe suurusega N/2 järjestatud massiivi ühendamine N-elementseks järjestatud massiiviks maksab vaid N toimingut. Seda toimingut nimetatakse ühendamiseks.
Vaadake, mida see lihtsa näite põhjal tähendab:
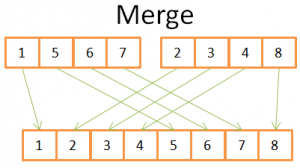
Selles joonises on näha, et 8 elemendi lõpliku järjestatud massiivi loomiseks peate lihtsalt kordama üks kord kahes 4-elementises massiivis. Kuna mõlemad 4-elementilised massiivid on juba järjestatud:
- 1) te võrdlete kahte praegust elementi kahes massiivis (alguses praegune = esimene)
- 2) seejärel võtke kõige väiksem, et paigutada see 8-elemendiliseks massiiviks
- 3) ja minge järgmisele elemendile massiivis, kus võtsite kõige väiksema elemendi
- ja korrake 1,2,3, kuni jõuate ühe massiivi viimase elemendini.
- Siis võtate ülejäänud elemendid teisest massiivist, et paigutada need 8-elemendiliseks massiiviks.
See töötab, kuna mõlemad 4-elemendilised massiivid on sorteeritud ja seega ei pea te nende massiivide puhul "tagasi minema".
Nüüd, kui me mõistsime seda trikki, on siin minu pseudokood merge jaoks:
massiiv mergeSort(massiiv a)
   kui (length(a)==1)
      tagasta a[0];
   lõpeta kui

   //rekursiivsed kõned
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   massiiv new_left_array := mergeSort(left_array);
   massiiv new_right_array := mergeSort(right_array);

   //ühendamine 2 väikest järjestatud massiivi suureks
   massiiv tulemus := merge(new_left_array,new_right_array);
   tagasta tulemus;
Merge sort jagab ülesande väiksemateks ülesanneteks ja seejärel leiab väiksemate ülesannete tulemused, et saada algse ülesande tulemus (märkuste jaoks: see tüüp algoritmidest nimetatakse 'jaga ja valitse'). Kui te ei mõista seda algoritmi, ärge muretsege; ma ei mõistnud seda esimesel korral, kui nägin. Kui see võib teid aidata, näen seda algoritmi kui kahefasilist algoritmi:
- Jagamisfaas, kus massiiv jagatakse väiksemateks massiivideks
- Sorteerimisfaas, kus väikesed massiivid ühendatakse (kasutades ühendamist), et moodustada suurem massiiv.
Jagamisfaas (Division phase)
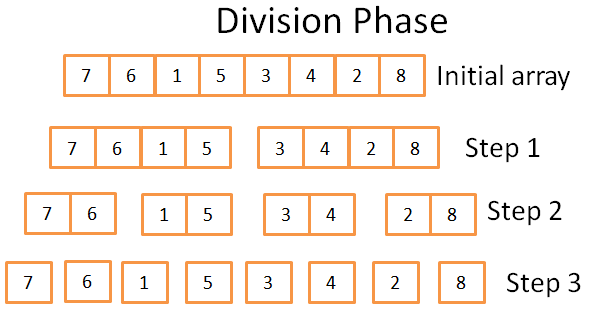
Jagamisfaasi etapis jagatakse massiiv kolmes etapis üheaegsusteks massiivideks. Ametlik sammude arv on log(N) (kuna N=8, log(N) = 3).
Kust ma seda tean?
Ma olen geenius! Ühesõnaga — matemaatika. Idee on see, et iga samm jagab algse massiivi suurust 2-ga. Sammude arv on see, kui mitu korda saate algse massiivi kaheks jagada. See on logaritmi (alusel 2) täpne määratlemine.
Sorteerimisfaas (Sorting phase)
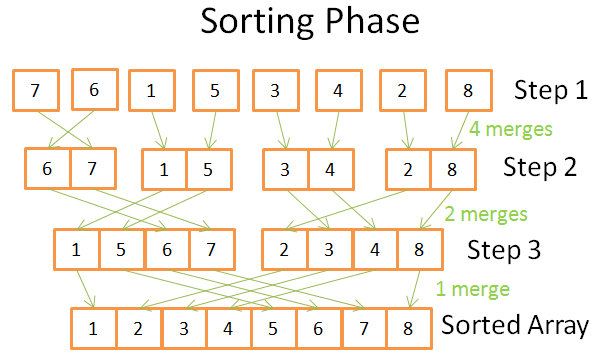
Sorteerimisfaasi etapis alustate üheaegsustest (üheelemendilised) massiividest. Iga etapi jooksul rakendate mitmeid ühendamisoperatsioone ja koguhind on N = 8 operatsiooni:
- Esimesel etapil on teil 4 ühendamist, mis maksavad 2 operatsiooni igaühe kohta
- Teisel sammul on teil 2 ühendamist, mis maksavad 4 operatsiooni igaühe kohta
- Kolmandal sammul on teil 1 ühendamine, mis maksab 8 operatsiooni
Kuna on olemas log (N) sammu, koguhind N * log(N) operatsiooni.
Merge sort eelised
Miks on see algoritm nii võimas?
Sest:
- Sa saad seda muuta, et vähendada mälu kasutust, nii et sa ei loo uusi massiive, vaid muudad otse sisendmassiiivi.
Märkus: seda tüüpi algoritme nimetatakse (sortimine ilma täiendava mäluta).
- Sa saad seda muuta, et kasutada samaaegselt kettaruumi ja väikest mälu, ilma oluliste kuludeta kettasisendi/väljaande peale. Idee on laadida mällu ainult need osad, mida parasjagu töödeldakse. See on oluline, kui pead sorteerima mitu gigabaiti suuruse tabeli vaid 100 megabaidise mälu puhvri abil.
Märkus: seda tüüpi algoritme nimetatakse .
- Sa saad seda muuta mitme protsessi/niidi/serveeri jooksutamiseks.
Näiteks on jaotatud sulandumise sortimine üks peamisi komponente (mis on struktuur suurte andmete seas).
- See algoritm suudab muuta plii kullaks (tõeliselt!).
Seda sortimisalgoritmi kasutatakse enamikes (kui mitte kõigis) andmebaasides, kuid see ei ole ainus. Kui soovid rohkem teada saada, saad lugeda seda , mis arutleb andmebaaside tavaliste sortimisalgoritmide plusse ja miinuseid.
Massiiv, Puud ja Hash-tabel
Nüüd, kui me mõistame ajakompleksuse ja sortimise ideed, pean ma rääkima sulle 3 andmestruktuurist. See on oluline, kuna need moodustavad kaasaegsete andmebaaside aluse. Ma tutvustan ka mõistet andmebaasi indeks.
Massiiv
Kaks dimensiooniline massiiv on kõige lihtsam andmestruktuur. Tabelit saab vaadelda kui massiivi. Näiteks:
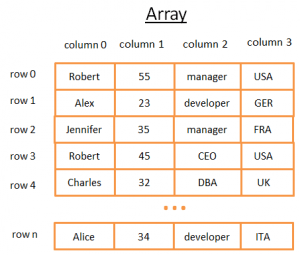
See 2-dimensiooniline massiiv on tabel ridade ja veergudega:
- Iga rida esindab üksust
- Veerud salvestavad omadused, mis kirjeldavad üksust.
- Iga veerg salvestab kindla tüübi andmeid (täisarv, string, kuupäev …).
Andmete salvestamine ja visualiseerimine on nii mugav, aga kui pead leidma kindla väärtuse, ei sobi see.
Näiteks, kui soovid leida kõiki poisse, kes töötavad Suurbritannias, pead läbi vaatama iga rea, et määrata, kas see rida kuulub Suurbritanniale. See maksab sulle N operatsiooni, kus N — ridade arv, mis pole halb, aga kas on võimalik kiiremini? Nüüd on aeg tutvuda puude struktuuriga.
Märkus: enamik kaasaegseid andmebaase pakub efektiivset tabelite salvestamist, nagu heap-organized tables ja index-organized tables. See ei muuda aga kiire otsingu probleemi teatud tingimuse leidmiseks veergude grupis.
Andmebaasi puu ja indeks
Binaarne otsingupuu on binaarne puu, millel on eriline omadus, igas sõlmes olev võti peab olema:
- suurem kui kõik vasakpoolses alampuud hoitavad võtmed
- väiksem kui kõik parempoolses alampuud hoitavad võtmed
Vaadakem, mida see visuaalselt tähendab
Idee
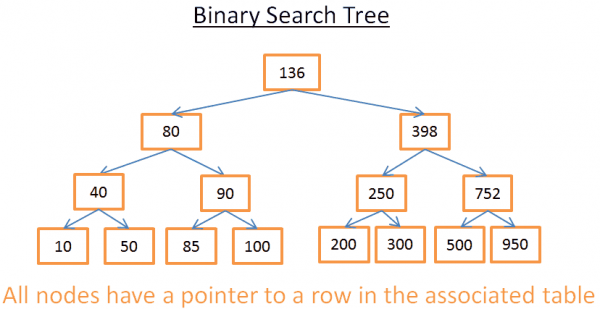
See puu sisaldab N = 15 elementi. Oletame, et otsin 208:
- Alustan juurest, mille võti on 136. Kuna 136<208, vaatan 136 parempoolse alampuu poole.
- 398>208, seega vaatan 398 vasakpoolset alampuud.
- 250>208, seega vaatan 250 vasakpoolset alampuud.
- 200<208, seega vaatan 200 parempoolset alampuud. Aga 200-l ei ole parempoolset alampuud, väärtus ei eksisteeri (sest kui see eksisteeriks, oleks see 200 parempoolses alampuus).
Nüüd, ütleme, et otsin 40
- Alustan juurest, mille võti on 136. Kuna 136 > 40, vaatan 136 vasakpoolset alampuud.
- 80 > 40, seega vaatan 80 vasakpoolset alampuud.
- 40= 40, sõlm eksisteerib. Tõmban sõlme id, mis on sõlmes (see ei ole joonisel) ja vaatan tabelist selle identifikaatori järgi.
- Sõlme identifikaatori teadmine võimaldab mul teada, kus andmed tabelis asuvad, ja seega pääsen neile kiiresti juurde.
Kokkuvõttes maksavad mõlemad otsingud mulle puu sees tasemete arvu. Kui loete hoolikalt sulandamise sorteerimise osa, peate märkama, et siin on log (N) taset. Tulemuseks on, otsingu hind log(N), mitte paha!
Naaseme meie probleemile
Aga see on väga abstraktne, seega naeme tagasi meie probleemile. Lihtsa täisarvu asemel kujutlege stringi, mis esindab kellegi riiki eelmises tabelis. Oletame, et teil on puu, mis sisaldab välja "country" (veerg 3) tabelis:
- Kui soovite teada, kes töötab Ühendkuningriigis
- otsite puust sõlme, mis esindab Ühendkuningriiki
- sõlme "UKnode" sees leiate töötajate kirje asukohad Ühendkuningriigis.
See otsing maksab log(N) operatsiooni asemel N operatsiooni, kui kasutate otse massiivi. See, mida just esitasite, oli andmebaasi indeks.
Sa võid ehitada indeksipuu mis tahes väljade grupile (string, number, 2 stringi, number ja string, kuupäev ...) seni, kuni sul on võrdlemise funktsioon võtmete (st väljade gruppide) jaoks, nii et saad määrata järjestuse võtmete seas (mis kehtib kõigi põhitüüpide kohta andmebaasis).
B+PuuIndeks
Kuigi see puu töötab hästi kindla väärtuse saamiseks, on olemas SUUR probleem, kui pead saama mitu elementi kahe väärtuse vahel. See maksab O(N), kuna pead vaatama iga sõlme puus ja kontrollima, kas see asub nende kahe väärtuse vahel (näiteks järjekorras oleva puu läbimisega). Veelgi enam, see operatsioon ei ole mugav kettaseadmestiku jaoks, kuna pead lugema kogu puud. Peame leidma viisi tõhusalt teostada vahemiku päringut. Selle probleemi lahendamiseks kasutavad kaasaegsed andmebaasid modifitseeritud versiooni eelmisest puust, mida nimetatakse B+Puuks. B+Puu puhul:
- ainult kõige madalamad sõlmed (lehed) hoidavad teavet (read seotud tabelis)
- ülejäänud sõlmed on siin selleks, et suunata õigele sõlmele otsimise ajal.
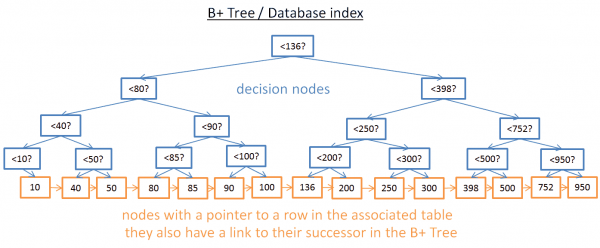
Nagu näha, on siin rohkem sõlmi (kaks korda rohkem). Tõesti, sul on täiendavad sõlmed, "otsustamise sõlmed", mis aitavad sul leida õige sõlme (mis hoiab ridu seotud tabelis). Kuid otsimise keerukus on ikka O(log(N)) (on ainult veel üks tase). Suur erinevus on selles, et madala taseme sõlmed on seotud nende järeltulijatega.
Selle B+Puuga, kui otsid väärtusi vahemikus 40 kuni 100:
- Pead lihtsalt otsima 40 (või lähimat väärtust pärast 40, kui 40 ei eksisteeri), nagu tegid eelneva puu puhul.
- Siis kogu 40 järeltulijad, kasutades otse viiteid järeltulijatele, kuni saavutad 100.
Oletame, et leidsid M järeltulijat ja puul on N sõlme. Konkreetse sõlme otsimise hind on log(N) sarnaselt eelneva puu puhul. Kuid selle sõlme saamisel saad M järeltulijat M operatsiooniga viidates nende järeltulijatele. See otsing maksab ainult M+log(N) operatsioonide arv võrreldes N operatsiooniga eelmise puu puhul. Veelgi enam, teil ei ole vaja lugeda kogu puud (ainult M + log (N) sõlme), mis tähendab väiksemat ketta kasutust. Kui M on väike (nt 200 rida) ja N suur (1 000 000 rida), siis on see SUUR erinevus.
Kuid siin on uus probleem (taaskord!). Kui lisate või eemaldate rea andmebaasist (ja seega seotud B+ puu indeksist):
- peate säilitama järjekorra B+ puu sõlmede vahel, vastasel juhul ei leia te sõlmi mittesorteeritud puust.
- peate säilitama minimaalset võimalikku taseme arvu B+ puus, vastasel juhul ajastatud keerukus O(log(N)) muutub O(N).
Teisisõnu, B+ puu peab olema ise järjekorras ja tasakaalus. Õnneks on see võimalik nutikate eemaldamis- ja sisestamisoperatsioonidega. Kuid see on kulukas: B+ puusse sisestamine ja eemaldamine maksab O(log(N)). Seetõttu olete mõned teist kuulnud, et liialt palju indeksite kasutamine ei ole väga hea mõte. Tõepoolest, te aeglustate kiiret rea sisestamist / värskendamist / eemaldamist tabelis, kuna andmebaas peab igas indeksis tabeli indekseid värskendama kuluka O(log(N)) operatsiooniga. Veelgi enam, indeksite lisamine tähendab suuremat koormust tehingute haldurile (millest räägitakse artikli lõpus).
Lisainformatsiooni saamiseks võite vaadata artiklit Vikipeedias . Kui soovite näidet B+ puu rakendamisest andmebaasis, vaadake ja MySQLi peaarendaja poolt. Need keskenduvad sellele, kuidas InnoDB (MySQLi mootor) hallab indekseid.
Märkus: lugeja ütles mulle, et madala taseme optimeerimise tõttu peab B+ puu olema täielikult tasakaalus.
Hash-tabel
Meie viimane oluline andmestruktuur on hash-tabel. See on väga kasulik, kui soovite kiiresti väärtusi otsida. Veelgi enam, hash-tabeli mõistmine aitab meil hiljem mõista andmebaasi üldist liitumisoperatsiooni, mida nimetatakse hash-ühenduseks ( hash join). Seda andmestruktuuri kasutab ka andmebaas mõne siseasi (nt lukustustabel või vahemälupuhver, näeme mõlemaid neid kontseptsioone hiljem).
Hash-tabel on andmestruktuur, mis leiab elemendi kiiresti selle võtme järgi. Hash-tabeli loomiseks peate määratlema:
- võti oma elementide jaoks
- hash-funktsiooni võtmete jaoks. Arvutatud võtmete hash'id annavad elementide asukoha (mida nimetatakse sektsioonideks ).
- võtmete võrdlemiseks funktsiooni. Kui olete leidnud õige sektsiooni, peate leidma elemendi, mida otsite, kasutades seda võrdlemist.
Lihtne näide
Vaatame ühte selgitavat näidet:
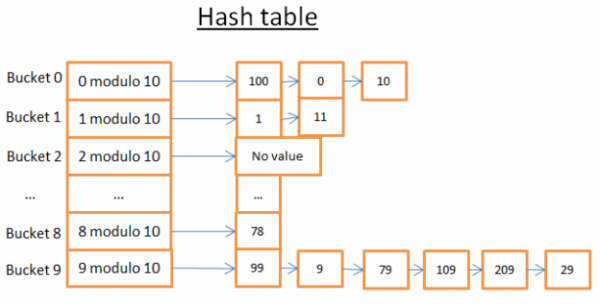
See hash-tabel sisaldab 10 sektsiooni. Kuna ma olen laisk, olen kujutanud vaid 5 sektsiooni, kuid tean, et olete nutikad, nii et lasen teil 5 teist ise ette kujutada. Kasutasin hash-funktsiooni võtme mooduli 10 järgi. Teisisõnu, hoian alles elemendi võtme viimast numbrit, et leida selle sektsioon:
- kui viimane number on 0, satub element sektsiooni 0,
- kui viimane number on 1, satub element sektsiooni 1,
- kui viimane number on 2, satub element sektsioni 2,
- …
Võrdlemiseks kasutatud funktsioon on lihtsalt kahe täisarvu võrdlemine.
Oletame, et soovite saada elementi 78:
- Hash-tabel arvutab 78 jaoks hash-koodi, mis on 8.
- Hash-tabel vaatab sektsiooni 8, ja esimene element, mille ta leiab, on 78.
- Ta tagastab teile elemendi 78
- Otsing maksab vaid 2 toimingut (üks hash-funktsiooni väärtuse arvutamiseks ja teine elemendi leidmiseks sektsioonis).
Nüüd oletame, et soovite saada elementi 59:
- Hash-tabel arvutab 59 jaoks hash-koodi, mis on 9.
- Hash-tabel otsib sektsioonis 9, esimene leitud element on 99. Kuna 99!=59, ei ole element 99 õige element.
- Sama loogikat kasutades võetakse teine element (9), kolmas (79), ..., viimane (29).
- Elementi ei leitud.
- Otsing maksis 7 toimingut.
Hea hash-funktsioon
Nagu näete, sõltub hinnang sõltuvalt otsitavast väärtusest!
Kui nüüd muudan hash-funktsiooni võtme mooduli 1 000 000 järgi (st võttes viimased 6 numbrit), siis teine otsing maksab vaid 1 toimingu, kuna sektsioonis 000059 ei ole elemento. Tegelik ülesanne on leida hea hash-funktsioon, mis loob sektsioone, milles on väga vähe elemente..
Minu näites on hea hash-funktsiooni leidmine lihtne. Kuid see on lihtne näide, hea hash-funktsiooni leidmine on keerulisem, kui võtme:
- string (näiteks - perekonnanimi)
- 2 stringi (näiteks - perekonnanimi ja eesnimi)
- 2 stringi ja kuupäev (näiteks - perekonnanimi, eesnimi ja sünnikuupäev)
- …
Hea hash-funktsiooniga toimub otsing hash-tabelis O(1) ajaga.
Massiiv vs hash-tabel
Miks mitte kasutada massiivi?
Hmm, hea küsimus.
- Hash-tabel võib olla osaliselt laaditud mällu, kuid ülejäänud segmendid võivad jääda ketta peale.
- Massiivi puhul peate kasutama mälus järjepidevat ruumi. Kui laadite suure tabeli on väga keeruline leida piisavalt järjepidevat ruumi.
- Hash-tabeli puhul saate valida vajaliku võtme (näiteks, riik ja inimese perekonnanimi).
Lisainformatsiooni saamiseks võite lugeda artiklit , mis on efektiivne hash-tabeli rakendus; teil ei ole vaja mõista Java-d, et mõista selle artikli läbivaatatud kontsepte.
Allikas: habr.com
