

Tere, Habr!
Pärast uusaasta puhkusi käivitasime ümber katastroofikindla pilve, mis põhineb kahel asukohal. Täna räägime, kuidas see toimib, ja näitame, mis juhtub kliendi virtuaalmasinatega, kui mõni klastrielement ebaõnnestub või kui kogu asukoht kaob (spoiler – nendega on kõik korras).
Katastroofikindla pilve andmesalvestus OST asukohal.
Mis on sees
Klastri all on Cisco UCS serverid VMware ESXi hüperviisoriga, kaks INFINIDAT InfiniBox F2240 andmesalvestusseadet, Cisco Nexus võrguvarustus ja Brocade SAN-lülitid. Klaster on jagatud kahe asukoha vahel – OST ja NORD, st igas andmekeskuses on identne seadmete komplekt. Just see muudab selle katastroofikindlaks.
Ühes asukohas on põhielemendid samuti dubleeritud (hostid, SAN-lülitid, võrgud).
Kaks asukohta on ühendatud eraldatud optilise kiudukaabli radadega, mis on samuti varustatud.
Mõned sõnad andmesalvestusseadmest. Esimene versioon katastroofikindlast pilvest ehitati NetAppile. Siin valisime INFINIDATi, ja siin on miks:
- Active-Active replikatsioonivalik. See võimaldab virtuaalsel masinal jääda töövõimeliseks isegi siis, kui üks andmesalvestusseade täielikult ebaõnnestub. Räägin replikatsioonist lähemalt hiljem.
- Kolm kettakontrollerit süsteemi vigade vältimise suurendamiseks. Tavaliselt on neid kaks.
- Valmis lahendus. Meile toodi juba kokku monteeritud riiul, mille tuli vaid võrku ühendada ja seadistada.
- Hoolikas tehniline tugi. INFINIDATi insenerid analüüsivad pidevalt logisid ja andmesalvestusseadme sündmusi, paigaldavad uusi versioone tarkvaras ja aitavad seadistamisega.
Siin on mõned fotod unpacking’ust:
Kuidas see töötab
Pilv on juba endas katastroofikindel. See kaitseb klienti üksikute riistvaraliste ja tarkvaraliste tõrgete eest. Katastroofikindel aga aitab kaitsta massiliste tõrgete eest konkreetse asukoha piires: näiteks andmesalvestusseadmest (või SDS klastrist, mis juhtub sageli 🙂), massilised vead salvestusvõrgus jne. Ja mis kõige tähtsam: selline pilv päästab, kui terve asukoht muutub kättesaamatuks tule, mustandi, röövimise või tulnukate rünnaku tõttu.
Igas neist olukordadest jätkavad kliendi virtuaalmasinad töötamist, ja siin on miks.
Klastri skeem on üles ehitatud nii, et iga ESXi-host, millel on kliendi virtuaalmasinad, saab pöörduda ühe või kahe andmesalvestuse poole. Kui OST asukohas asuv andmesalvestus ebaõnnestub, jätkavad virtuaalmasinad töötamist: hostid, millel need töötavad, võtavad andmeid NORD andmesalvestusest.
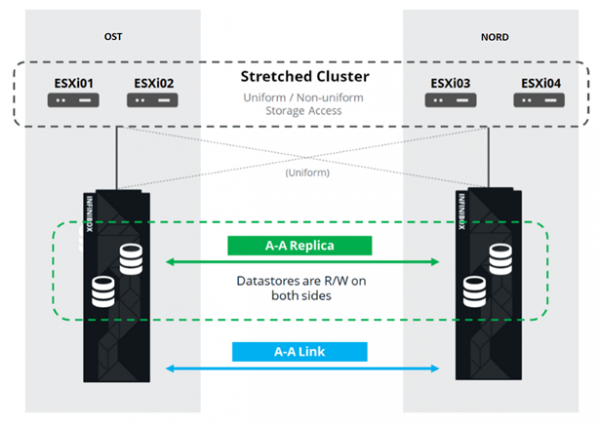
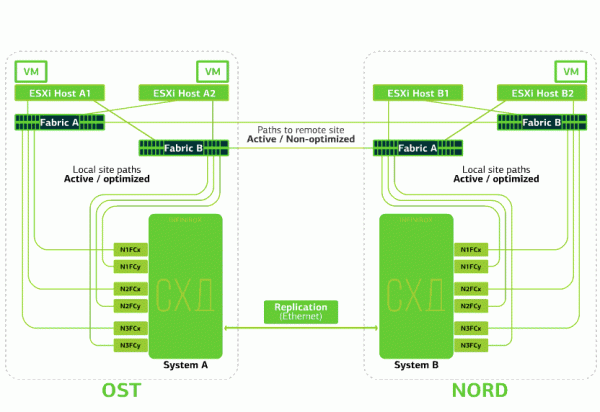
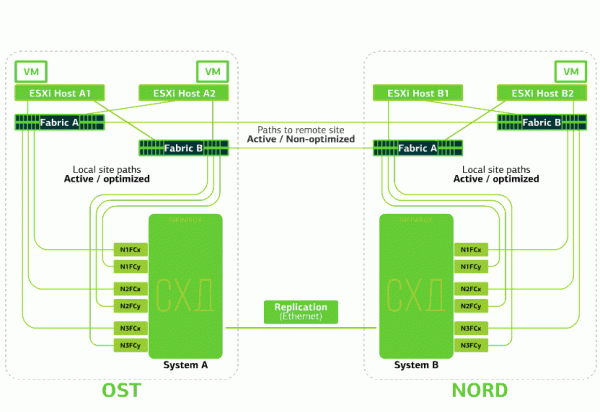
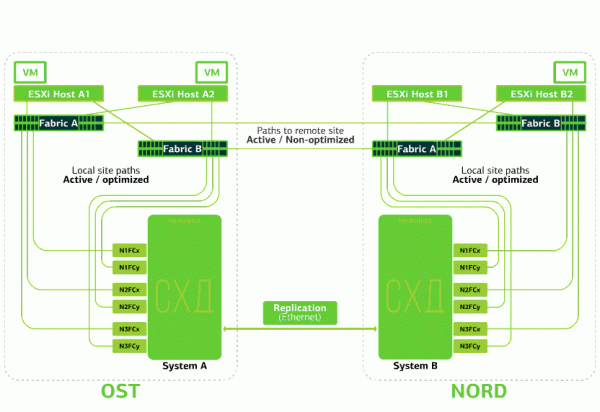
Nii näeb välja ühenduse skeem klastri sees.
See on võimalik tänu sellele, et kahe asukoha SAN-tehaste vahel on seadistatud Inter-Switch Link: OST Fabric A SAN-lüliti on ühendatud NORD Fabric A SAN-lülitiga, samamoodi on seatud ka Fabric B SAN-lülitid.
Ja et kõik need SAN-tehaste keerulised seosed oleksid mõistlikud, on kahe andmesalvestuse vahel seadistatud aktiivne-aktiivne replikatsioon: teave kirjutatakse peaaegu samaaegselt nii kohalikku kui ka kaugandmesalvestusse, RPO=0. Seega on ühes andmesalvestuses andmete originaal, teises - nende replikatsioon. Andmed replikitakse andmesalvestuse mahtude tasandil, ning nende peal hoitakse VM andmeid (tema kettad, konfigureerimisfail, vahetusfail jne).
ESXi-host näeb põhimahtu ja selle replikatsiooni kui ühte salvestusseadet (Storage Device). Iga salvestusseadmest on 24 teed ESXi-hosti:
12 teed ühendavad selle kohaliku andmesalvestusega (optimaalsed teed), ülejäänud 12 - kaugel asuva andmesalvestusega (mitte-optimaalsed teed). Tavalistes tingimustes pöördub ESXi andmete poole kohaliku andmesalvestuse kaudu, kasutades "optimaalseid" teid. Kui see andmesalvestus ebaõnnestub, kaotab ESXi optimaalsed teed ja lülitub "mitte-optimaalsetele". Nii näeb see skeemil välja.
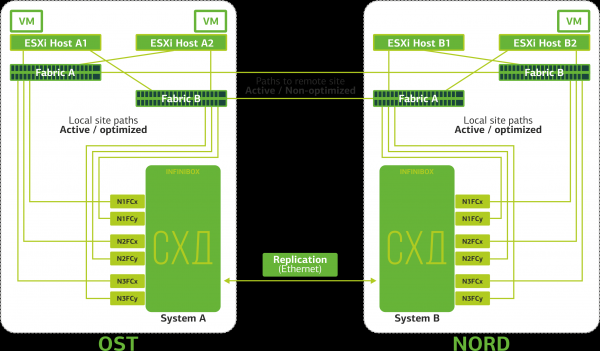
Kliendile vastupidavuse skeem.
Kõik kliendi võrgud on ühendatud mõlemasse asukohta ühise võrgutehase kaudu. Igal asukohal töötab Provider Edge (PE), kus kliendi võrgud lõppevad. PE-d on ühendatud ühisesse klastrisse. Kui PE ebaõnnestub ühes asukohas, suunatakse kogu liiklus teise asukohta. Selle tulemusena jäävad virtuaalmasinad asukohas, mis jäi ilma PE-st, kliendile võrgu kaudu kätte saadavaks.
Vaatame nüüd, mis juhtub kliendi virtuaalmasinatega erinevate ebaõnnestumiste korral. Alustame kõige kergematest variantidest ja lõpetame raskema juhtumiga - kogu asukoha ebaõnnestumisega. Näidetes on põhiasukohaks OST ja varukoht andmete replikatsiooniga NORD.
Mis juhtub kliendi virtuaalmasinaga, kui…
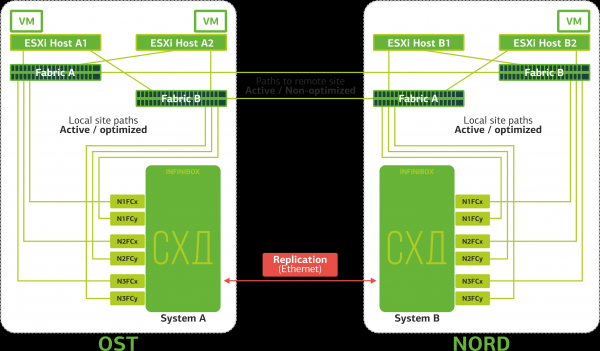
Ebaõnnestub replikatsiooni link. Replikatsioon kahe asukoha andmesalvestuste vahel lõpetatakse.
ESXi töötavad ainult kohalike ketta seadmete (optimaalsete teede) korral.
Virtuaalmasinad jätkavad tööd.
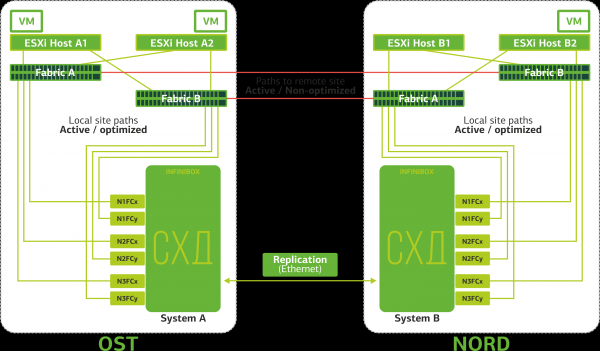
ISL (Inter-Switch Link) katkeb. Juhtum on ebatõenäoline. Ainus, kui mõni raevukas kaevur kaevab korraga mitu optilist teed, mis kulgevad iseseisvaid marsruute pidi ja on viidud platsidele erinevate sissetulekute kaudu. Aga siiski. Sellisel juhul kaotavad ESXi-hostid poole teedest ja saavad juurdepääsu ainult oma kohalikele SAN-idele. Repliigid kogunevad, kuid hostid ei suuda neile juurde pääseda.
Virtuaalmasinad töötavad probleemideta.
SAN-lüliti ei toimi ühel platsil. ESXi-hostid kaotavad osa teedest SAN-idele. Sel juhul töötavad platsil, kus lüliti ei tööta, hostid ainult ühe oma HBAd kaudu.
Virtuaalmasinad jätkavad tööd probleemideta.
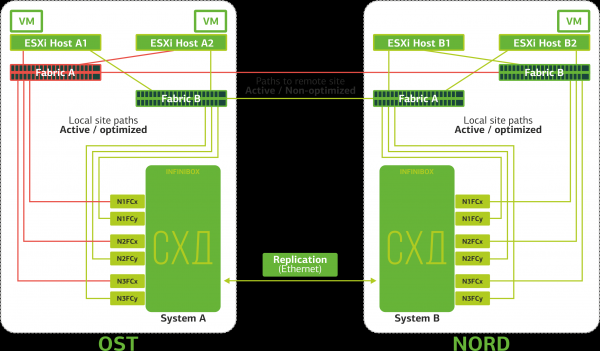
Kõik SAN-lülitid ei toimi ühel platsil. Oletame, et selline õnnetus toimub OST-platsil. Sellisel juhul kaotavad ESXi-hostid sellel platsil kõik teed oma ketta seadmetele. Sisse astub standardne VMware vSphere HA mehhanism: see taaskäivitab kõik virtuaalmasinad OST-platsil NORD-is maksimaalselt 140 sekundi jooksul.
Virtuaalmasinad, mis töötavad NORD-platsi hostides, töötavad probleemideta.
ESXi-host ei toimi ühel platsil. Siin töötab jälle vSphere HA mehhanism: rikkega hosti virtuaalmasinad taaskäivituvad teistel hostidel – samas või kaugemal asuval platsil. Virtuaalmasina taaskäivitamise aeg on kuni 1 minut.
Kui kõik ESXi-hostid OST-platsil ei tööta, ei ole võimalusi: VM-id taaskäivituvad teisel. Taaskäivitamise aeg on sama.
SAN ei tööta ühel platsil. Oletame, et SAN lõpetas töö OST-platsil. Siis suunduvad OST-platsi ESXi-hostid repliikide SAN-ide töötamisele NORD-is. Pärast rikka SAN-i taastamist toimub sundreplikatsioon, ESXi-hostid OST hakkavad jälle pöörduma kohaliku SAN-i poole.
Virtuaalmasinad töötavad kogu selle aja probleemideta.
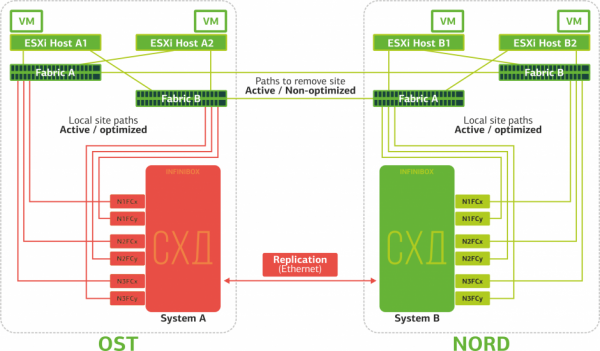
Üks plats ei toimi. Sel juhul taaskäivitatakse kõik virtuaalmasinad varuplatsi kaudu vSphere HA mehhanismi abil. Virtuaalmasina taaskäivitamise aeg on 140 sekundit. Samal ajal jäävad kõik virtuaalmasina võrgu seadistused alles ning see jääb kliendile võrgu kaudu ligipääsetavaks.
Ette võtta varuplatsi masinate taaskäivitamine ilma probleemideta, on iga plats täidetud vaid pooleldi. Teine pool on varu, juhuks kui kõik virtuaalsed masinad tuleb teisest kahjustatud platsist üle viia.
Just selliste rikete eest kaitseb katastroofitöötlus pilves, mis põhineb kahel andmekeskusel.
See nauding ei ole odav, kuna lisaks peamistele ressurssidele on vajalik varu teisel platsil. Seepärast paigutatakse sellisesse pilve äri-kriitilised teenused, mille pikaajaline seiskamine toob kaasa suuri rahalisi ja mainekahjusid, või kui teabe süsteemile on kehtestatud katastroofitöötlemise nõuded regulaatorite või ettevõtte siseeeskirjade poolt.
Allikad:
Allikas: habr.com
