

Teadus- ja arendusprojekt on kahtlemata meie õppe kõige huvitavam osa. Idee on proovida oma valdkonnas kätte saada juba ülikoolis. Näiteks lähevad tarkvaraarenduse ja masinõppe eriate üliõpilased sageli tegema teadusprojekte ettevõtetesse (peamiselt JetBrainsisse või Yandexisse, kuid mitte ainult).
Selles postituses räägin ma oma projektist infotehnoloogia valdkonnas. Projekti käigus uurisin ja rakendasin praktikas lähenemisviise ühe kõige tuntuma NP-raskete probleemide lahendamiseks: tippkatte probleem.
Praegu areneb kiiresti huvitav lähenemine NP-rasketele probleemidele — parametrisestumine algoritmid. Üritan teid teemaga kursis hoida, rääkida mõnest lihtsast parametrisest algoritmist ja kirjeldada üht võimsat meetodit, mis on mulle väga abiks olnud. Oma tulemusi esitlesin PACE Challenge'i võistlusel: avatud testide tulemuste põhjal on minu lahendus kolmandal kohal ning lõplikud tulemused selguvad 1. juulil.
Kohal
Minu nimi on Vassili Aljofirov, hetkel lõpetan kolmandat kursust HSE (Rahvusvaheline Ülikool) Peterburis. Algoritmid huvitavad mind juba koolipõlvest saadik, kui õppisin Moskvas 179. koolis ja osalesin edukalt infotehnoloogia olümpiaadidel.
Lõplik arv parametrizeeritud algoritmide spetsialiste astub baari...
Näide on võetud raamatust
Kujutage ette, et olete baarimees väikeses linnas. Igal reedel tuleb pool linna teie baari lõõgastuma, mis toob teile palju muret: peate välja viskama rahutud külastajad, et vältida kaklusi. Lõpuks hakkab see teid tüütama ja otsustate võtta ette ennetavaid meetmeid.
Kuna teie linn on väike, teate täpselt, millised paarid külastajat kõige tõenäolisemalt omavahel tülitsevad, kui nad koos baari tulevad. Teil on nimekiri n inimesest, kes tulnud täna õhtul baari. Otsustate mitte lasta baari mingisuguseid linnaelanikke nii, et keegi ei kakleks. Samas ei taha teie ülemus kaotada tulu ja oleks pettunud, kui te ei lase baari rohkem kui k inimest.
Kahjuks on ülesanne teie ees klassikaline NP-raskete probleem. Te võisite seda teada kui , või kuidas tippkatte ülesanne. Selliste ülesannete puhul ei ole üldjuhul teada algoritme, mis töötavad mõistliku aja jooksul. Kui olla täpne, siis tõendamata ja üsna tugev hüpotees ETH (Exponential Time Hypothesis) ütleb, et seda ülesannet ei saa lahendada ajaga  , see tähendab, et oluliselt paremat lahendust kui täielik proovimine pole võimalik leida. Näiteks, oletame, et teie baari on tulemas n = 1000 inimest. Siis oleks täielik proovimine
 võimaluste arvu, mis on umbes
 — meeletult palju. Õnneks on teie juhtkond seadnud teile piirangu k = 10, nii et kombinatsioonide arv, mida peate läbi vaatama, on palju väiksem: kümne elemendi alamhulkade arvu on
 . See on juba parem, kuid ikkagi ei jõua te päevaga isegi võimsas klastris kõiki kokku lugeda.
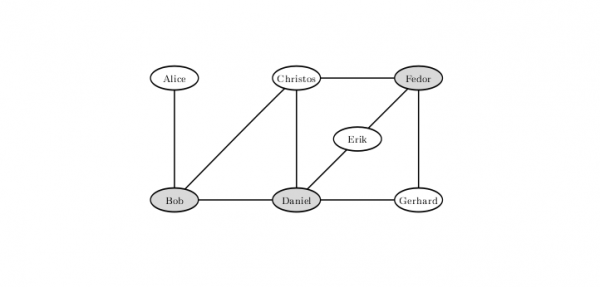
Kuna barikülastajate vahel on sellise pingelise suhte konfigureerimisega kakluste tõenäosus, ei tohi Bobi, Danieli ja Feodorit sisse lasta. Lahendus, kus jääb välja vaid kaks inimest, ei ole olemas.
Kas see tähendab, et on aeg alla anda ja kõik sisse lasta? Vaadakem teisi võimalusi. Näiteks, võib mitte lasta sisse ainult neid, kes võivad kakelda väga paljude inimestega. Kui keegi suudab kakelda vähemalt k + 1 teise inimesega, siis teda kindlasti ei tohi sisse lasta — vastasel juhul tuleb kõik k + 1 linnaelanikud, kellega ta kakelda võiks, välja jätta, mis kindlasti häirib juhtkonda.
Oletame, et olete välja visanud kõik, keda võisite, selle põhimõtte järgi. Siis saavad kõik teised kakelda mitte rohkem kui k inimesega. Neist välja visates k inimest, saate ära hoida mitte rohkem kui  konflikti. Seega, kui rohkem kui
 inimest osaleb vähemalt ühes konfliktis, siis ei suuda te neid kõiki ära hoida. Kuna, nagu selge, lastakse te kindlasti sisse täiesti konfliktitud inimesi, peate läbi vaatama kõik kümne suurused alamhulga kaheksast inimesest. Nende arv on umbes
 , ja see operatsioonide arv on juba klastris iespējams läbi vaadata.
Kui on võimalik ohutult võtta väga kokkusobivad inimesi, siis mis saab neist, kes osalevad vaid ühes konfliktis? Tegelikult saab ka neid lasta sisse, sulgedes ukse nende vastase ees. Tõsi, kui Alice on konfliktis ainult Bobiga, siis kui me lubame sisse ainult Alice, ei kaota me midagi: Bobil võivad olla teised konfliktid ja Alicel ei ole neid kindlasti. Veelgi enam, pole mõtet mitte lubada mõlemat. Pärast selliseid operatsioone jääb järele mitte rohkem  külalisi lahendamata saatusega: kokku on meil
 konflikti, igas osalevad kaks osalist ja igaüks osaleb vähemalt kahel. See tähendab, et jääb vaid läbi töötada
 varianti, mis võiks piisata poole päeva jooksul sülearvutis.
Tegelikult on lihtsate arutluste kaudu võimalik saavutada veelgi soodsamaid tingimusi. Tõdedes, et me peame kindlasti lahendama kõik vaidlused, st igast konfliktis osalevast paarist valima vähemalt ühe, keda me ei luba sisse. Vaatame sellist algoritmi: võtame mis tahes konflikti, kust eemaldame ühe osalise ja käivitame rekursiivselt ülejäänud, siis eemaldame teise ja käivitame samuti rekursiivselt. Kuna me igal sammul kedagi välja viskame, on algoritmi rekursiooni puu - binaarne puu sügavusega k, seega töötab algoritm kokku  , kus n — harude arv, ja m — servade arv. Meie näites on see umbes kümme miljonit, mis arvutatakse mitte ainult sülearvutis, vaid isegi mobiiltelefonis sekundite jooksul.
Ülaltoodud näide on näide parameetrilisest algoritmist. Parameetrilised algoritmid on algoritmid, mis töötavad ajaga f(k) poly(n), kus p — polünoom, f — suvaline arvutatav funktsioon, ja k — mõni parameeter, mis võib olla oluliselt väiksem ülesande suurusest.
Kõik eelnevad arutelud viisid näitena kerneliseerimiseni — üks levinumaid tehnikaid parameetriseeritud algoritmide loomiseks. Kerneldamine on ülesande suuruse vähendamine väärtuseni, mis on piiratud parameetri funktsiooniga. Saadud ülesannet nimetatakse sageli tervikuks. Nii saime lihtsaid mõtisklusi tippude astmete üle, et luua ruutjuur ülesanne Vertex Cover, mis on parameetriseeritud vastuse suurusega. On olemas ka teisi parameetreid, mida selle ülesande jaoks valida (nt Vertex Cover Above LP), kuid arutame just sellist parameetrit.
Pace Challenge
Võistlus (Parameetriseeritud algoritmide ja arvutuskatsete väljakutse) sai alguse 2015. aastal, et luua link parameetriseeritud algoritmide ja praktikas kasutatavate lähenemisviiside vahel arvutusprobleemide lahendamiseks. Esimesed kolm võistlust keskendusid puu laiuse leidmisele (), Štejneri puu leidmisele () ja tippude kogumite leidmisele, mis lõikavad silmuseid (). Sel aastal oli üheks ülesande varasemate seas see, millele saime oma oskusi proovile panna, nimelt ülaltoodud ülesanne tippude katmiseks.
Võistlus saavutab iga aastaga populaarsust. Eelinfo kohaselt osales sel aastal ainult tippude katmise probleemi lahendamise võistlusel 24 meeskonda. Tuleb märkida, et võistlus ei kesta mitte paar tundi ega isegi nädalat, vaid mitu kuud. Meeskondadel on võimalus uurida kirjandust, välja mõelda oma originaalne idee ja proovida see ellu viia. Sisuliselt kujutab see võistlus endast uurimustööd. Kõige tõhusamate lahenduste ideed ja auhindade jagamine toimub koos konverentsiga (Rahvusvaheline parameetriseeritud ja täpse arvutuse sümpoosion) Euroopa suurima ig年度 algoritmilise kokkusaamise raames . Täiendavat teavet võistluse kohta leiate , ja varasemate aastate tulemused on saadaval .
Lahenduse skeem
Ettevõtmiseks tippkatte ülesanne, olen proovinud rakendada parameetrilisi algoritme. Need koosnevad enamasti kahest osast: lihtsustamise reeglitest (mis ideaalis viivad kerneliseerimisele) ja jagamise reeglitest. Lihtsustamise reeglid on sisendi eeltöötlus polünoomi ajas. Nende reeglite rakendamise eesmärk on ülesande vähendamine ekvivalentseks väiksema suurusega ülesandeks. Lihtsustamise reeglid on algoritmi kõige kulukam osa ja just selle osa rakendamine viib üldise töötamise ajani.  nagu tavaline polünoomi aeg. Meie puhul põhinevad jagamise reeglid sellel, et iga tipu puhul tuleb võtta kas see või tema naaber.
Üldine skeem on järgmine: rakendame lihtsustamise reegleid, seejärel valime mingi tipu ja teeme kaks rekurssi kutsumist: esimeses võtame selle vastuseks, teises võtame kõik tema naabrid. Seda nimetame selle tipu järgi jagamiseks (branching).
Skeemile lisatakse täpselt üks täiendav element järgmises lõigus.
Ideed jagamise (branching) reeglite jaoks
Rääkigem sellest, kuidas valida tipp, mille põhjal toimib jagamine.
Peamine idee on algoritmilises mõttes väga ahne: võtame tipu maksimaalse astmega ja jagame selle järgi. Miks tundub, et see on parem? Sest teises rekurssi kutsumise haru me seeläbi eemaldame väga palju tippe. Võime arvata, et jääb väike graaf ja sellel me töötame kiiresti.
See lähenemine, mis koosneb juba arutatud lihtsatest kerneliseerimise tehnikatest, näitab end korralikult ja lahendab mõningaid teste, mille suurus on mitu tuhat tippu. Kuid näiteks töötab see halvasti kuup-graafide puhul (st graafide, mille iga tipu aste on kolm).
On veel üks idee, mis põhineb piisavalt lihtsal mõttel: kui graaf on ühendamata, saab selle sidususe komponente sõltumatult lahendada, kombineerides vastused lõpuks. See on muide väike lubatud modifikatsioon skeemis, mis kiirendab lahendust oluliselt: varem töötasime sellisel juhul vastuste komponentide loendamise aegade korrutise alusel, nüüd aga summeerime. Ja jagamise kiirendamiseks tuleb muuta ühendatud graaf ühendamatuks.
Kuidas seda teha? Kui graafis on lõikepunkt, tuleb just selle järgi jaguneda. Lõikepunkt on selline tipp, mille eemaldamisel kaotab graaf ühenduvuse. Kõiki lõikepunkte graafis saab leida klassikalise algoritmi abil lineaarse ajaga. Selline lähenemine kiirendab oluliselt jagunemist.
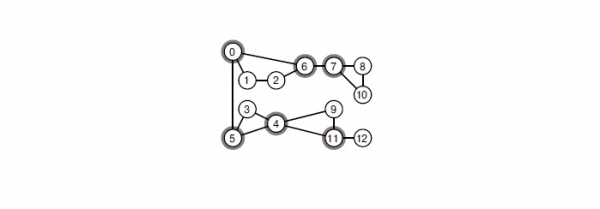
Iga välja toodud tipu eemaldamisel jaguneb graaf ühenduvuseks komponentideks.
Seda me teeme, kuid sooviksime rohkem. Näiteks otsida graafis väikseid tippude lõikeid ja jagada nende järgi. Kõige tõhusam tuntud viis minimaalse globaalse tippude lõike leidmiseks on kasutada Gomori-Hu puud, mis ehitatakse kubikaajas. PACE Challenge'is on tüüpiline graafi suurus mitu tuhat tippu. Sellise olukorra puhul peab iga rekursiooni tipu juures sooritama miljardeid toiminguid. Tundub, et antud aja jooksul selle ülesande lahendamine on lihtsalt võimatu.
Proovime lahendust optimeerida. Minimaalne tippude lõige kahe tipuu vahel saab leida igasuguste algoritmide abil, mis ehitavad maksimaalset voolu. Saame sellele võrgule rakendada , mis praktikas töötab väga kiiresti. Mul on kahtlus, et teoreetiliselt on võimalik tõestada ajakulu hindamist  , mis on juba täiesti vastuvõetav.
Olen proovinud mitu korda otsida lõikeid juhuslike tipude vahel ja võtta neist kõige tasakaalustatum. Kahjuks andis see PACE Challenge'i avatud testides halbu tulemusi. Võrdlesin algoritmi, mis jagab maksimaalse astmega tipude järgi, käivitades neid süvendi süvenemise piiramisega. Pärast algoritmi, mis püüdis leida lõiget sellisel viisil, jäi alles suuremate suurustega graaf.
On tähelepanuväärne, et teoreetiliselt kiirete algoritmide artiklites kasutatakse palju arenenumaid tehnikaid tippude valimiseks jagamiseks. Need tehnikad on väga keerulise rakendusega ja neil on sageli halvad ajakulu ja mälu hinnangud. Ma ei suutnud neist välja valida praktiliseks täiesti vastuvõetavaid.
Kuidas rakendada lihtsustamise reegleid
Meil on juba kernelisatsiooni ideed. Tuletan meelde:
- Kui on isoleeritud tipp, eemaldada see.
- Kui on tipptase 1, eemaldage see ja võtke selle naaber vastuseks.
- Kui vähemalt on tipptase k + 1, võtke see vastuseks.
Kahes esimeses on kõik selge, kolmandaga on üks näpukas. Kui naljaliselt ülesandes baaris oli meil antud ülempiir k, siis PACE Challenge'is peame lihtsalt leidma minimaalsete tipupõhjendustega katte. See on tüüpiline otsimisprobleemide (Search Problem) ja lahendamisprobleemide (Decision Problem) üleminek, sageli kahe probleemi vahel ei tehta vahet. Praktikas, kui me kirjutame tipukatte lahendajat, võib vahe olla. Näiteks nagu kolmandas punktis.
Rakenduse seisukohalt on võimalus läheneda kahel viisil. Esimene lähenemine nimetatakse Iterative Deepening. See seisneb selles, et saame alustada mõnelt mõistlikult põhjalikes piirangutest ja käivite edasi oma algoritmi, kasutades seda piirangut ülempiirina, mitte laskudes rekursioonidesse madalamale, kui see piirang. Kui oleme leidnud mingi vastuse, on see garanteeritult optimaalselt, vastasel juhul saame seda piirangut ühe võrra suurendada ja uuesti käivitada.
Teine lähenemine on hoida mõningat praegust optimaalse vastuse ja otsida väiksema suurusega vastust, muutes selle parameetri leides k liigne jooksu harude kiireks kärpimiseks.
Pärast mitmeid öiseid eksperimente jäin ma kahe meetodi kombinatsiooni juurde: kõigepealt käivitan oma algoritmi mingi otsimise sügavuse piirangu (valides selle nii, et see võtaks võrreldes peamise lahenduse absoluutselt aeglaselt) ja kasutan parimat leitud lahendust ülempiirina - see tähendab seda k.
Tipud tasemel 2
Tipude tasemetega 0 ja 1 oleme koos olnud. Selgub, et sellist saab teha ka tippude tasemel 2, kuid selle jaoks on graafilt vaja keerukamaid operatsioone.
Selle selgitamiseks tuleb kuidagi nimetada tipud. Nimetame tasemel 2 tipu 'tipuks' v, ja selle naabriteks 'tipud' x ja y. Edasi on meil kaks juhtumit.
- Kui x ja y — naabrid. Siis saab vastuseks võtta x ja y, vaid v eemaldada. Ja tõepoolest, sellest kolmnurgast tuleb vähemalt kaks tippu võtta vastuseks ja me ei kaota kindlasti, kui võtame x ja y: neil on tõenäoliselt veel naabreid ja v neil ei ole.
- Kui x ja y — mitte naabritega. Siis väidetakse, et kõik kolm tippu on võimalik kokku liita üheks. Idee on selles, et sel juhul on olemas optimaalne vastus, kuhu me võtame kas v, või mõlemad tippud x ja y. Tingimusel, et esimesel juhul peame võtma vastuseks kõik naabrid x ja y, aga teisel juhul ei ole see tingimata vajalik. See vastab täpselt juhtumitele, kui me ei võta kokku liidetud tippu vastuseks ja kui võtame. Peab vaid märkima, et mõlemal juhul väheneb vastus pärast seda operatsiooni ühe võrra.
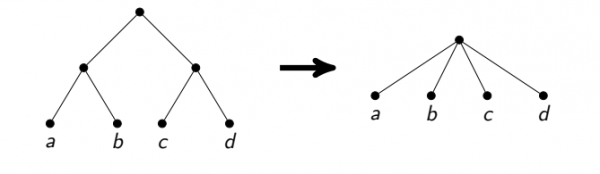
Tuleb märkida, et sellise lähenemise rakendamine ausalt lineaarses ajas on üsna keeruline. Tippude kokku liitmine on keeruline operatsioon, mille käigus tuleb kopida naaberlistid. Kui seda ei tehta ettevaatlikult, võib tulemuseks olla asümptootiliselt mitteoptimaalne tööaeg (näiteks, kui pärast iga kokku liitmist kopeeritakse palju ääriseid). Olen peatunud kahe astmega tippudest tervete teede leidmisega ja paljude erijuhtumite, näiteks tsüklite, analüüsimisega nendest tippudest või kõigist neist, välja arvatud üks.
Lisaks peab see operatsioon olema pööratav, et saaksime rekursioonist välja naastes taastada graafi algse kujundi. Selle tagamiseks ei olen ma puhastanud kokku liidetud tippude ääriste listid, pärast mida ma teadsin lihtsalt, kuhu ääriseid suunata. Selline graafide teostamine nõuab samuti ettevaatlikkust, kuid tagab ausa lineaarse aja. Ja paarikümne tuhande äärisega graafid mahuvad suurepäraselt protsessori vahemälu, mis annab kiirusel suured eelised.
Lineaarne südamik
Lõpuks, kõige huvitavam osa südamikust.
Käesolevalt tuletame meelde, et kahepoolsetes graafides saab minimaalset tipu katet otsida  . Selleks tuleb kasutada algoritmi , et leida sealt maksimaalne paaristamine, ja seejärel kasutada .
Lineaarse südamiku idee on järgmine: esmalt jagame graafi kaheks, see tähendab, et iga tipu asemel v loome kaks tippu  ja
 , ja iga äärise asemel u — v loome kaks äärist.
 ja
 Saadud graaf on kahetipuline. Leiame selles minimaalset tipu katet. Osad algse graafi tipud satuvad sinna kaks korda, osad ainult korra ja mõned – mitte kunagi. Nemhauseri-Trotteri teoreem väidab, et sel juhul võib eemaldada tipud, mis ei sattunud kunagi, ja vastuseks võtta need, mis sisenesid kaks korda. Veelgi enam, see ütleb, et jäänud tipud (need, mis sattusid üks kord) peavad vastusena andma vähemalt poole.
Just õppisime, kuidas jätta graafikesse mitte rohkem kui 2k tipu. Ja tõepoolest, kui jääb vastuseks vähemalt pool kõigist tipudest, siis ei ole seal tippe rohkem kui 2k.
Siin olen suutnud teha väikese edusammu. On selge, et sellisel viisil koostatud süda sõltub sellest, milline minimaalne tipu kate kahetipulises graafis me valisime. Sooviksin valida sellise, et jäänud tippude arv oleks minimaalne. Varem osati seda teha ainult ajaga  . Mina olen aga välja mõelnud selle algoritmi rakenduse ajaga
 , seega saab seda süda otsida graafides, kus on sadu tuhandeid tippe igal harutamisetapil.
Tulemus
Praktika näitab, et minu lahendus töötab hästi testidel, kus on mitu sada tippu ja mitu tuhat serva. Sellistel testidel võib oodata, et lahendus leitakse poole tunni jooksul. Vastuse leidmise tõenäosus tõepoolest suureneb, kui graafis on piisavalt palju kõrge sõltuvuse tippe, näiteks sõltuvus 10 ja rohkem.
Võistlusel osalemiseks tuli lahendused saata aadressile . Kohtade tabeli põhjal, mis seal esitatud on, Tulemused suletud testidel selguvad 1. juulil.
Teaduslik uurimistöö on ilmselt kõige huvitavam osa meie õpingutest. Idee on selles, et juba ülikoolis proovida ennast valitud suunas.
Allikas: habr.com
