

A group of researchers from American, Australian, and Israeli universities has proposed a new side-channel attack technique to exploit Spectre vulnerabilities in browsers based on the Chromium engine. The attack, codenamed Spook.js, allows the execution of JavaScript code to bypass the site isolation mechanism and read the entire address space of the current process, meaning it can access data from pages opened in other tabs but processed in the same process.
Since Chrome runs different sites in separate processes, the possibility of carrying out practical attacks is limited to services that allow different users to host their pages. This method enables the attacker, from a page where they can embed their JavaScript code, to determine if other pages opened by the user are from the same site and extract confidential information from them, such as credentials or banking details populated by the auto-fill system in web forms. As a demonstration, it shows how one can attack someone else's blog on the Tumblr service if its owner opens a tab with the attacker’s blog hosted on the same service.
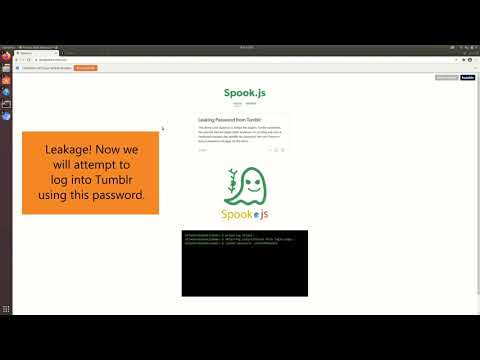
Another application of the method involves attacking browser extensions, allowing data extraction from other extensions when an extension controlled by the attackers is installed. For example, it demonstrates how a malicious extension can extract confidential information from the LastPass password manager.
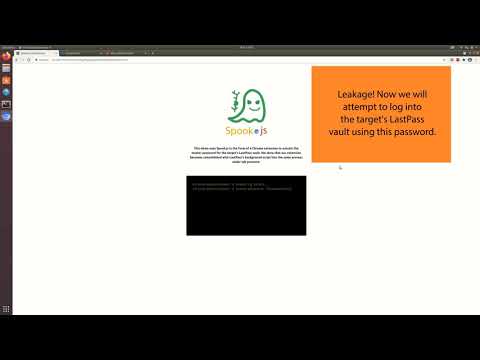
Researchers have published a prototype exploit that operates in Chrome 89 on systems with Intel i7-6700K and i7-7600U CPUs. In creating the exploit, previously published JavaScript code prototypes for executing Spectre-type attacks by Google were used. It is noted that the researchers have managed to develop working exploits for systems based on Intel and Apple M1 processors, allowing them to read memory at a speed of 500 bytes per second with 96% accuracy. It is assumed that the method is applicable to AMD processors as well, although a fully functional exploit has not been successfully prepared.
Rünnak sobib igasuguste Chromiumi-põhiste brauserite, sealhulgas Google Chrome'i, Microsoft Edge'i ja Brave'i jaoks. Uurijad usuvad ka, et meetod võib olla kohandatud töötama Firefoxiga, kuid kuna Firefoxi mootor erineb Chrome'ist oluliselt, siis on sarnase eksploitatsiooni loomine jäänud tulevikku.
Rünnakute vältimiseks, mis on seotud spekulatiivse käskude täitmisega brauseri kaudu, on Chrome'is rakendatud aadressiruumi segmentimist - liivakasti isolatsioon võimaldab JavaScripti kasutada ainult 32-bitiste näidikutega ning jagab töötlejate mälu eraldi, mittetäielikes 4 GB hunnikutes (heap). Kogu protsessi aadressiruumi ligipääsu korraldamiseks ja 32-bitise piiri ületamiseks kasutasid uurijad Type Confusion tehnikat, mis sunnib JavaScripti mootori töötlema objekti vale tüübiga, võimaldades luua 64-bitise näidiku kahe 32-bitise väärtuse kombinatsiooni põhjal.
Rünnaku olemus seisneb selles, et spetsiaalselt vormindatud pahatahtliku objekti töötlemisel JavaScripti mootori sees tekivad tingimused, mis viivad spekulatiivsete käskude täitmiseni, mis pääsevad juurde massiivile. Objekt valitakse nii, et ründajate kontrollitavad väljad paiknevad piirkonnas, kus kasutatakse 64-bitist näidikut. Kuna pahatahtliku objekti tüüp ei vasta töödeldava massiivi tüübile, blokeerib Chrome'i koodide deoptiimeerimise mehhanism, mis on ette nähtud massiividele juurde pääsemiseks, tavaliselt selliseid toiminguid. Selle probleemi lahendamiseks viidatakse Type Confusion rünnaku kood tingimuslikku blokki „if”, mis ei aktiveeru tavatingimustes, kuid töötab spekulatiivses režiimis, kui protsessor ennustab vale harunemist.
Protsessor teeb spekulatiivse pöörde moodustatud 64-bitisesse aadressi ja taastab oleku pärast ebaõnnestunud prognoosi määramist, kuid käitamise jäljed jäävad üldisesse vahemällu ja neid saab taastada vahemälu sisu määratlemise meetodite abil, mis analüüsivad juurdepääsuaja muutust vahemälus ja mitte-vahemälus andmetele. Vahemälu sisu analüüsimiseks, kus JavaScriptis on kellaga seotud täpsus ebapiisav, rakendatakse Google'i poolt pakutud meetodit, mis petab protsessorites kasutatavat Tree-PLRU andmete eemaldamise strateegiat, võimaldades tsüklite arvu suurendamise kaudu märkimisväärselt suurendada aega, mis eristab vahemälus oleva ja mitteoleva väärtuse olemasolu.
Allikas: opennet.ru
