

30. november – 1. detsember toimus Nizhni Novgorodis. Osalejatele pakuti võimalust luua tooteprototüüpi, kasutades Intel OpenVINO tööriistu. Korraldajad esitasid soovitusliku teemade loendi, millele orienteeruda, kuid lõplik otsus jäi tiimide otsustada. Samuti julgustati kasutama mudeleid, mis ei kuulu toote koosseisu.
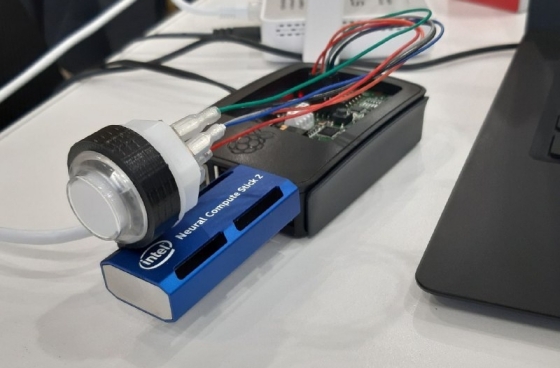
Artiklis räägime sellest, kuidas me lõime oma tooteprototüübi, millega lõpuks saavutasime esimese koha.
Hackathonil osales üle 10 tiimi. Tore on, et mõned neist tulid teistest piirkondadest. Hackathoni toimumiseks valiti “Kreml Kremli kanalil” kompleks, kus olid väljapanekud vanadest Nizhni Novgorodi fotodest, atmosfääriliselt! (meenutan, et praegu asub Intel'i keskasutus just Nizhni Novgorodis). Osalejatele anti koodi kirjutamiseks aega 26 tundi, lõpuks tuli oma lahendus esitleda. Üheks plussiks oli demo-sessiooni olemasolu, et veenduda, et kõik ellu viidud ideed ei jää ainult esitlusse. Ka kaubad, suupisted ja toit olid olemas!
Lisaks pakkus Intel soovi korral kaamerad, Raspberry PI'd, Neural Compute Stick 2.
Ülesande valik
Üks keerukamaid osi avatud teemadega hackathonile valmistumisel on ülesande valimine. Otsustasime kohe välja mõelda midagi, mida tootest veel ei leidu, kuna teadaanne ütles, et seda tervitatakse.
Analüüsides , mis praeguses väljaandes toote koosseisu kuuluvad, jõuame järeldusele, et enamik neist lahendab erinevaid arvutinägemise ülesandeid. On väga keeruline välja mõelda arvutinägemise ala ülesannet, mille lahendamiseks ei saaks OpenVINO't kasutada, ja kui selline ülesanne ka olemas on, siis on raske leida eelõpetatud mudeleid avatud juurdepääsuga. Otsustame kaevata veel ühes suunas – kõne töötlemise ja analüüsi poole. Uurime huvitavat ülesannet kõne emotsioonide tuvastamiseks. Tuleb öelda, et OpenVINO's on juba mudel, mis määrab inimese emotsioonid näo järgi, kuid:
- Teoorias on võimalik luua kombineeritud algoritm, mis töötab nii heli kui ka pildi põhjal, mis peaks suurendama täpsust.
- Kaamerad on tavaliselt kitsaste vaatenurkadega, seega vajatakse suure ala katmiseks mitut kaamerat, heli ei oma sellist piirangut.
Arendame ideed: võtame aluseks jaemüügisektori idee. Klientide rahulolu saab määrata kaupluste kassades. Kui mõni klient on teenindusega rahulolematu ja hakkab häält tõstma, saab kohe administraatori abi kutsuda.
Sel juhul tuleb lisada inimese hääletuvastus, mis võimaldab meil eristada poe töötajaid ostjatest ning saada analüütikat iga indiviidi kohta. Lisaks sellele saame analüüsida ka poe töötajate käitumist ning hinnata meeskonna atmosfääri, see kõlab hästi!
Koostame nõuded meie lahendusele:
- Sihtseadme väike suurus
- Töötamine reaalajas
- Madal hind
- Lihtne skaleeritavus
Lõpuks valime sihtseadmeks Raspberry Pi 3 koos .
Siin on oluline märkida üht olulist omadust NCS-i kohta — see töötab kõige paremini standardsete CNN arhitektuuridega, kuid kui on vajalik käivitada sellised mudelid, kus on kohandatud kihid, siis oodake madalate tasemete optimeerimisega seotud tantsu.
Mis seal ikka: tuleb leida mikrofon. Sobib ka tavaline USB-mikrofon, kuigi see ei vaata koos RPI-ga hea välja. Kuid ka siin on lahendus praktiliselt "käeulatuses". Hääle salvestamiseks otsustame kasutada Voice Bonnet kaarti komplektist , millel on paigaldatud stereomikrofon.
Laadige Raspbian alla ja laadige see mälupulgale, testige, et mikrofon töötab järgmise käsuga (see salvestab 5-sekundilise audio ja salvestab faili):
arecord -d 5 -r 16000 test.wavTahan kohe märkida, et mikrofon on väga tundlik ja püüab hästi häälestamine. Selle parandamiseks siseneme alsamixerisse, valime Capture devices ja langetame sisendsignaali taset 50-60%-ni.
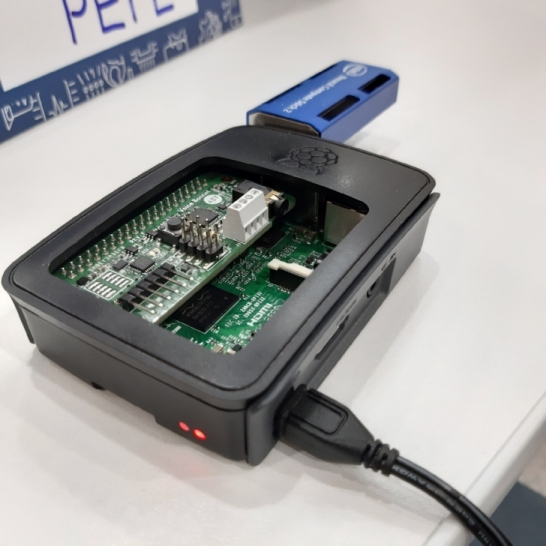
Viimistleme korpuse viiliga ja kõik mahub sisse, isegi kaane saame sulgeda.
Lisame indikaatorklõpsu.
AIY Voice Kit'i lahti võtmise ajal meenutame, et seal on RGB-nupp, mille valgustust saab programmiliselt juhtida. Otsime "Google AIY Led" ja leidsime dokumentatsiooni:
Miks mitte kasutada seda nuppu tuvastatud emotsiooni kuvamiseks, meil on vaid 7 klassi, kuid nupul on 8 värvi, just piisavalt!
Ühendame nuppu GPIO kaudu Voice Bonnet'iga, laadime vajalikud teegid (need on juba AIY projektide jaotises installitud)
from aiy.leds import Leds, Color
from aiy.leds import RgbLeds
Loome dict, kus igale emotsioonile vastab värv RGB Tuple formaadis ja aiy.leds.Leds klassi objekt, mille kaudu värvi uuendame:
led_dict = {'neutral': (255, 255, 255), 'happy': (0, 255, 0), 'sad': (0, 255, 255), 'angry': (255, 0, 0), 'fearful': (0, 0, 0), 'disgusted': (255, 0, 255), 'surprised': (255, 255, 0)}
leds = Leds()
Ja lõpuks, pärast iga uut emotsiooni ennustust uuendame nupu värvi vastavalt sellele (võtme alusel).
leds.update(Leds.rgb_on(led_dict.get(classes[prediction])))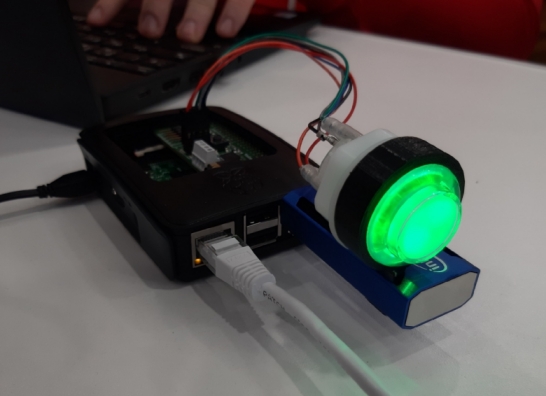
Nupp, süüta!
Töötame häälega
Kasutame pyaudio't mikrofonist voolu salvestamiseks ja webrtcvad'i müra filtreerimiseks ning hääle tuvastamiseks. Lisaks loome järjekorra, kuhu lisame ja kust võtame asünkroonselt helinatuke.
Kuna webrtcvad'il on piirmäär sisendfragments - see peab olema 10/20/30 ms, ja emotsioonide tuvastamiseks mudeli koolitamine (nagu me hiljem teada saame) toimus 48kHz andmestikul, siis salvestame 48000×20ms/1000×1 (mono) = 960 baiti suurused tükid. Webrtcvad tagastab True/False iga sellise tüki kohta, mis vastab hääle olemasolule või puudumisele.
Rakendame järgmise loogika:
- Lisame list'i need tükid, kus on hääl; kui häält pole, suurendame tühi tükki loenduri.
- Kui tühi tükkide loendur >=30 (600 ms), siis vaatame akumuleeritud tükkide suurust; kui see >250, lisame järjekorda; kui mitte, siis loeme, et salvestamise pikkus ei ole piisav, et esitada see mudelile kõnelejate tuvastamiseks.
- Ja kui tühi tükki loendur on endiselt < 30, kuid akumuleeritud tükkide suurus ületab 300, lisame tükikese järjekorda täpsema ennustuse jaoks. (sest emotsioonidele on aja jooksul iseloomulik muutuda)
 def to_queue(frames):
    d = np.frombuffer(b''.join(frames), dtype=np.int16)
    return d

framesQueue = queue.Queue()
def framesThreadBody():
    CHUNK = 960
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 48000

    p = pyaudio.PyAudio()
    vad = webrtcvad.Vad()
    vad.set_mode(2)
    stream = p.open(format=FORMAT,
                channels=CHANNELS,
                rate=RATE,
                input=True,
                frames_per_buffer=CHUNK)
    false_counter = 0
    audio_frame = []
    while process:
        data = stream.read(CHUNK)
        if not vad.is_speech(data, RATE):
            false_counter += 1
            if false_counter >= 30:
                if len(audio_frame) > 250:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
                    false_counter = 0

        if vad.is_speech(data, RATE):
            false_counter = 0
            audio_frame.append(data)
            if len(audio_frame) > 300:
                framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
On jäänud aeg otsida avalikest allikatest eelõpetatud mudeleid, suundume githubi, otsime google'ist, kuid peame meeles pidama, et meil on arhitektuuri kasutamise osas piirangud. See on üsna keeruline osa, kuna tuleb testida mudeleid oma sisendandmetega ja peale selle konverteerida need OpenVINO sisemisse formaati — IR (Intermediate Representation). Oleme proovinud umbes 5-7 erinevat lahendust githubist, ja kuigi emotsioonide tuvastamise mudel töötas kohe, siis hääle tuvastamiseks tuli kauem vaeva näha — seal kasutatakse keerukamaid arhitektuure.
Peatutakse järgmistele:
- Hääljõududest emotsioonid —
See töötab järgmise põhimõtte järgi: heli jagatakse kindla suurusega lõikudeks, iga lõigu puhul eraldame ja toome need siis sisse CNN-i - Hääletuvastus —
Siin töötame MFCC asemel spektraalide peal, pärast FFT-d toome signaali CNN-i, kus saame väljundina hääle vektorise esinduse.
Edasi räägime mudelite konverteerimisest, alustame teooriast. OpenVINO sisaldab mitmeid mooduleid:
- Open Model Zoo, mille mudeleid sai kasutada ja oma toote sisse lisada
- Model Optimizer, mille abil saab konverteerida mudelit erinevates formaadist raamistikest (Tensorflow, ONNX jne) Intermediate Representation formaati, millega me hiljem töötame
- Inference Engine võimaldab käivitada mudeleid IR formaadis Intel'i protsessoritel, Myriad kiipidel ja Neural Compute Stick kiirenditel
- Tõhusaim versioon OpenCV-st (Inference Engine'i toega)
Iga mudel IR formaadis on kirjeldatud kahe failiga: .xml ja .bin.
Mudeleid konverteeritakse IR formaati Model Optimizer abil järgmiselt:python /opt/intel/openvino/deployment_tools/model_optimizer/mo_tf.py --input_model speaker.hdf5.pb --data_type=FP16 --input_shape [1,512,1000,1]--data_typevalib valima andmeid, millega mudel töötab. Toetatakse FP32, FP16, INT8. Optimaalse andmeformaadi valimine võib anda hea kasvu jõudluses.
--input_shapenäitab sisendandmete mõõtmeid. Dünaamilise muutmise võimalus näib olevat C++ API-s, kuid me ei uurinud seda nii sügavale ja kinnitasime selle ühe mudeli jaoks lihtsalt.
Järgmisena proovime laadida juba konverteeritud mudeli IR formaadis OpenCV DNN mooduli kaudu ja teha sellele forward.import cv2 as cv emotionsNet = cv.dnn.readNet('emotions_model.bin', 'emotions_model.xml') emotionsNet.setPreferableTarget(cv.dnn.DNN_TARGET_MYRIAD)Viimane rida selles kontekstis suunab arvutused Neural Compute Stick'ile, põhimõtteliselt toimuvad arvutused protsessoril, kuid Raspberry Pi puhul ei sobi see, vajame stick'i.
Järgmisena on loogika järgmine: jagame oma audio kindla suurusega akendeks (meie puhul 0,4s), iga selline aken muudetakse MFCC-ks, mis siis antakse võrku:
emotionsNet.setInput(MFCC_from_window)
result = emotionsNet.forward()
Pärast seda võtame kõige sagedamini esineva klassi kõigist akendest. Lihtne lahendus, kuid hackathon'i jaoks ei ole liiga keerulist midagi välja mõelda, kui on aega. Meil on veel palju tööd, seega liigume edasi — uurime hääletuvastust. Peame looma andmebaasi, kuhu salvestatakse eelnevalt salvestatud häälte spektraalid. Kuna aega on jäänud vähe, lahendame selle küsimuse nii hästi kui oskame.
Ehkki, loome skripti hääle lõigu salvestamiseks (see töötab sama moodi nagu eespool kirjeldatud, ainult et klaviatuurilt katkestamisel salvestab see hääle faili).
Proovime:
python3 voice_db/record_voice.py test.wavSalvestame mitme inimese hääli (meie puhul kolme meeskonnaliikme hääli)
Seejärel teeme iga salvestatud hääle korral kiire või palju transformatsiooni, saame spektraali ja salvestame selle numpy massiivina (.npy):for file in glob.glob("voice_db/*.wav"): spec = get_fft_spectrum(file) np.save(file[:-4] + '.npy', spec)Rohkem teavet failis
create_base.py
Lõpuks, kui käivitatakse põhiskript, saame alguses need spektraalide embeddingud:for file in glob.glob("voice_db/*.npy"): spec = np.load(file) spec = spec.astype('float32') spec_reshaped = spec.reshape(1, 1, spec.shape[0], spec.shape[1]) srNet.setInput(spec_reshaped) pred = srNet.forward() emb = np.squeeze(pred)Pärast helikatke väljavõtmist saame määrata, kellele see kuulub, võttes kosinus-distaansi katke ja kõigi andmebaasi hääle vahel (mida väiksem, seda tõenäolisem) — demo jaoks seadsime valiku piiri 0.3):
        dist_list = cdist(emb, enroll_embs, metric="cosine")
        distances = pd.DataFrame(dist_list, columns = df.speaker)
Lõpetuseks märgin, et inferentsi kiirus oli kiire ning võimaldas lisada veel 1-2 mudelit (7-sekundilise näidise inferentsiks kulus 2.5). Uute mudelite lisamisega me enam õigeks ajaks ei jõudnud ja keskendusime veebirakenduse prototüübi kirjutamisele.
Veebirakendus
Oluline punkt: võtame kaasa kodus oleva ruuteri ja seadistame oma kohaliku võrgu, see aitab ühendada seadmeid ja sülearvuteid võrku.
Tagaplaan esindab pidevat sõnumite kanalit esiplaani ja Raspberry Pi vahel, mis põhineb websocket tehnoloogial (http üle tcp protokolli).
Esimene etapp on töötlemise teabe hankimine Raspberry Pi’lt, st JSON-formaadis prognoosid, mis oma teekonna keskosas salvestatakse andmebaasi, et saaksime koostada statistikat kasutaja emotsionaalsest taustast ajavahemikus. Edasi saadetakse see pakett esiplaani, mis kasutab tellimust ja pakettide vastuvõttu websocketi lõpp-punktist. Kogu tagaplaani mehhanism on üles ehitatud Golangi keeles, valik langes sellele, kuna see sobib hästi asünkroonseteks ülesanneteks, millega gorutiinid hästi toime tulevad.
Lõpp-punkti juures registreeritakse kasutaja ja kantakse struktuuri, seejärel toimub tema sõnumi vastuvõtmine. Nii kasutaja kui sõnum registreeritakse ühises hubis, millest sõnumid saadetakse edasi (tellitud esiplaani), ja kui kasutaja sulgeb ühenduse (Raspberry Pi või esiplaan), lõpetatakse tema tellimus ja ta eemaldatakse hubist.
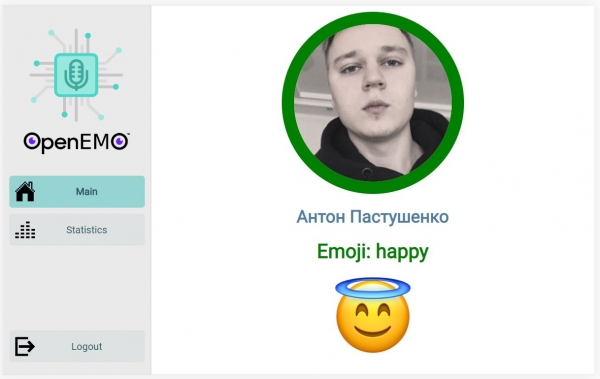
Ootame ühendust tagaprogrammigaFront-end on web-rakendus, mis on kirjutatud JavaScriptis ja kasutab Reacti teeki arenduse kiirendamiseks ja lihtsustamiseks. Selle rakenduse eesmärk on visualiseerida andmeid, mis on saadud back-endi poolel käivitatud algoritmide abil ja otse Raspberry Pi-lt. Lehelt leiab sektsioonide vahel navigeerimise, mis on teostatud react-routeri abil, kuid peamine huvi pakub esileht, kus reaalajas voolab serverilt pidev andmete voog WebSocketi tehnoloogia kaudu. Raspberry Pi tuvastab häält, määrab kindlaks, kellele see kuulub registreeritud andmebaasis, ja saadab kliendile tõenäosuste loendi. Klient kuvab viimased asjakohased andmed, kuvab inimese avatar, kellel on kõige tõenäolisem räägitu mikrofonis, samuti emotsiooni, millega ta sõnu ütleb.

Esileht uuenevate ennustustegaKokkuvõte
Me ei jõudnud kõike lõpule viia, aega lihtsalt ei piisanud, seetõttu oli peamine lootus demole, et kõik töötab. Eeskujul räägiti sellest, kuidas kõik on korraldatud, milliseid mudeleid on kasutatud ja millega oleme silmitsi seisnud. Seejärel toimus demoaeg - eksperdid käisid saalis juhuslikus järjestuses ja lähenesid igale meeskonnale, et vaadata töötavat prototüüpi. Nad esitasid küsimusi ka meile, igaüks vastas oma osa kohta, arvutis oli veeb ja kõik toimis tõeliselt nagu ootatud.
Toote kogumaksumus oli 150$:
- Raspberry Pi 3 ~ 35$
- Google AIY Voice Bonnet (võib kasutada respeakeri plaati) ~ 15$
- Intel NCS 2 ~ 100$
Kuidas parandada:
- Kasutada kliendi registreerimist - paluda lugeda teksti, mille genereerime juhuslikult
- Lisada veel mitmeid mudeleid: hääle abil saame määrata soo ja vanuse
- Erinevaid samal ajal kostvaid hääli eristama (diariseerimine)
Repo:

Väsinud, aga õnnelikud olemeLõpetuseks tahaksin tänada korraldajaid ja osalejaid. Teiste meeskondade projektidest meeldis meile isiklikult lahendus parkimiskohtade jälgimiseks. See oli meie jaoks äärmiselt vinge kogemus tootmisse ja arendusse süveneda. Loodan, et piirkondades korraldatakse üha rohkem huvitavaid üritusi, sealhulgas AI-teemal.
Allikas: habr.com
