

Masinõppe tarkvarakuud on sageli keerulised ja üsna eksitavad. Vigade avastamine ja kõrvaldamine on ressursimahukas ülesanne. Isegi kõige lihtsamad nõuavad tõsist lähenemist võrgu arhitektuurile, kaalu algatamisele ja võrgu optimeerimisele. Väike viga võib tuua kaasa ebameeldivaid probleeme.
See artikkel on pühendatud teie neuronvõrkude silumise algoritmile.
Skillbox soovitab: Praktiline kursus .
Tuletame meelde: kõigile «Habr» lugejatele – 10 000 rubla allahindlus igale Skillboxi kursusele, kasutades sooduskoodi «Habr».
Algoritm koosneb viiest etapist:
- lihtne algus;
- kaotuste kinnitamine;
- vahepealsete tulemuste ja ühenduste kontrollimine;
- parameetrite diagnostika;
- töö jälgimine.
Kui midagi tundub teile huvitavam kui ülejäänud, võite kohe nendele jaotistele liikuda.
Lihtne algus
Keerulise arhitektuuri, regulatsiooni ja õppimise kursi plaanijaga neuronvõrgu silumine on keerulisem kui tavaline. Me natuke petame siin, kuna see punkt seondub silumisega kaudselt, kuid see on siiski oluline soovitus.
Lihtne algus seisneb lihtsustatud mudeli loomises ja selle koolitamises ühes andmestikus (punktis).
Esmalt loome lihtsustatud mudeli
Kasutades kiiret algust, loome väikese võrgu, millel on ainult üks peidetud kiht, ja kontrollime, et kõik töötaks õigesti. Siis keerame järk-järgult mudeli keerukamaks, kontrollides iga uut aspekti selle struktuurist (täiendavat kihti, parameetrit jne) ja liigume edasi.
Koolitame mudelit ühes andmestikus (punktis)
Kiireks kontrollimiseks, kas teie projekt töötab, võite kasutada ühe või kahe andmepunkti koolitamiseks, et kinnitada, kas süsteem töötab õigesti. Neuronvõrk peaks näitama 100% täpsust koolitusel ja testimisel. Kui see nii ei ole, on mudel liiga väike või on teil juba viga olemas.
Isegi kui kõik on hea, valmistage mudel ette möödumiseks ühe või mitme epohhi kaudu enne, kui liigute edasi.
Kaotuste hindamine
Kaotuste hindamine on peamine meetod mudeli jõudluse täpsustamiseks. Teil on oluline veenduda, et kaotus vastab ülesandele ning kaotuse funktsioonid hinnatakse õige skaalal. Kui kasutate rohkem kui ühte tüüpi kaotust, veenduge, et kõik need oleksid ühe suurusjärgu ja õigesti skaleeritud.
Oluline on olla tähelepanelik algsete kaotuste suhtes. Kontrollige, kui lähedane on tegelik tulemus oodatavale, kui mudel alustas juhuslikust oletusest. V : „Veenduge, et saate tulemuse, mida ootate, alustades väikese arvu parameetritega. On parem kohe kontrollida andmekao (regulaarimise määra seadmine nullile). Näiteks CIFAR-10 puhul, kasutades Softmax klassifikaatorit, oodata algseid kaotusi, mis oleks 2.302, kuna eeldatav difusioonitõenäosus on 0,1 iga klassi kohta (kuna klasse on 10), ja Softmax kaotus on korrektse klassi negatiivne logaritmiline tõenäosus, st –ln(0.1) = 2.302“.
Binaarse näite puhul tehakse sarnane arvutus iga klassi jaoks. Siin on näiteks andmed: 20% 0's ja 80% 1's. Oodatav algne kaotus oleks kuni –0,2ln(0,5) –0,8ln(0,5) = 0,693147. Kui tulemus on suurem kui 1, võib see viidata sellele, et närvivõrgu kaalukaalud ei ole nõuetekohaselt tasakaalustatud või andmed ei ole normaliseeritud.
Kontrollime vahepealseid tulemusi ja ühendusi
Närvivõrgu tõrkeotsimiseks on oluline mõista protsesside dünaamikat võrgu sees ja iga vahekihinähtude rolli, kuna need on omavahel seotud. Siin on tüüpilised vead, millega võite kokku puutuda:
- vale väljendid gradientide uuendamiseks;
- kaalu uuendusi ei rakendata;
- kaduvad või plahvatavad gradientid (exploding gradients).
Kui gradientide väärtused on nullid, tähendab see, et õppimiskiirus optimeerijas on liiga madal või et olete kokku puutunud vale väljendiga gradientide uuendamiseks.
Samuti tuleb jälgida aktivatsioonifunktsioonide, kaalude ja iga kihi uuenduste väärtusi. Näiteks parameetrite (kaalude ja nihkete) uuenduste suurus .
On nähtus, mida nimetatakse "Dying ReLU" või , kui ReLU neuronid annavad pärast suure negatiivse väärtuse (bias) õppimist nulli. Need neuronid ei aktiveeru enam kunagi üheski andmekohas.
Saate kasutada gradientide kontrolli, et tuvastada neid vigu, kaudseist gradientide numbrite põhjal. Kui see on lähedal arvutatud gradientidele, siis tagasikandumine on rakendatud õigesti. Gradientide kontrolli loomiseks tutvuge nende suurepäraste ressurssidega CS231-st. ja , samuti Andrew Nga kohta sellel teemal.
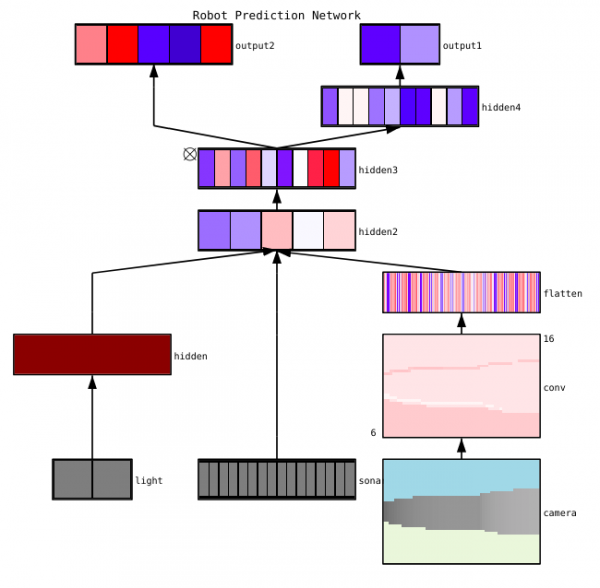
näitab kolme peamist meetodit neurovõrkude visualiseerimiseks:
- Eelvaated — lihtsad meetodid, mis näitavad meile koolitatud mudeli üldstruktuuri. Need hõlmavad väljaandeid või filtrite vormide näitamisest üksikutes neuronite kihtides ja omadustest igas kihis.
- Aktiivsustel põhinevad. Neis dekodeerime üksikute neuronite või neuronigruppide aktiveerimist, et mõista nende funktsioone.
- Gradientidel põhinevad. Need meetodid kipuvad manipuleerima gradientidega, mis tekivad mudeli õppimise ajal (sealhulgas olulisuse kaardid ja klassi aktiveerimise kaardid).
On mitmeid kasulikke tööriistu aktivatsioonide ja üksikute kihtide ühenduste visualiseerimiseks, näiteks ja .
Parameetrite diagnostika
Neurovõrkudel on palju parameetreid, mis omavahel suhtlevad, mis muudab optimeerimise keeruliseks. Tegelikult on see jaotis teadlaste aktiivse uurimise teema, seega tuleks allolevaid soovitusi käsitleda vaid näpunäidete ja alguspunktidena.
Partii suurus (batch size) — see peab olema piisavalt suur, et saada täpseid vigade gradientide hinnanguid, kuid piisavalt väike, et stohhastiline gradientide laskmine (SGD) saaks teie võrku korraldada. Väiksemad partii suurused viivad kiirele konvergentsile, tänu lärmakusele õppimisprotsessis ja hiljem — optimeerimise raskustele. Täpsemalt on see kirjeldatud .
Õppimiskiirus — liiga madal toob kaasa aeglase konvergentsi või riski kinni jääda kohalikesse miinimumidesse. Samal ajal liiga kõrge õppimiskiirus põhjustab optimeerimise hajumist, sest riskite 'hüppata' sügavale, kuid kitsale kadentsifunktsiooni ossale. Proovige kasutada planeeritud kiirus, et seda vähendada neurovõrgu õppimise käigus. CS231n kursuses .
Gradientide kärpimine — gradientide kärpimine tagasiulatuva leviku ajal maksimaalse väärtuse või piiri normaali järgi. See on kasulik probleemide lahendamiseks, mis on seotud lõhkevate gradientidega, millega võite kokku puutuda kolmandas punktis.
Partii normaliseerimine — kasutatakse iga kihi sisendite normaliseerimiseks, mis aitab lahendada sisemise kovariatiivse nihke probleemi. Kui kasutate Dropouti ja Batch Normat koos, .
Stohhastiline gradientide langetamine (SGD) — on mitmeid SGD variante, mis kasutavad impulssi, kohandatud õppimise kiirus, ja Nesterovi meetod. Samas ei ole ühelgi neist selget eelist ei õppimise efektiivsuse ega üldistamise osas ().
Regulaarimine — on ülioluline üldistatava mudeli ehitamisel, kuna see lisab trahvi mudeli keerukuse või äärmuslike väärtuste eest. See on viis mudeli dispersiooni vähendamiseks, ilma et see oluliselt suurendaks selle nihket. Rohkem .
Kuna kõik ise hinnata, peate regulatsiooni välja lülitama ja kontrollima kaotuse gradienti ise.
Tilkus — on veel üks meetod teie võrgu korraldamiseks ülekoormuse vältimiseks. Koolitamise ajal toimub tilkus ainult neuroni aktiivsuse säilitamise kaudu mingi tõenäosusega p (hüperparameeter) või seadistades selle nulliks vastupidiselt. Seetõttu peab võrk kasutama iga koolituspartii jaoks erinevat alamkogumit parameetritest, mis vähendab teatud parameetrite muutusi, mis muutuvad domineerivaks.
Oluline: kui kasutate nii tilku kui ka partii normaliseerimist, olge ettevaatlik nende toimingute järjekorra või isegi koos kasutamise osas. Kõik see on endiselt aktiivses arutelus ja täiendas. Siin on kaks olulist arutelu selle teema kohta ja .
Töökontroll
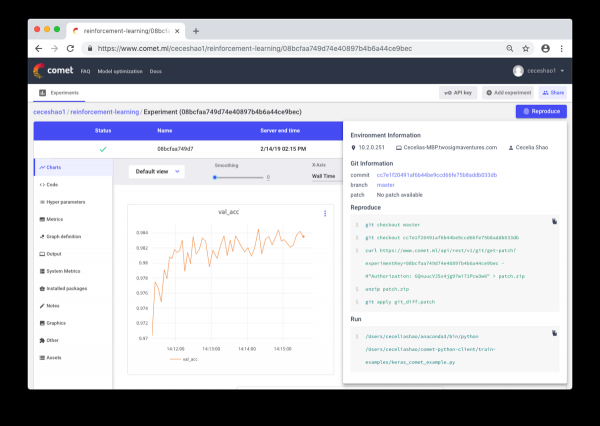
Räägime tööprotsesside ja katsete dokumenteerimisest. Kui mitte midagi ei dokumenteerita, võib ununeda, milline õppimiskiirus või klasside kaalud on kasutusel. Tänu kontrollile saab mugavalt vaadata ja taastada varasemaid katseid. See aitab vähendada korduvate katsete arvu.
Kahjuks võib käsitsi dokumenteerimine suure töömahu korral olla keeruline ülesanne. Siin tulevad appi sellised tööriistad nagu Comet.ml, mis aitavad automaatselt logida andmehulkade, koodimuudatuste, katsete ajalugu ja tootemudeleid, sealhulgas olulisi andmeid teie mudeli kohta (hüperparameetrid, mudeli jõudluse näitajad ja keskkonna andmed).
Neuraalvõrk võib olla väga tundlik väikeste muudatuste suhtes, mis võib viia mudeli jõudluse languseni. Töö jälgimine ja dokumenteerimine on esimene samm, mida tuleks astuda keskkonna standardiseerimiseks ja modelleerimiseks.
Loodan, et see postitus saab olema lähtepunkt, kust alustada oma neuraalvõrgu häälestamist.
Skillbox soovitab:
- Kaks aastat praktilist kursust .
- Veebikursus .
- Praktiline aastakursus .
Allikas: habr.com
