

La société NVIDIA a publié le code source de StyleGAN3, un système d'apprentissage automatique basé sur un réseau antagoniste génératif (GAN), destiné à synthétiser des images réalistes de visages humains. Le code est écrit en Python à l'aide du framework PyTorch et est distribué sous la licence NVIDIA Source Code License, qui impose des restrictions sur une utilisation commerciale.
Des modèles pré-entraînés sont également disponibles au téléchargement, formés sur la collection Flickr-Faces-HQ (FFHQ), comprenant 70 000 images PNG de visages humains de haute qualité (1024×1024). De plus, des modèles construits sur les collections AFHQv2 (photos de visages d'animaux) et Metfaces (images de visages humains provenant de portraits de peinture classique) sont également disponibles. Bien que le développement se concentre sur les visages, le système peut être formé pour générer n'importe quel objet, comme des paysages ou des voitures. Des outils sont en outre fournis pour l'apprentissage autonome du réseau neuronal à partir de ses propres collections d'images. Au moins une ou plusieurs cartes graphiques NVIDIA (recommandé : GPU Tesla V100 ou A100), au minimum 12 Go de RAM, PyTorch 1.9 et l'outil CUDA 11.1+ sont requis pour fonctionner. Un détecteur spécial est en cours de développement pour établir la nature artificielle des visages générés.
Le système permet de synthétiser l'image d'un nouveau visage en interpolant les caractéristiques de plusieurs visages, en combinant leurs traits propres et en adaptant l'image finale en fonction de l'âge, du sexe, de la longueur des cheveux, de la nature du sourire, de la forme du nez, de la couleur de la peau, des lunettes et de l'angle de la photographie requis. Le générateur considère l'image comme une collection de styles, séparant automatiquement les détails caractéristiques (taches de rousseur, cheveux, lunettes) des attributs généraux de haut niveau (posture, sexe, changements liés à l'âge) et permettant de les combiner librement en définissant des propriétés dominantes par des coefficients de poids. En conséquence, des images sont générées, indiscernables des vraies photographies.
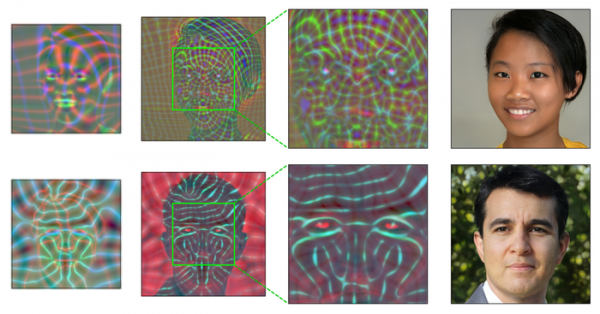
La première version de la technologie StyleGAN a été publiée en 2019, suivie en 2020 d'une édition améliorée, StyleGAN2, qui permet d'améliorer la qualité des images et d'éliminer certains artefacts. Cependant, le système est resté statique, c'est-à-dire qu'il ne permettait pas d'obtenir une animation réaliste ni de mouvement facial. Dans le développement de StyleGAN3, l'objectif principal était d'adapter la technologie pour son utilisation dans l'animation et la vidéo.
Dans StyleGAN3, une architecture de génération d'images retravaillée a été utilisée, débarrassée de l'aliasing, et de nouveaux scénarios d'apprentissage pour le réseau de neurones ont été proposés. De nouveaux outils pour la visualisation interactive (visualizer.py), l'analyse (avg_spectra.py) et la génération vidéo (gen_video.py) ont été inclus. La mise en œuvre a également réduit la consommation de mémoire et accéléré le processus d'apprentissage.
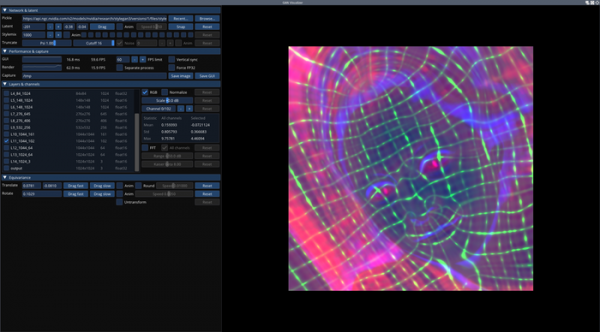
Une caractéristique clé de l'architecture de StyleGAN3 est le passage à l'interprétation de tous les signaux dans le réseau de neurones sous forme de processus continus, ce qui a permis, lors de la formation des détails, de manipuler les positions relatives, sans être attachées aux coordonnées absolues des pixels individuels sur l'image, mais fixes à la surface des objets représentés. Dans StyleGAN et StyleGAN2, l'attachement aux pixels lors de la génération a posé des problèmes lors de la visualisation dynamique ; par exemple, lors du mouvement de l'image, un décalage des petits détails, tels que les rides et les cheveux, a été observé, qui se déplaçaient comme s'ils étaient séparés du reste du visage. Dans StyleGAN3, ces problèmes sont résolus et la technologie est désormais entièrement adaptée à la génération de vidéos.
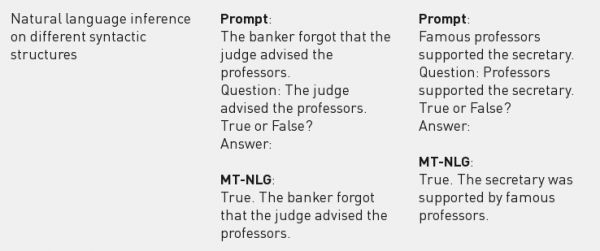
Il convient également de noter l'annonce par NVIDIA et Microsoft de la création du plus grand modèle linguistique, MT-NLG, basé sur un réseau de neurones profond avec une architecture 'transformer'. Le modèle comprend 530 milliards de paramètres, et un cluster de 4480 GPU a été mobilisé pour son apprentissage (560 DGX A100 avec 8 GPU A100 de 80 Go chacun). serveurs Parmi les domaines d'application du modèle, on cite la résolution des tâches de traitement de l'information en langage naturel, telles que la prédiction de la fin d'une phrase inachevée, les réponses aux questions, la compréhension des textes, la formation de déductions en langage naturel et la résolution des ambiguïtés de sens des mots.
Source : opennet.ru
