

La société Intel a publié la version 1.2 de l'outil ControlFlag, permettant d'identifier les erreurs et les anomalies dans les textes sources, en utilisant un système d'apprentissage automatique entraîné sur un grand volume de code existant. Contrairement aux analyseurs statiques traditionnels, ControlFlag ne s'appuie pas sur des règles fixes, où il est difficile de prévoir toutes les variantes possibles, mais part de la statistique de l'utilisation de diverses constructions linguistiques dans un grand nombre de projets existants. Le code de ControlFlag est écrit en C++ et est open source sous la licence MIT.
La nouvelle version se distingue par la mise en œuvre d'un support complet pour l'identification des anomalies et l'apprentissage basé sur des modèles de code types pour le langage C++. Dans les versions précédentes, un tel support était assuré pour les langages C et PHP. Le système est capable de détecter divers types de problèmes dans le code, allant de la détection de fautes de frappe et de mauvais types, à l'identification d'anomalies dans les expressions conditionnelles 'if' et les vérifications manquantes pour les valeurs NULL dans les pointeurs. Le système s'entraîne en construisant un modèle statistique basé sur l'ensemble de codes de projets open source en C, C++ et PHP, publiés sur GitHub et dans d'autres dépôts publics similaires.
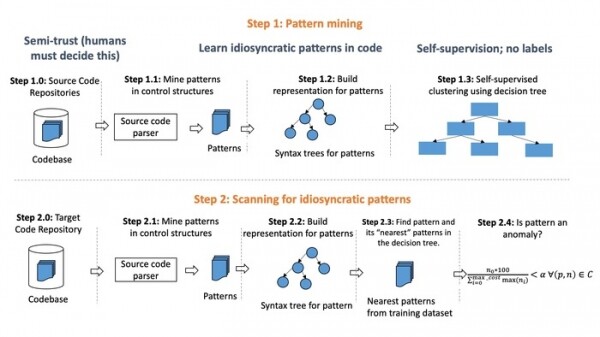
Lors de la phase d'entraînement, le système identifie les modèles types de construction dans le code et construit un arbre syntaxique des liens entre ces modèles, reflétant le flux d'exécution du code dans le programme. En fin de compte, un arbre de décision de référence est formé, combinant l'expérience de développement de tous les textes sources analysés. Pour le code examiné, un processus similaire d'identification des modèles est effectué, qui sont comparés à l'arbre de décision de référence. De grandes divergences avec les branches voisines indiquent la présence d'une anomalie dans le modèle examiné.
Source : opennet.ru
