

Le projet OpenAI, dédié au développement de projets d'intelligence artificielle accessibles au public, a publié des travaux liés au système de reconnaissance vocale Whisper. Il est affirmé que pour la parole en anglais, le système offre des niveaux de fiabilité et de précision de reconnaissance automatique proches de ceux de l'humain. Le code de l'implémentation de référence basée sur le framework PyTorch ainsi qu'un ensemble de modèles déjà entraînés, prêts à l'emploi, sont open source sous licence MIT.
Pour entraîner le modèle, 680 000 heures de données vocales ont été utilisées, collectées à partir de plusieurs ensembles couvrant différentes langues et domaines thématiques. Environ 1/3 des données vocales utilisées pour l'entraînement proviennent de langues autres que l'anglais. Le système proposé traite correctement des situations telles que les accents à la prononciation, la présence de bruit de fond et l'utilisation de jargon technique. En plus de la transcription de la parole en texte, le système peut également traduire la parole d'une langue quelconque vers l'anglais et détecter les moments de parole dans le flux audio.
Les modèles sont formés sous deux représentations : un modèle pour l'anglais et un modèle multilingue, supportant notamment le russe, l'ukrainien et le biélorusse. Chaque représentation est subdivisée en 5 variantes, se distinguant par la taille et le nombre de paramètres pris en compte dans le modèle. Plus la taille est grande, plus la précision et la qualité de la reconnaissance sont élevées, mais les exigences en matière de mémoire vidéo GPU augmentent et les performances diminuent. Par exemple, la variante minimale comprend 39 millions de paramètres et nécessite 1 Go de mémoire vidéo, tandis que la variante maximale comprend 1550 millions de paramètres et nécessite 10 Go de mémoire vidéo. La variante minimale est 32 fois plus rapide que la variante maximale.
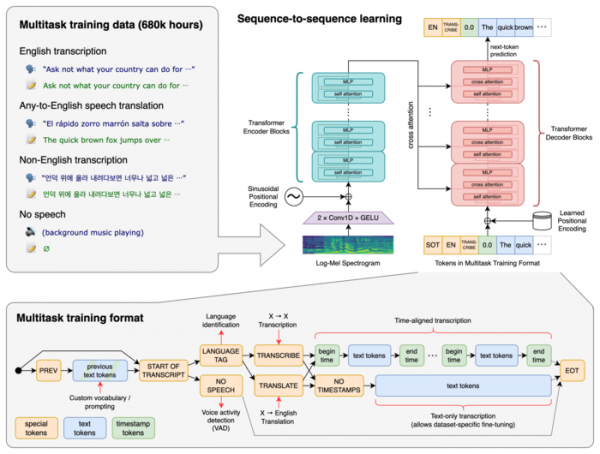
Le système utilise une architecture de réseau de neurones « Transformer », comprenant un encodeur et un décodeur interconnectés. Le son est divisé en extraits de 30 secondes, qui sont transformés en log-Mel-spectrogramme et transmis à l'encodeur. Le résultat du travail de l'encodeur est envoyé au décodeur, qui prédit la représentation textuelle, mélangée avec des jetons spéciaux, permettant de résoudre, au sein d'un même modèle, des tâches telles que la détection de la langue, la prise en compte de la chronologie de la prononciation des phrases, la transcription de la parole dans différentes langues et la traduction en anglais.
Source : opennet.ru
