

La version 9.2.0 du dispositif de stockage réparti répliqué DRBD a été publiée, permettant de réaliser un similitude de matrice RAID-1, formée à partir de plusieurs disques de différentes machines connectées en réseau (miroir sur le réseau). Le système est conçu sous la forme d'un module pour le noyau Linux et est distribué sous la licence GPLv2. La branche drbd 9.2.0 peut être utilisée pour un remplacement transparent de drbd 9.x.x et est totalement compatible au niveau du protocole, des fichiers de configuration et des utilitaires.
DRBD permet de regrouper les disques des nœuds d'un cluster en un stockage tolérant aux pannes unique. Pour les applications et le système, ce stockage apparaît comme un dispositif de bloc identique pour tous les systèmes. Lors de l'utilisation de DRBD, toutes les opérations sur le disque local sont envoyées à d'autres nœuds et synchronisées avec les disques des autres machines. En cas de défaillance d'un nœud, le stockage continuera automatiquement à fonctionner grâce aux nœuds restants. Lors de la reprise de la disponibilité du nœud défaillant, son état sera automatiquement mis à jour.
Le cluster qui forme le stockage peut comprendre plusieurs dizaines de nœuds, situés à la fois dans le réseau local et géographiquement répartis dans différentes centres de données. La synchronisation dans de tels stockages décentralisés s'effectue à l'aide de technologies de réseau maillé (les données circulent en chaîne d'un nœud à l'autre). La réplication des nœuds peut se faire en mode synchronisé ou asynchrone. Par exemple, les nœuds localement situés peuvent utiliser la réplication synchronisée, alors que pour les sites distants, une réplication asynchrone avec compression et chiffrement supplémentaires du trafic peut être appliquée.
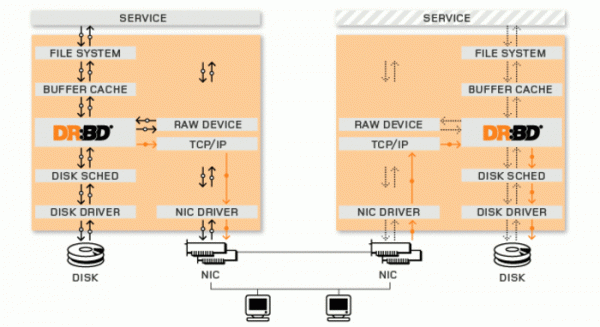
Dans cette nouvelle version :
- Les latences pour les requêtes de mise à jour miroir ont été réduites. Une meilleure intégration avec la pile réseau a permis de diminuer le nombre de changements de contexte du planificateur.
- La concurrence entre les entrées/sorties des applications et les entrées/sorties de resynchronisation a été réduite grâce à l'optimisation des verrouillages lors de la resynchronisation des extents.
- Les performances de resynchronisation des backends utilisant l'allocation dynamique d'espace de stockage («thin provisioning») ont été considérablement augmentées. Les performances ont été améliorées grâce à la combinaison des opérations trim/discard, qui prennent beaucoup plus de temps que les opérations d'écriture habituelles.
- La prise en charge des espaces de noms réseau (network namespaces) a été ajoutée, permettant l'intégration avec Kubernetes pour acheminer le trafic réseau des réplications via un réseau séparé lié aux conteneurs, plutôt que par le réseau d'hôte.
- Un module transport_rdma a été ajouté pour être utilisé comme transport Infiniband/RoCE au lieu de TCP/IP sur Ethernet. L'utilisation de ce nouveau transport permet de réduire les latences, de diminuer la charge sur le CPU et d'assurer l'acquisition de données sans opérations de copie superflues (zero-copy).
Source : opennet.ru
