

La société Google a annoncé l'ouverture du code du projet Magika, destiné à déterminer le type de contenu en analysant les données présentes dans le fichier. Magika peut identifier avec précision les langages de programmation utilisés dans le contenu, les méthodes de compression, les packages d'installation, le code exécutable, les types de balisage, les formats audio, vidéo, de documents et d'images. Les outils associés au projet et le modèle d'apprentissage automatique prêt à l'emploi ont été publiés sous la licence Apache 2.0.
Contrairement à d'autres projets qui déterminent le type MIME par le contenu, Magika se distingue par l'utilisation de méthodes d'apprentissage automatique, une haute performance et une précision remarquable dans la détection. Le modèle a été formé en utilisant le framework Keras sur 25 millions d'exemples de fichiers et prend en charge la reconnaissance de 116 types de données avec une précision d'au moins 99%. Le modèle est empaqueté au format ONNX et a une taille d'à peine 1 Mo. L'utilisation de méthodes d'apprentissage automatique profond a permis d'améliorer la précision de détection de 50% par rapport au système précédemment utilisé par Google basé sur des règles définies manuellement.
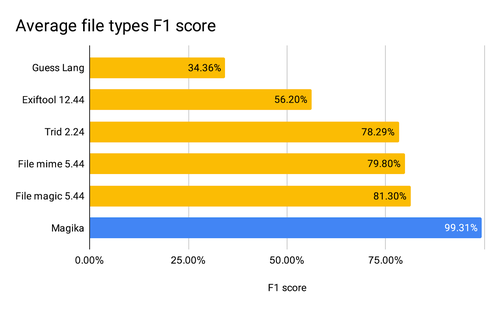
Dans Google, le système est utilisé pour classifier les fichiers dans les services Gmail, Drive, Code Insight et Safe Browsing lors des vérifications de sécurité et de conformité aux règles des services. Des travaux sont en cours pour intégrer Magika dans la plateforme VirusTotal en tant que première étape de filtrage des fichiers avant d'exécuter des analyseurs spécifiques. La configuration déployée dans l'infrastructure de Google permet de scanner plusieurs millions de fichiers par seconde et plusieurs centaines de milliards de fichiers par semaine. Après le chargement du modèle, le temps de formation de la sortie est de 5 à 6 ms lors des tests sur un cœur CPU. Le temps de détection dépend très peu de la taille du fichier.
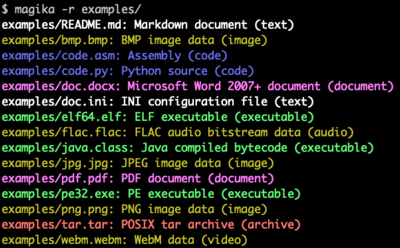
Pour utiliser Magika dans leurs projets, des outils en ligne de commande, un package pour Python et une bibliothèque JavaScript capable de fonctionner dans le navigateur ou dans des projets basés sur Node.js ont été préparés. L'interface en ligne de commande et l'API prennent en charge l'exécution d'opérations en mode batch, c'est-à-dire qu'elles permettent de vérifier plusieurs fichiers en une seule requête. Il existe un mode de scan récursif de tout le contenu d'un répertoire et trois modes de prédiction pour ajuster la robustesse aux erreurs (forte confiance, confiance moyenne et meilleure supposition).
Source : opennet.ru
