

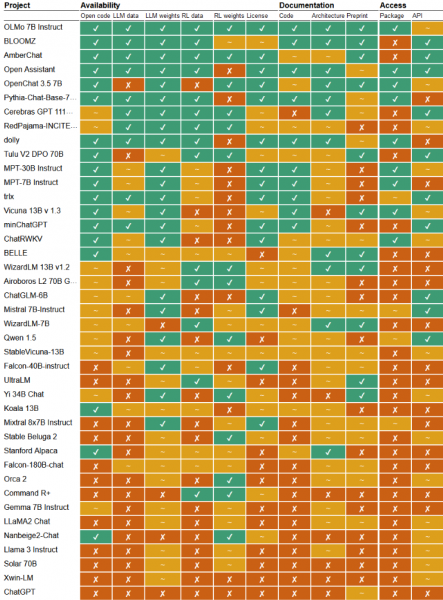
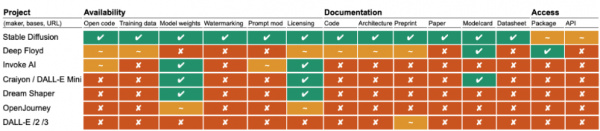
Des chercheurs de l'Université de Nimègue (Pays-Bas) ont établi un classement de l'ouverture de 40 grands modèles linguistiques et de 7 modèles de génération d'images à partir de descriptions textuelles, que les fabricants présentent comme ouverts. Étant donné que les critères d'ouverture des modèles d'apprentissage automatique sont encore en cours de formation, la situation actuelle est telle que des modèles dotés de licences limitant le champ d'application (par exemple, de nombreux modèles interdisent l'utilisation dans des projets commerciaux) sont diffusés sous le couvert d'être ouverts. De plus, les fabricants ne fournissent souvent pas d'accès aux données utilisées pour l'apprentissage, ne révèlent pas les détails de leur mise en œuvre ou n'ouvrent pas complètement le code associé.
La plupart des modèles présentés comme « ouverts » doivent en réalité être considérés comme des « coefficients ouverts » ou plus précisément « coefficients accessibles », car ils sont diffusés sous des licences restrictives interdisant leur utilisation dans des produits commerciaux. Les chercheurs externes peuvent expérimenter avec ces modèles, mais n'ont pas la possibilité d'adapter le modèle à leurs besoins ou d'inspecter sa mise en œuvre. Plus de la moitié des modèles ne fournissent pas de détails sur les données utilisées pour l'apprentissage et ne publient pas d'informations sur leur structure interne et leur architecture.
Les modèles les plus ouverts sont reconnus comme étant BloomZ, AmberChat, OLMo, Open Assistant et Stable Diffusion, qui sont publiés sous des licences ouvertes avec les données sources, le code et l'implémentation de l'API. Les modèles de Google (Gemma 7B), Microsoft (Orca 2) et Meta (Llama 3), présentés par les fabricants comme ouverts, se sont retrouvés en bas du classement, car ils ne fournissent pas d'accès aux données sources, ne révèlent pas de détails techniques sur leur mise en œuvre, et diffusent les coefficients du modèle sous des licences limitant le champ d'application. Le modèle populaire Mistral 7B se situe à peu près au milieu du classement, car il est proposé sous une licence ouverte, mais est seulement partiellement documenté, ne divulgue pas les données utilisées pour l'apprentissage et n'a pas de code associé complètement ouvert.
Les chercheurs ont proposé 14 critères d'ouverture pour les modèles d'IA, englobant les conditions de diffusion du code, des données d'entraînement, des poids, des variantes de données et des coefficients optimisés par apprentissage par renforcement (RL), ainsi que la disponibilité de packages prêts à l'emploi, d'API, de documentation et d'une description détaillée de l'implémentation.
Conformément au projet de définition d'IA ouverte proposé par l'organisation OSI (Open Source Initiative), les critères principaux de l'ouverture d'un système d'IA incluent la possibilité de l'utiliser à toutes fins sans avoir à obtenir une autorisation séparée, d'étudier le fonctionnement du système et d'inspecter ses composants, d'apporter des modifications à toutes fins, et de transmettre à d'autres une version originale ou une version modifiée après modification.
Pour permettre des modifications, un système d'IA doit inclure :
- Des informations détaillées sur les données utilisées pour l'entraînement et la méthodologie d'entraînement. Les informations doivent suffire à ce qu'un développeur professionnel puisse recréer un système d'IA équivalent, en utilisant les mêmes ou des données similaires pour l'entraînement.
- La disponibilité du code source permettant tant de lancer le système d'IA que de réaliser le processus de son entraînement (dans le tableau mentionné ci-dessus, dans la colonne «code», de nombreux modèles indiquent «~», ce qui implique une disponibilité partielle du code, où le code pour exécuter le modèle est accessible, mais le code pour l'entraînement ou la création du modèle est absent). Le code doit également couvrir des aspects tels que le prétraitement, la vérification des données et la tokenisation. De plus, une description détaillée de l'architecture du modèle doit être fournie.
- Les paramètres du modèle (poids) impliquant la disponibilité d'une tranche d'état prête à l'emploi après l'entraînement ou d'une version finale optimisée du modèle.
Source : opennet.ru
