

Il est amusant de constater que l'histoire des versions des modèles open source conçus pour transformer des textes en images, développés et entraînés par la société Stability AI, ressemble à une série d'ascensions et de chutes des versions successives des systèmes d'exploitation Microsoft. Après le succès légendaire de XP, on se souvient que Vista a été problématique ; puis la magnifique « sept » est arrivée — suivie par la décevante Windows 8. Avec Stable Diffusion, la version initiale imparfaite, mais progressivement améliorée par des passionnés, 1.5, a été suivie par la manifestement ratée SD 2.0 — ratée, en fait, parce qu'elle intégrait un encodeur OpenCLIP atypique pour ce genre de modèles, de . Lors de cette sélection, non seulement des références visuelles inappropriées (NSFW) ont été écartées, mais aussi des œuvres d'art et des illustrations d'artistes populaires comme le célèbre Greg Rutkowski. C'est justement ce dernier point qui a profondément agacé les passionnés : alors que pour SD 1.5, même dans sa version d'origine, sans utiliser de points de contrôle spécialement affinés, de simples prompts avec des styles — « paysage médiéval épique, dans le style de Greg Rutkowski » — produisaient un résultat impressionnant, SD 2.0 a cessé de « reconnaître » les noms des illustrateurs les plus connus, dont les droits d'auteur sur les œuvres créées sont toujours d'actualité et qui n'ont pas daigné fournir ces œuvres pour l'entraînement de l'IA. Il a donc fallu utiliser plus de mots pour décrire le souhaité, et la modèle avait des difficultés avec des prompts trop longs.
On s'est assis — on s'est levé, on s'est assis — on s'est levé
La combinaison d'un encodeur modifié (convertissant les prompts textuels en tokens numériques avec lesquels le modèle travaille ensuite) et l'impossibilité d'appliquer des styles nommés a tout simplement dépouillé les passionnés de la motivation de peaufiner la "deux" par leurs propres moyens. En effet, il fallait simultanément comprendre comment adapter la technique de création des prompts à ce nouvel encodeur et rééduquer le modèle à reconnaître des formes et des thèmes que les créateurs ne lui avaient pas présentés lors de l'entraînement initial — et la qualité des images générées par la "deux" ne garantissait pas vraiment de distinction par rapport à la "une et demie". Oui, il y a eu un saut qualitatif de la taille standard de 512×512 pixels pour SD 1.5 à 768×768, mais à ce moment-là, la communauté utilisait déjà des upscalers, des outpainters et d'autres outils pour augmenter la taille des images finales, de sorte que SD 2.0 est passée pratiquement inaperçue. SDXL (développé par OpenAI et utilisé, entre autres, par le projet DALL-E) — son code est également ouvert, mais la base de données sur laquelle il a été formé , est propriétaire. De plus, la taille standard du canevas a été augmentée chez "Oversize" à 1024×1024, avec l'ajout de nombreuses améliorations supplémentaires, ce qui a donc incité les passionnés à travailler avec enthousiasme à son perfectionnement. Et à l'heure actuelle, SDXL (y compris ses dérivés, récemment moins exigeants en termes de "matériel" comme et ) peut certainement être considéré comme le générateur d'images IA open source le plus populaire. Cependant, les fervents partisans de SD 1.5 contestent cela, en soulignant que des outils aussi cruciaux que ControlNet ne sont toujours pas .
Et donc, depuis le 12 juin 2024, à partir du moment où le code du modèle a été rendu public, permettant des générations locales, il devrait être temps pour la version "ouverte" de SD 3 — pour être plus précis, (SD3M ou SD3 2B) avec 2 milliards de paramètres de travail. Pour mémoire, ce chiffre correspond au nombre total de poids sur les entrées de tous les perceptrons du modèle. Plus tôt, en avril, Stability AI a perfectionné et proposé pour une utilisation commerciale un modèle de 8 millions (en nombre de paramètres) , également connue sous le nom de SD3 8B. Avec SDXL 1.0, rappelons-le, — , cependant SD3M, selon les développeurs, est . Il était sous-entendu qu'avec des besoins en mémoire vidéo inférieurs à ceux de « l'Oversize », même en réponse à des prompts simples, il devrait produire des images « avec un nouveau niveau de photoréalisme ». Parmi les avantages de la « triade », on a également mentionné « une qualité typographique sans précédent du texte généré dans les images », « une compréhension approfondie des prompts grâce à la combinaison des efforts de trois encodeurs » et « une préparation à un affinement efficace même sur des ensembles de données limités ».
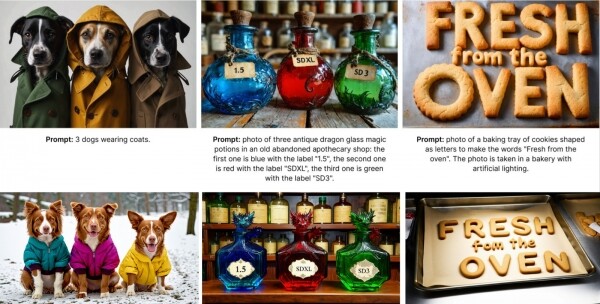
Il a été supposé, de manière évidente, que la communauté des passionnés, ayant entre les mains ce nouveau jouet tant attendu, s'appliquerait à l'améliorer avec la même ardeur que la « Demi-Ton » et l'« Oversize » à l'époque. Cependant, dès le début, tout ne s'est pas passé comme prévu : SD3M a réussi à décevoir profondément Les créations précédentes de Stable Diffusion avec code ouvert (plus précisément, avec des valeurs de poids de réseau neuronal disponibles pour téléchargement gratuit et exécution locale), telles que SDXL, étaient accompagnées d'un des éléments typiques des modèles génératifs
CreativeML Open RAIL++-M License avec des caractéristiques telles que « licence de copyright illimitée, mondiale, non exclusive, gratuite, sans redevance, irrévocable, visant la reproduction, la préparation, la démonstration publique, l'exécution publique, la sous-licence et la distribution de matériaux supplémentaires à la fois de la modèle lui-même et de ses dérivés ». Le « trio » prévoit néanmoins deux types de licences : — avec des formulations très relaxantes comme « Stability AI vous accorde une licence non exclusive, mondiale, non transférable, sans sous-licence, révocable, gratuite et limitée sur la propriété intellectuelle » — et .
L'herbe ne mène pas à quelque chose de bon
Peu de temps après, la communauté est arrivée à la conclusion que . Et a en substance décrété un boycott de l'entreprise de développement, ne souhaitant pas perdre de temps et d'énergie à retravailler un modèle manifestement brut et mal ficelé — en ayant conscience que Stability AI peut à tout moment, pour le moindre caprice de ses médiamanagers, révoquer la licence précédemment accordée à un certain enthousiaste effectuant cette retraining. Le contrat de licence a été rédigé de telle sorte que ceux qui l'étudient sans formation juridique ont l'impression qu'à la suite de la révocation de la permission d'utilisation commerciale de SD3M, l'ancien titulaire sera obligé de supprimer toutes les œuvres dérivées qu'il a créées à partir de la propriété intellectuelle qui lui a été licenciée, y compris aussi bien les modèles retravaillés (LoRA, inversions textuelles, checkpoints complets) que leurs dérivés (citation : « Upon termination of this Agreement, you shall delete and cease use of any Software Products or Derivative Works ») — c'est-à-dire les fruits du travail d'autres personnes qui ont utilisé ces modèles dérivés comme point de départ pour leur propre travail ; et ce, sans aucune compensation, réalisé par pur enthousiasme.
Peu après que le flot d'indignation à ce sujet ait atteint des sommets stratosphériques, des rapports ont commencé à arriver de professionnels du droit, Et ce que l'avis d'interdiction d'utilisation ultérieure devrait en réalité concerner uniquement certains produits auxiliaires à code fermé que Stability AI remettra à l'utilisateur commercial (par exemple, pour accélérer et optimiser la pré-formation de SD3M) — mais la société n'a pas encore fourni d'éclaircissements finaux à ce sujet. Et le simple fait d'un silence si pesant depuis maintenant trois semaines (au moment de la rédaction de cet article) depuis la mise à disposition publique de la «troisième version» nuit beaucoup plus à la réputation du développeur que n'importe quelle herbe — aux filles générées par son œuvre.
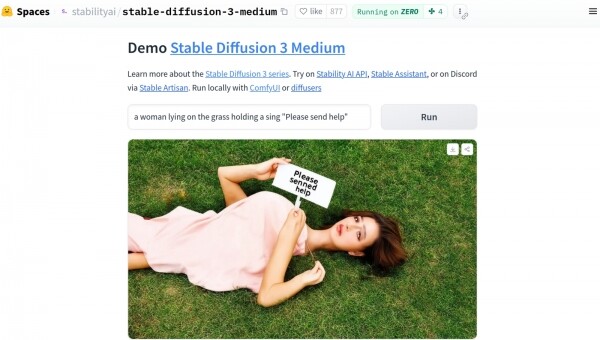
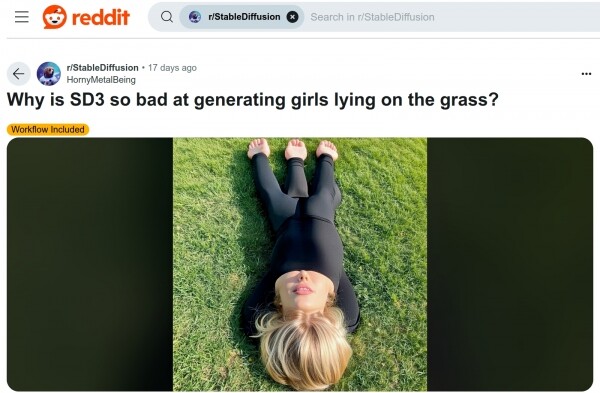
Quant à la fameuse herbe, qui est devenue littéralement un mème en quelques heures , puis pratiquement sur tous les sites spécialisés du réseau, il s'avère que la présence dans l'invite d'une phrase comme «une fille allongée dans l'herbe» entraîne l'apparition non seulement de hallucinations, mais aussi de créations cauchemardesques de la fantaisie malade — au sens médical du terme — des artistes et cinéastes spécialisés dans le body horror (nous vous conjurons, si votre raison et votre vie vous sont chères, restez loin de cela et même n'essayez pas de taper cette phrase dans la recherche d'images avec le filtre de sécurité désactivé). En revanche, les images de personnes debout — et dans une moindre mesure assises — réussissent à «la troisième version» avec un solide quatre plus, tandis que les portraits sont parfois d'une perfection sans pareille ; du moins, pas pires que ceux du modèle de base SDXL 1.0, — le hic ici est plutôt un tabou interne sur la position horizontale du corps humain.
D'après le commentaire d'Emad Mostaque, le fondateur et ancien (jusqu'en mars 2024) directeur de Stability AI, qui a quitté la société pour , la violence brutale contre SD3M juste avant l'ouverture de ses poids pour une utilisation non commerciale limitée (rappelez-vous, l'API du modèle plus grand SD3 8B pour la génération en ligne , mais ses poids demeurent cachés) était le résultat du désir de la direction actuelle pour la sécurité — , formulées dès mars de cette année comme . Dans le cadre de cette politique utilisant le modèle génératif SD3M, il est interdit aux utilisateurs de « commettre, promouvoir, faciliter, encourager, planifier, inciter ou contribuer à des actes de violence, terrorisme ou à la création de contenu haineux qui discrimine ou menace un groupe de personnes protégé (que ce soit en raison du sexe, de l'origine ethnique, de l'identité ou de l'orientation sexuelle, de la religion, etc.) », donc pas d'images de pandas se battant nus contre des dragons enragés ! Uniquement des chats avec des chapeaux amusants, des chiens en adorables vestes, des bouteilles avec un contenu inconnu et des biscuits tout juste sortis du four !
Techniquement parlant, le fait d'éviter les contenus inappropriés pourrait signifier que des images de personnes allongées et d'autres images pouvant être interprétées de manière indécente ont simplement été exclues de l'ensemble de données d'entraînement - et donc maintenant, le « trois » ne « comprend » tout simplement pas le sens du mot « être allongé ». Ou bien la nouvelle architecture SD3 a permis d'identifier avec suffisamment de confiance les poids sur les perceptrons qui s'activent lors de la génération d'images « non sécurisées », et ces poids ont été sélectivement annulés juste avant la sortie, ce qui a provoqué un effet secondaire de « hallucinage forcé ». Probablement, : le codeur traduit correctement le texte en tokens, mais dans l'espace latent « sécurisé », ces tokens ne désignent déjà rien de concret - et par conséquent, les pixels résultants sont répartis sur l'image un peu n'importe comment.
Étant donné la disponibilité de l'API d'un modèle SD3 8B complet mais fermé depuis plusieurs mois et les assurances des responsables médias de Stability AI que le modèle « compactifié » 2B , les passionnés de l'IA pour le dessin ont accueilli la mise à disposition des poids de SD3M le 12 juin avec un enthousiasme débordant : . Actuellement, il est toujours possible de l'obtenir, bien que de manière légèrement plus détournée que ce à quoi on est habitué avec les points de contrôle SDXL et SD 1.5. En effet, le chemin habituel consiste à se rendre sur le site Civitai, d'où la plupart des modèles sont téléchargés sans inscription, mais depuis le 17 juin et jusqu'au moment de la rédaction de cet article, la page consacrée à la « troïka » de ce site . Et la raison est unique : la licence commerciale pour SD3M est rédigée dans un langage tellement vague que même les avocats de Civitai ont pris un moment pour l'examiner de plus près. En effet, si un certain enthousiaste entraîne sur son PC un LoRA pour la « troïka » et le met en ligne sur Civitai, et que Stability AI décide soudain que le résultat est inacceptable et retire la licence du coupable, que doit faire alors le site hébergeur ? Il ne se contente pas d'héberger des points de contrôle, des cycles auxiliaires et des modèles, mais offre également aux visiteurs la possibilité de générer des images dans le cloud et d'entraîner les mêmes LoRA, inversions textuelles, etc. En résumé, tant que la justice fait son chemin, il n'est possible de récupérer les fichiers du modèle lui-même et les trois convertisseurs de texte en tokens qui l'accompagnent que .
Commençons
Cependant, il y a un détail : pour accéder aux liens de téléchargement, il faut s'inscrire sur le site, puis confirmer l'acceptation de l'accord de licence mentionné ci-dessus, mais cette procédure est gratuite et tout à fait accessible depuis la Russie. Quatre modèles (models) et quatre convertisseurs de texte en tokens (encoders) sont proposés, ainsi que trois cycles de référence pour être exécutés dans l'environnement ComfyUI, :
modèles :
- sd3_medium.safetensors
- sd3_medium_incl_clips.safetensors
- sd3_medium_incl_clips_t5xxlfp8.safetensors
- sd3_medium_incl_clips_t5xxlfp16.safetensors
encodeurs :
- clip_g.safetensors
- clip_l.safetensors
- t5xxl_fp8_e4m3fn.safetensors
- t5xxl_fp16.safetensors
cycles :
- sd3_medium_example_workflow_basic.json
- sd3_medium_example_workflow_multi_prompt.json
- sd3_medium_example_workflow_upscaling.json
Dans cet atelier, nous nous limiterons au modèle de base sd3_medium.safetensors (4,2 Go), aux trois encodeurs — clip_g.safetensors (1,3 Go), clip_l.safetensors (234 Mo) et t5xxl_fp8_e4m3fn.safetensors (4,7 Go), ainsi qu'au cycle sd3_medium_example_workflow_multi_prompt.json. Sachez que notre machine de test est équipée, rappelons-le, d'une carte graphique GeForce GTX 1070 avec 8 Go de VRAM, et qu'il ne sera pas possible d'intégrer des modèles plus volumineux avec tous les encodeurs intégrés à la fois. Pour les checkpoints basés sur SD 1.5 et SDXL, les encodeurs sont par défaut intégrés dans le fichier principal, mais dans ce cas, il s'agit de trois encodeurs au total, ce qui fait plus de 6 Go, et avec le modèle lui-même, on dépasse déjà les 10 Go ; si l'on opte pour la version 16 bits de l'encodeur T5XXL, une carte graphique encore plus performante sera nécessaire. En revanche, si les encodeurs de texte en tokens sont d'abord chargés dans la mémoire vidéo, puis que le modèle traitant ces tokens est exécuté, un adaptateur graphique de 6 Go sera parfaitement suffisant. De ce point de vue, la « triade » modulaire gagne indéniablement par rapport au typique checkpoint SDXL de 5 à 7 Go.
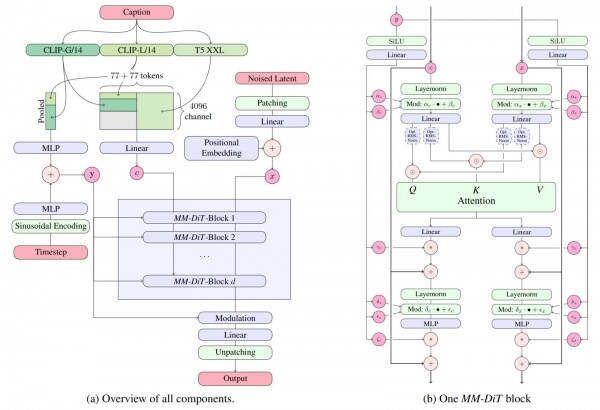
SD3M est un modèle basé sur des transformateurs de diffusion multimodale () — et se distingue ainsi fondamentalement des développements antérieurs de Stability AI (et d'autres), qui reposent sur L'atelier n'est pas un endroit pour approfondir la différence entre ces approches de génération d'images par IA ; disons simplement que , sa capacité à traiter un plus grand nombre de tokens (ce qui, à son tour, permet à l'opérateur de formuler des invitations textuelles assez détaillées, et au système de les suivre de manière assez précise), ainsi qu'une meilleure qualité des images produites. La SD3 complète 8B est capable de générer des images sur une toile de 4 Mpx (2048×2048 pixels), et dans des domaines tels que la reproduction de texte dans l'image, la précision de la correspondance entre l'image obtenue et l'invitation textuelle, ainsi que l'esthétique visuelle générale. La transformation de texte en vecteurs de tokens est ici réalisée par trois encodeurs ( et un T5-XXL — le "T5", soit dit en passant, vient de ) — et, en gros, ils ne sont pas tenus de fonctionner avec le même prompt.
Mais assez de préambules : attaquons ce à quoi est dédiée la « Mастерская » — la génération d'images basée sur le modèle SD3M. Pour cela, nous utiliserons, comme déjà mentionné, l'environnement de travail ComfyUI, que l'on peut télécharger . Soulignons que cette variante est uniquement pour une exécution sur des cartes graphiques NVIDIA ou directement sur un CPU AMD ou Intel (ce qui est, bien sûr, beaucoup plus lent) : aux propriétaires de cartes graphiques AMD rocm et pytorch, qui peuvent être installés via le gestionnaire de téléchargement pip.
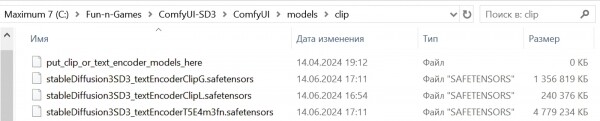
Une fois l'environnement de travail installé, il faudra placer les fichiers .safetensors téléchargés auparavant : les modèles dans le répertoire ComfyUImodelscheckpoints et les tokenizers de texte dans ComfyUImodelsclip. Et — on peut commencer !
Il est temps d'accélérer
Il convient de mentionner qu'AUTOMATIC1111, bien connu des lecteurs précédents des « Мастерских » sur le thème de la peinture IA, a également , cependant, dans ComfyUI, le support du nouveau modèle reste pour l'instant le plus complet. Ce n'est pas surprenant — car jusqu'à tout récemment, l'auteur du « monstre de pâtes », connu dans la communauté des passionnés sous le nom de ComfyAnonimous, ou simplement Comfy, , où il a travaillé, entre autres, sur un environnement de travail interne utilisé par les développeurs eux-mêmes. Comme nous le verrons un peu plus tard, la toute dernière version de ComfyUI témoigne effectivement d'une certaine connaissance de son auteur concernant la manière dont ce modèle controversé fonctionne — des connaissances que les créateurs d'autres environnements de travail pour l'exécution locale de Stable Diffusion 3 Medium ne peuvent pas revendiquer pour des raisons évidentes.
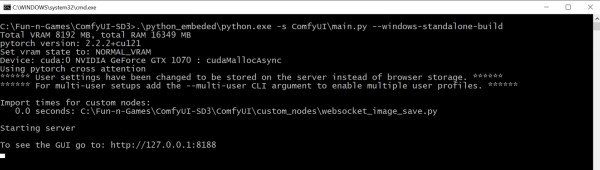
Installer ComfyUI dans une version portable sous Windows est un jeu d'enfant : après avoir téléchargé l'archive ZIP correspondante Il suffit de le décompresser dans n'importe quel répertoire pratique ; de préférence, bien sûr, sur une partition logique basée sur un SSD, et non sur un HDD, car les échanges entre le disque et la mémoire, compte tenu des futurs cycles de chargement-déchargement des modèles, même pour générer une seule image (il faudra d'abord placer dans la VRAM les convertisseurs de texte en tokens, puis nettoyer la mémoire vidéo et charger le SD3M) sont prévus d'autant plus importants que le GPU de cet ordinateur dispose de moins de mémoire vidéo. D'ailleurs, l'installation portable est également vantée pour sa complète indépendance : rien, à part l'espace libre sur le disque logique, ne vous empêche de déployer localement autant de copies de ComfyUI que vous le souhaitez pour expérimenter avec différentes extensions, sans craindre d'endommager un système déjà bien réglé et parfaitement fonctionnel.
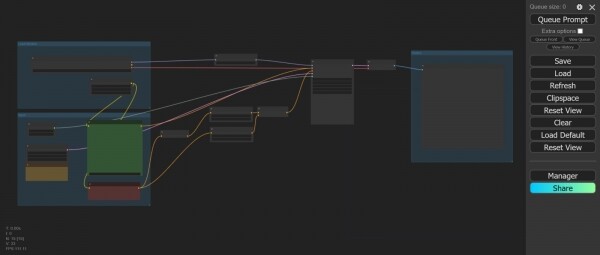
Assurez-vous que le fichier du modèle principal SD3M sans encodeurs de texte intégrés (fichier stableDiffusion3SD3_sd3Medium.safetensors, 4,2 Go) est placé dans le sous-répertoire checkpoints (dans le cadre de notre installation de test, le chemin complet est C:Fun-n-GamesComfyUI-SD3ComfyUImodelscheckpoints), et que les trois modèles d'encodeurs (fichiers stableDiffusion3SD3_textEncoderClipG.safetensors, stableDiffusion3SD3_textEncoderClipL.safetensors et stableDiffusion3SD3_textEncoderT5E4m3fn.safetensors ; 1,3 Go, 234 Mo et 4,7 Go respectivement) sont également dans le sous-répertoire clip (C:Fun-n-GamesComfyUI-SD3ComfyUImodelsclip), vous pouvez lancer l'environnement de travail en double-cliquant sur le fichier run_nvidia_gpu.bat dans le dossier racine (dans notre cas, C:Fun-n-GamesComfyUI-SD3). Après le démarrage du serveur, une nouvelle onglet s'ouvrira automatiquement dans le navigateur par défaut (comme le prévoient les paramètres du fichier BAT) dans laquelle l'interface web sera disponible à l'adresse 127.0.0.1/8188. (bien que seulement dans un premier temps) « monstre des pâtes ».
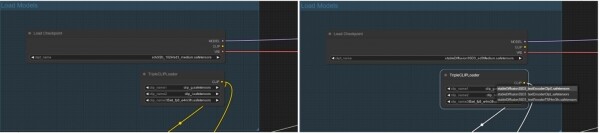
En principe, si vous disposez d'une carte graphique NVIDIA plus moderne (de la génération RTX, et non GTX, même avec seulement 6 Go de VRAM), vous pouvez immédiatement charger dans l'environnement de travail le workflow de référence créé par ComfyAnonimous, mentionné précédemment — le fichier comfy_example_workflows_sd3_medium_example_workflow_multi_prompt.json avec plusieurs fenêtres pour la saisie de prompts, une pour chacun des trois encodeurs, et commencer à travailler. Cependant, il faudra d'abord adapter les quatre noms de fichiers modèles (dans les nœuds de chargement) pour qu'ils correspondent à ceux disponibles. L'auteur du workflow de référence a visiblement travaillé sur son poste (chez Stability AI, comme mentionné précédemment) avec des fichiers locaux dont les noms étaient légèrement différents, donc si vous appuyez sur le bouton « Queue Prompt » dans l'interface spartiate de ComfyUI juste après avoir chargé le workflow, l'environnement de travail affichera un message d'erreur.
Trois champs pour la génération IA
Cependant, cela se corrige relativement facilement : ce qui est beaucoup plus frustrant, c'est que notre vieille GTX 1070 traite SD3M d'une manière incroyablement lente — la génération d'images prend 27 à 30 secondes par itération, et étant donné que le paramètre « Steps » dans le workflow de référence est réglé sur « 28 », le temps est injustement long. Nous allons donc procéder à une petite optimisation — en utilisant le module Python venv (), qui est censé, entre autres, accélérer le travail des modèles IA génératifs. Il n'est pas inclus dans le package de la version portable de ComfyUI, , qui se résument finalement au déploiement d'un environnement Python complet sur votre PC local — et à l'activation du module requis depuis cet environnement.
Nous espérons que nos lecteurs suivant nos « Ateliers » disposent déjà d'une installation opérationnelle d'AUTOMATIC1111 sur leurs machines. Dans ce cas, tout est beaucoup plus simple : le module venv y est déjà déployé, et tout ce que vous devez faire pour l'activer lors du lancement de l'environnement de travail ComfyUI, c'est . Pour commencer, il est nécessaire de terminer le travail du serveur en sélectionnant sa fenêtre et en appuyant sur « Ctrl » + « C », puis en saisissant « y » pour confirmer ; après cela, copiez le fichier BAT run_nvidia_gpu.bat dans un nouveau fichier, que vous appellerez, par exemple, run_with_venv.bat. Le fichier de démarrage d'origine est très concis — il appelle simplement une copie portable de Python avec le paramètre —windows-standalone-build :
.python_embededpython.exe -s ComfyUImain.py —windows-standalone-build
pause
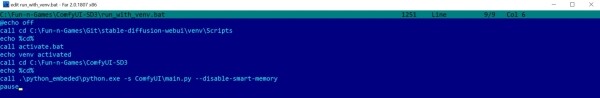
Ce paramètre en soi n'est pas très clair — il implique certaines optimisations qui, très probablement, sont conçues pour les cartes graphiques NVIDIA plus récentes et peuvent donc rendre la vie difficile à ceux qui continuent à utiliser fièrement leurs GTX bien établies. Pour cette raison, nous retirerons —windows-standalone-build de la ligne de commande, et cela se traduira également par le retrait d'une autre optimisation à la mode — le « gestionnaire de mémoire intelligent » activé par défaut, smart memory, qui , sans les décharger. Cela accélère effectivement le rendu des images IA, mais cela transforme notre ordinateur moralement obsolète en un système mono-tâche — il devient impossible de naviguer sur le web, de jouer, ou même de travailler sur des documents et des e-mails sur le PC en même temps que l'environnement de travail est actif. Ainsi, pour ceux qui ne disposent pas d'un ordinateur dédié pour l'art IA, un tel fichier BAT pour lancer ComfyUI est optimal (non seulement pour générer des images avec SD3M, d'ailleurs — il convient tout à fait aussi pour SDXL) :
@echo off
call cd C:Fun-n-GamesGitstable-diffusion-webuivenvScripts
echo %
call activate.bat
echo venv activé
call cd C:Fun-n-GamesComfyUI-SD3
echo %
call .python_embededpython.exe -s ComfyUImain.py —disable-smart-memory
pause
Il est supposé que l'installation portable de ComfyUI a été réalisée dans le répertoire C:Fun-n-GamesComfyUI-SD3, et que AUTOMATIC1111 a été précédemment installé dans C:Fun-n-GamesGitstable-diffusion-webui. De nombreux « echo » sont nécessaires simplement pour le contrôle visuel de ce que le changement de répertoire se passe normalement et que les bonnes commandes s'exécutent — une fois que tout sera corrigé, ils pourront être supprimés du fichier BAT.
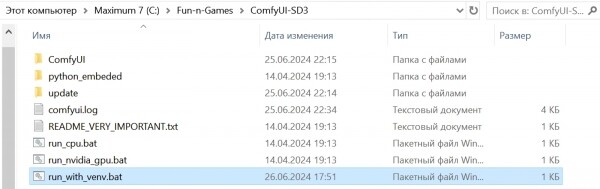
Nous redémarrons l'environnement de travail, cette fois en double-cliquant sur run_with_venv.bat. Comme nous avons précédemment simplement fermé le serveur, et que l'interface web n'a pas été touchée, l'onglet correspondant doit toujours afficher cette même boucle de référence ComfyUI avec les noms de modèles modifiés. Regardons du côté droit : il y a un nœud intitulé « Preview Image », qui ne sauvegarde pas l'image finale sur le disque, mais simplement la montre. Si l'on exécute à chaque fois la boucle pour générer une seule image de manière stricte, l'évaluer visuellement, modifier certains paramètres, puis relancer, c'est tout à fait une option viable : l'image appréciée peut toujours être sauvegardée manuellement en cliquant avec le bouton droit de la souris dessus. Mais si l'on effectue de nombreuses générations consécutivement dans l'environnement de travail, il est préférable que leurs résultats soient automatiquement accumulés dans la mémoire permanente (dans le répertoire ComfyUIoutput par défaut).
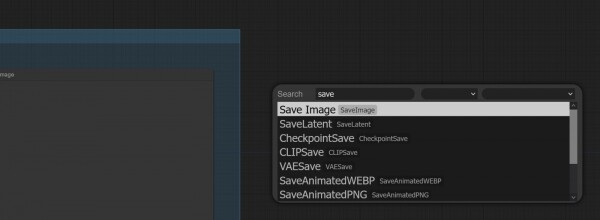
Il vaut donc mieux changer tout de suite le nœud « Preview Image » en « Save Image ». Pour cela, il suffit de double-cliquer avec le bouton gauche de la souris sur n'importe quelle zone libre de la boucle — une fenêtre de sélection des nœuds avec une barre de recherche s'ouvrira. Dans cette barre, nous commencerons à taper « Save… » — et presque immédiatement, le nom recherché apparaîtra. Il ne restera plus qu'à cliquer dessus et à connecter l'entrée du nouveau nœud à la sortie « IMAGE » du nœud « VAE Decode », où le nœud « Preview Image » était initialement connecté. Le nœud « Preview Image » peut alors être retiré — il suffit de le sélectionner en cliquant sur le titre et de presser la touche « Del » sur le clavier.
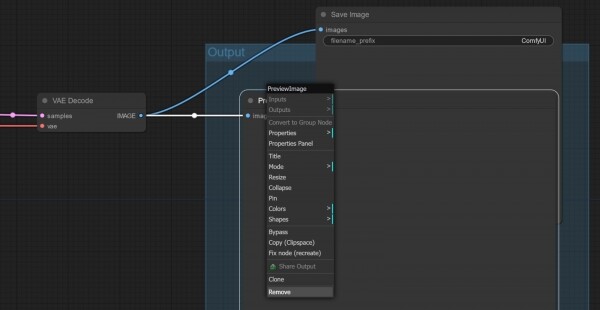
Et voilà, il est temps de lancer la boucle de référence conçue par ComfyAnonimous (avec nos modestes ajustements) pour exécution. Voici ce que cela donne :
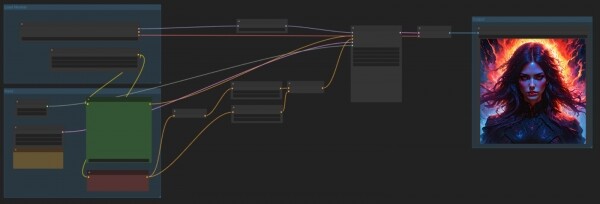
Une image très impressionnante, même avec une ambiance — et on ne dirait pas qu'elle a été créée avec le même modèle qui est censé dessiner des personnes allongées sur l'herbe. En même temps, le système fonctionne assez rapidement — environ 5-6 secondes par itération pour une image de 1 mégapixel sur une GTX 1070 peut être considéré comme un bon résultat. Pour comparer : ce même PC dans le même ComfyUI avec le même fichier BAT génère des images SDXL de tailles similaires, prenant environ 6-7 secondes pour chaque itération, donc on peut considérer que la « trois » est moins exigeante en matière de matériel sur lequel se fait la génération IA.
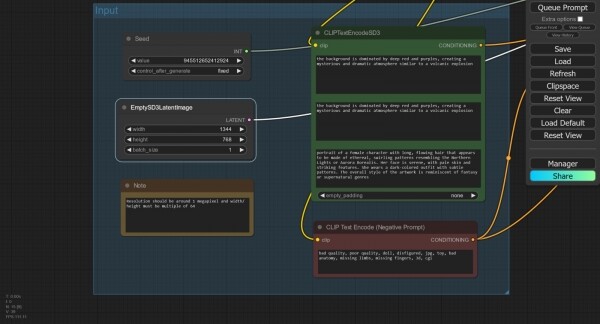
Nous allons maintenant ajuster les dimensions du canevas. Près du nœud «EmptySD3LatentImage», qui les définit, se trouve un nœud de référence «Note» «vide» (c'est-à-dire non connecté), où se trouve un rappel important : la surface totale de l'image dans le cas de SD3M doit être d'environ 1 Mpx, à partir de quoi il convient de choisir les dimensions des côtés du canevas rectangulaire. Nous les définirons donc à 1344×768 – ce qui correspond à environ 1,03 Mpx.
Faisons attention : plus haut se trouve le nœud «Seed», où la graine propre est définie, dans ce cas «945512652412924», et il est indiqué qu'elle ne doit pas changer après la génération (paramètre «fixed»).
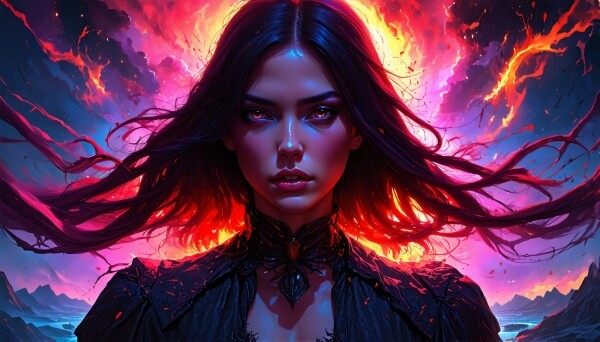
Exécutons le même schéma avec l'ancienne graine, mais déjà pour un canevas rectangulaire. Il est immédiatement évident que le temps d'exécution est globalement réduit, bien que la vitesse de dessin soit restée la même – moins de 6 s par itération. Et c'est logique : puisque les invites textuelles n'ont pas changé, il n'est pas nécessaire de recharger le(s) encodeur(s) pour elles. L'image en sortie, bien sûr, diffère légèrement de la première, carrée, mais pas fondamentalement – la composition générale, comme on pouvait s'y attendre, a été préservée.
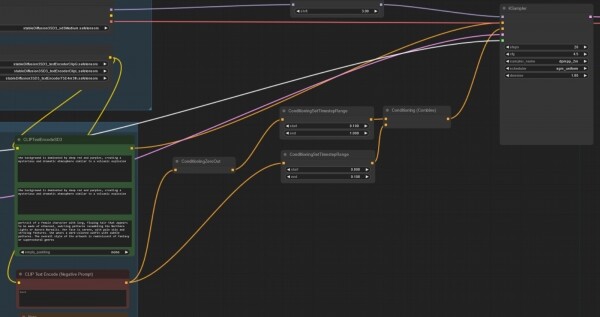
Maintenant, portons notre attention sur les nœuds «CLIPTextEncodeSD3» et «CLIP Text Encode (Negative Prompt)». Le premier se distingue par le fait qu'il contient immédiatement trois champs de saisie ; si l'on enlève le texte, les annotations indiquant pour quels encodeurs ils sont destinés deviendront visibles : de haut en bas, il s'agit de CLIP G, CLIP L et T5XXL. Auparavant, de tels nœuds n'existaient pas dans ComfyUI pour des raisons évidentes. Le schéma de référence contient des invites courtes et répétées pour les deux premiers champs textuels (pour les encodeurs CLIP G et CLIP L) et une invite beaucoup plus longue pour le troisième – T5XXL. Il est clair que l'on peut jouer avec le contenu de ces champs dans des limites larges, et l'étude de la mesure dans laquelle la modification du texte en eux influence l'image finale est une tâche non triviale, mais très captivante. Cependant, pour des raisons qui deviendront claires un peu plus tard, nous ne nous y attarderons pas pour l'instant.
Dans le nœud « CLIP Text Encode (Negative Prompt) », il n'y a rien de particulier. Cependant, notez à quel point il est complexe de passer de celui-ci à l'entrée correspondante « conditioning » du nœud principal « KSampler » ! Ce chemin se divise, et l'une de ses branches (la supérieure dans ce cas) indique qu'à partir de 10 % des étapes de génération et jusqu'à sa fin, le système ne prendra en compte aucunement la suggestion négative (le passage par le nœud « ConditioningZeroOut » signifie justement l'annulation de la condition). Alors que la deuxième branche fait passer la suggestion négative (conditionnellement, également avec un poids réduit) pour un traitement ultérieur sans modifications — mais seulement durant les premiers 10 % du nombre total d'étapes de génération.
Lointain brumeux
Encore une fois : pendant les 10 % initiaux, c'est-à-dire 3 des 28 étapes de génération assignées dans ce cas, la suggestion négative est transmise au nœud « KSampler », qui est chargé de former l'image dans l'espace latent (dans l'espace pixel, c'est-à-dire dans une image compréhensible par l'homme, dont le résultat est traduit par le nœud suivant, « VAE Decoder »), de manière normale : la branche supérieure (avec l'annulation de la condition) est inactive, seule la branche inférieure fonctionne. Les 90 % restants des étapes (25 sur 28 dans notre cas) ne tiennent absolument pas compte de la suggestion négative : c'est la branche supérieure de transmission des conditions qui est active — avec leur annulation — et le mouvement dans la branche inférieure est bloqué par le paramètre de déclenchement correspondant du nœud « ConditioningSetTimestepRange ». Maintenant, il est clair pourquoi certains observateurs affirment que , — l'effet qu'elles provoquent (si l'on considère précisément ce cycle de référence et que l'on suppose que des règles analogues s'appliquent sur les sites de génération en ligne selon le modèle SD3 Medium) est minimal.
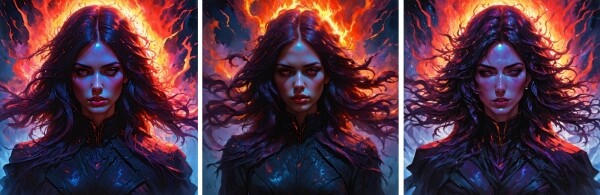
Et pourtant, il existe : si l'on connecte directement la sortie du nœud « CLIP Text Encode (Negative Prompt) » à l'entrée correspondante de « KSampler » (ou si l'on marque tous les nœuds intermédiaires avec des conditions sur ce chemin comme « à ignorer », « Bypass », ce qui aura le même effet), la qualité de l'image finale se dégradera considérablement. Cela peut d'ailleurs être considéré comme une preuve indirecte de la « non-couverture » de SD3M, car ajuster la force et l'importance de l'invite négative, en théorie, aurait dû être à la portée des développeurs dès la mise à disposition des poids du modèle en accès public. Les deux branches finement réglées des conditions d'application de l'invite négative constituent une sorte de rustine, et en ce sens aux attentes suscitées par le département marketing de Stability AI à son égard, semblent parfaitement fondées.
L'absence ne serait-ce que d'un bref guide officiel sur l'utilisation de SD3M a conduit à circuler sur Internet des rumeurs selon lesquelles ce modèle Ce qui, bien sûr, n'est pas le cas, mais dans tous les cas, ces invites doivent être appliquées d'une manière différente En particulier, les enthousiastes affirment sérieusement que l'ajout dans le champ négatif de descriptions détaillées d'un maximum d'indécences (oui, oui, le bon vieux « nsfw, nude » n'est pas suffisant — il faudra sérieusement faire preuve d'imagination) même de la fameuse fille allongée sur l'herbe. Que ce soit vrai ou non — on ne pourra le déterminer sans une vérification approfondie (et il n'est même pas certain que la mention « 18+ » en tête de notre site protègera la publication de poursuites judiciaires de la part de fervents défenseurs de la morale, si nous prenons le risque de publier l'« astuce miracle » compilée par les enthousiastes — bien qu'elle soit en anglais). Cette situation amusante rappelle le cas avec , grâce auxquels — précisément parce qu'ils contenaient des descriptions plutôt détaillées de ce qu'il ne fallait pas faire pour être de bons chrétiens — nous avons au moins des témoignages écrits fragmentaires sur les croyances et les coutumes de la Russie préchrétienne.
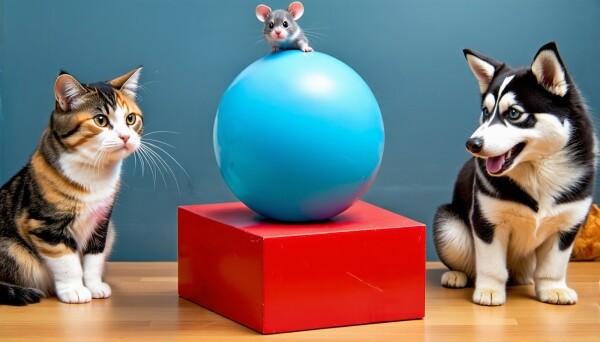
Maintenant, espérons qu'il est devenu plus clair pourquoi approfondir l'étude de SD3M à ce stade ne semble pas être une perte de temps et d'énergie. Il y a vraiment beaucoup à discuter et à explorer : les paramètres de génération fortement recommandés dans le nœud « KSampler » (CFG — 4,5-5,0 ; nombre d'étapes — environ 28 ; couple sampler/scheduler — exclusivement dpmpp_2m/sgm_uniform, sinon la qualité des résultats décroît nettement) ; et la variabilité significative de la qualité subjective des générations avec exactement les mêmes paramètres de départ, mais avec des amorces différentes ; et la disparition de la fameuse « malédiction de rester dans/sur l'herbe » (pour quoi déjà ); et, en somme, déterminer quels paramètres de génération sont influencés par chacun des trois transformateurs de texte en tokens — et comment, en les manipulant, obtenir de véritables chefs-d'œuvre d'Art IA (si cela est possible avec le « trois », bien sûr).
D'autant plus que le licenciement d'Emad Mostaque en mars et de ComfyAnonimous en juin, , — ne sont pas les seules mauvaises nouvelles ayant frappé Stability AI. Comme le rapporte Reuters en se référant à The Information, cette start-up britannique vient tout juste (au moment de rédaction de cet article) de qui est désormais Prem Akkaraju, protégé d'un célèbre groupe mondial d'investisseurs en technologies — et ce dernier est prêt à injecter dans la société une somme considérable en liquidités (). La position même de Stability AI en tant que structure commerciale est aujourd'hui franchement instable ; de nombreux enthousiastes déçus prédisent sa fin prochaine — et dans une telle situation, il est difficile d'attendre d'une entreprise un travail réfléchi même sur des erreurs aussi évidentes.
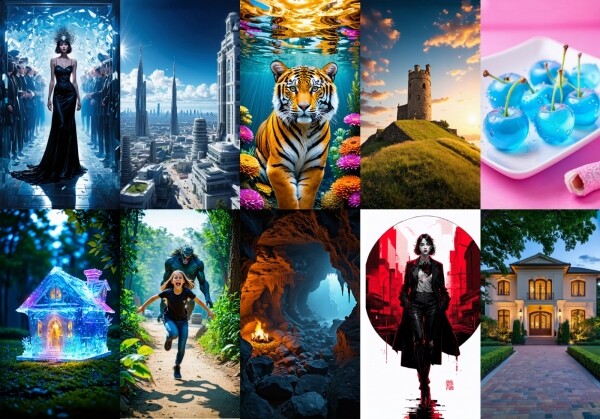
Une politique de licences inadaptée empêche, hélas, la communauté de peaufiner SD3M par elle-même, comme cela a été le cas avec SD 1.5 et SDXL. Au moins, les points de contrôle dérivés et les outils comme LoRA pour les deux derniers modèles resteront assurément accessibles pour une exécution locale, même lorsque (et si) Stability AI met fin à son parcours en tant que structure commerciale. Juste après l'effondrement retentissant de la « trilogie », les voix en faveur de la création d'un projet non lucratif pour le développement d'un modèle génératif de transformation de texte en images sur la base d'un financement participatif se sont multipliées sur les forums spécialisés. À l'heure actuelle, ce mouvement commence à se structurer sous le nom . Des entités telles qu'Invoke (une plateforme d'IA générative en ligne destinée aux studios professionnels), Comfy Org (une équipe soutenant et développant ComfyUI), Civitai (qui n'a pas besoin de présentation) et l'équipe derrière LAION (une base d'images annotées, utilisée principalement pour l'entraînement de ce type de modèles) ont déjà exprimé leur volonté de s'y joindre activement.
Il est donc probable que les nouvelles éditions de la « Fabrique » se concentrent à l'avenir sur les modèles pour lesquels la communauté a déjà pu créer un large éventail d'améliorations et d'outils supplémentaires, à savoir la « version 1.5 » et « Oversize ». Peut-être que le temps de l'essor de SD3M viendra encore, mais il est actuellement difficile de dire à quel moment cela pourrait être. En attendant, les intéressés peuvent télécharger l'archive contenant les générations SD3M présentées dans cet article (les cycles sont intégrés directement dans les fichiers PNG ; il suffit de faire glisser l'image sur l'interface de ComfyUI depuis l'explorateur Windows pour reproduire l'ensemble des paramètres et de l'ordre de génération) . Peut-être que certains de nos lecteurs pourront découvrir auparavant que les habitués de Reddit et Hugging Face la manière optimale de répartir le texte sur les trois champs d'instructions, par exemple ?
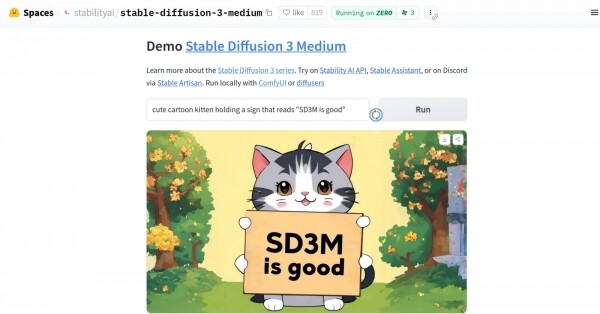
Matériaux sur le sujet :
.
.
.
.
.
Source : 3dnews.ru
