

Intel Foundry a publié un document publicitaire, décrivant en détail les solutions avancées de l'entreprise dans le développement et la mise en œuvre de matériels pour des applications d'intelligence artificielle et de calcul haute performance. Intel a également démontré un « échantillon de puce pour l'IA », illustrant les capacités actuelles de l'entreprise dans le domaine de l'emballage.
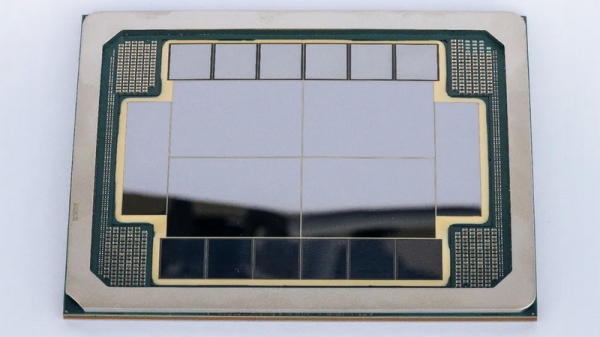
Intel a présenté un système en package (SiP) de la taille de huit photomasques de puces standard, comprenant quatre blocs logiques, 12 piles de classe HBM4 et deux blocs d'E/S. Contrairement à la conception à grande échelle avec 16 blocs logiques et 24 piles HBM5, présentée par l'entreprise le mois dernier, ce système est déjà réellement viable pour la production aujourd'hui.
Il est important de noter qu'Intel Foundry a montré non pas un accélérateur IA fonctionnel, mais un « échantillon de puce pour l'IA », démontrant comment il est possible de créer physiquement (ou plutôt d'assembler) de futurs processeurs pour l'IA et le calcul haute performance. Intel présente toute la méthode de construction qui réunit de grands blocs de calcul, des piles de mémoire à haute vitesse, des interconnexions entre puces ultra-rapides et de nouvelles technologies d'alimentation dans un seul boîtier technologique. Ce boîtier diffère considérablement de ce que proposent aujourd'hui des entreprises comme TSMC. Intel veut montrer que les processeurs de nouvelle génération pour l'IA haute performance peuvent avoir une conception multi-puces, et Intel Foundry est déjà capable de les produire.
La plateforme présentée est fondée sur quatre grands blocs logiques, apparemment construits sur le processus technologique Intel 18A (ce qui signifie qu'elle utilise des transistors RibbonFET à grille circulaire et un système d'alimentation PowerVia à l'arrière), entourés de piles de mémoire de classe HBM4 et de blocs d'entrée-sortie. Tous les éléments clés sont vraisemblablement interconnectés par des ponts EMIB-T 2.5D, intégrés directement dans le substrat du boîtier. Intel utilise la technologie d'interface inter-chip EMIB-T, qui ajoute des vias silicii traversants à l'intérieur des ponts, permettant à l'alimentation et aux signaux de circuler à la fois verticalement et horizontalement, pour maximiser la densité des interconnexions et de l'alimentation. La plateforme est conçue pour des interfaces inter-chip UCIe fonctionnant à des vitesses de 32 GT/s et plus, qui semblent également être utilisées pour connecter des piles C-HBM4E.
Le prototype de la puce démontre également le passage d'Intel à l'assemblage vertical. La feuille de route des procédés de fabrication de l'entreprise inclut la technologie Intel 18A-PT, spécialement conçue pour les chiplets, qui impliquent de placer d'autres cristaux logiques ou de la mémoire en hauteur. Par conséquent, les chiplets doivent avoir une alimentation à l'arrière, ainsi que des interconnexions traversantes et hybrides. Dans le cas du « prototype de processeur IA », les cristaux de base 18A-PT sont positionnés sous les cristaux de calcul 18A/18A-P et agissent soit comme de grands puces de mémoire cache, soit remplissent une autre fonction auxiliaire. Pour la connexion verticale des chiplets, Intel utilise la famille de technologies d'emballage Foveros — Foveros 2.5D, Foveros-R et Foveros Direct 3D. Ces technologies permettent de réaliser une connexion en cuivre à pas fin entre les cristaux actifs pour garantir un maximum de bande passante et d'efficacité énergétique pour les cristaux supérieurs. Avec les ponts EMIB, ces méthodes permettent à Intel de créer un assemblage hybride latéral-vertical, que l'entreprise positionne comme une alternative aux grands interposeurs en silicium avec un meilleur taux d'utilisation des plaques et un rendement accru.
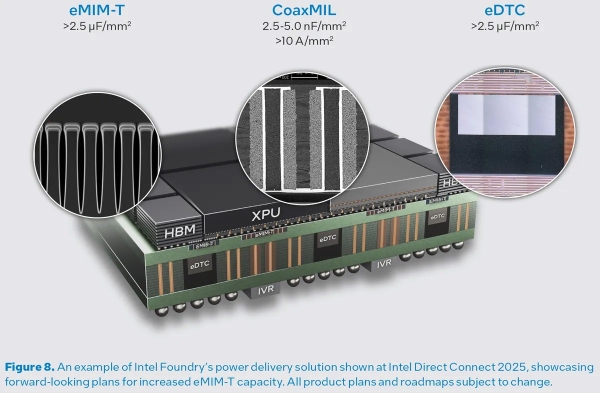
Pour les accélérateurs IA multi-puces et le calcul haute performance, la principale contrainte de conception est l'alimentation. À cette fin, la plateforme Intel doit combiner toutes les dernières innovations Intel en matière d'économie d'énergie, y compris PowerVia, les condensateurs intégrés Omni MIM, l'isolation au niveau du pont dans EMIB-T, et les condensateurs eDTC et eMIM-T sur le die principal, ainsi que des inducteurs intégrés CoaxMIL pour prendre en charge les régulateurs de tension semi-intégrés (IVR), situés sous chaque pile et sous le boîtier lui-même (contrairement aux IVR dans le cas de CoWoS-L de TSMC, qui sont intégrés à l'interposeur). Ce réseau multi-niveau est conçu pour soutenir un courant stable dans des charges de travail d'IA générative sans baisse de la tension.
Avec sa démonstration, Intel essaie manifestement d'attirer des clients. Pour l'instant, on ne sait pas si l'accélérateur IA de nouvelle génération, codé Jaguar Shores, dont le lancement est prévu pour 2027, utilisera l'architecture que Intel présente aujourd'hui.
Source :
Source : 3dnews.ru
