

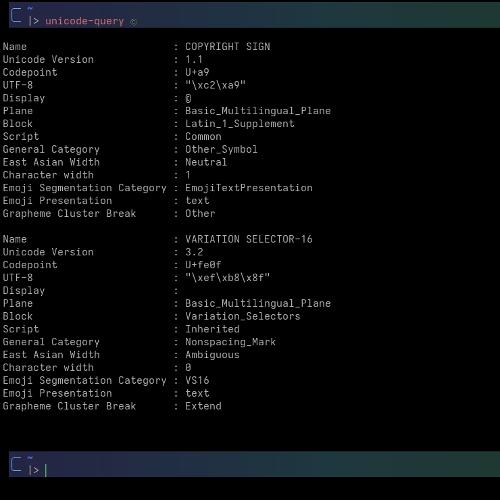
La version 0.9.0 de la bibliothèque pour le langage C++ (standard C++20) a été publiée libunicode. Le projet est développé par l'équipe de développement de l'émulateur de terminal Contour et de l'interface Endo (en développement actif) et est distribué sous la licence Apache 2.0.
Fonctionnalités de la bibliothèque:
- support des normes Unicode 17.0:
- API pour obtenir les propriétés Unicode;
- optimisation SIMD de certaines fonctions (en utilisant std::simd ou std::experimental::simd si disponibles);
- conversion optimisée entre UTF-8 UTF-16/UTF-32;
- équivalent de la fonction wcwidth (int unicode::width(char32_t));
- segmentation du texte par graphèmes, caractères, emojis et scripts;
- transformation de case et comparaison de chaînes;
- API de haut niveau pour la segmentation de texte, adaptée à l'implémentation du shaping de texte.
- couverture du test de la plupart des fonctionnalités de la bibliothèque (largeur de caractère et segmentation).
Le package comprend également l'outil en ligne de commande unicode-query pour obtenir des informations détaillées sur les chaînes.
Modifications :
- ajout de l'API grapheme_cluster_width;
- améliorations concernant les versions Unicode (« Age »);
- prise en charge complète UAX #15 Forms de Normalisation Unicode avec traitement en continu :
normalizer norm(Normalization_Form::NFC); // Alimente e décomposé + accent combinant, puis un nouveau déclencheur pour émettre auto result = norm.feed(U’e’); CHECK(result.empty()); // encore en tampon result = norm.feed(U’u0301′); CHECK(result.empty()); // encore en tampon (marque combinante) result = norm.feed(U’x’); // le déclencheur active l'émission du segment précédent REQUIRE_FALSE(result.empty()); CHECK(result == U"u00E9"); // e + accent composé en e-accente result = norm.flush(); CHECK(result == U"x"); // segment final
- la fonction script_extensions renvoie maintenant std::optional<std::span>;
- la règle GB9c de segmentation des groupes de glyphes pour les combinaisons de caractères des langues du groupe Indic a été mise en œuvre;
- les règles dans grapheme_segmenter pour GB11 et GB4/GB5 ont été corrigées ; API obsolète supprimée ;
- conversion optimisée par SIMD de UTF-8 en UTF-16/UTF-32 mise en œuvre ;
- la largeur des caractères de liaison Hangul V/T est maintenant nulle ;
- segmentation basée sur les limites de mots mise en œuvre ;
- corrections dans l'API C ;
- refactorisation du système de construction et du générateur de tableaux auxiliaire C++;
- ajout de tests complets pour la conversion UTF-16/UTF-32 ;
- ajout de la compilation statique de l'outil unicode-query dans le CI.
Source : linux.org.ru
