

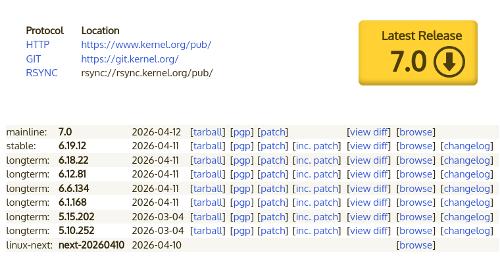
Après deux mois de développement, Linus Torvalds présenté a annoncé la sortie du noyau Linux 7.0. Parmi les changements les plus notables : les règles d'utilisation des assistants AI, le passage de Rust aux fonctionnalités principales du noyau, l'amélioration des performances de swap, l'activation par défaut du mode PREEMPT_LAZY, le support des filtres pour les opérations io_uring, le nouveau système de fichiers Nullfs, l'infrastructure fserror, les outils de surveillance XFS, le support du remappage dans Btrfs, l'activation par défaut de la version NFS 4.1, l'intégration de l'algorithme cryptographique post-quantique ML-DSA, l'activation d'AccECN dans le sous-système réseau, un support initial pour WiFi 8.
Le numéro 7.0 a été attribué, car la branche 6.x a accumulé suffisamment de versions pour justifier le changement du premier chiffre dans le numéro de version (la version 6.0 avait été formée juste après 5.19). Changer de numérotation est principalement une question esthétique et représente une démarche formelle qui élimine le désagrément causé par l'accumulation d'un grand nombre de versions dans la série.
La nouvelle version inclut 15624 corrections de la part de 2477 développeurs, la taille du patch est de 56 Mo (les modifications ont concerné 18053 fichiers, 704060 lignes de code ont été ajoutées, et 278132 lignes supprimées). Dans la version précédente, il y avait 15657 corrections de 2237 développeurs et la taille du patch était de 52 Mo. Environ 51 % de toutes les modifications présentées dans la version 7.0 sont liées aux pilotes de périphériques, environ 11 % concernent la mise à jour de code spécifique aux architectures matérielles, 14 % concernent la pile réseau, 5 % aux systèmes de fichiers et 3 % aux sous-systèmes internes du noyau.
Les principales nouveautés du noyau 7.0 (kernelnewbies.org, lwn.net, OpenNET):
- Sous-système de disque, entrée/sortie et systèmes de fichiers
- L'infrastructure fserror a été mise en œuvre et ajouté une API pour obtenir des informations sur les erreurs d'entrée/sortie et la corruption des métadonnées lors de la manipulation de fichiers. L'infrastructure proposée unifie dans les systèmes de fichiers la transmission d'informations sur les erreurs vers l'espace utilisateur via le mécanisme fsnotify.
- Dans XFS ajoutées nouvelles fonctionnalités pour surveiller l'état du système de fichiers depuis l'espace utilisateur. Une opération ioctl XFS_IOC_HEALTH_MONITOR a été proposée, renvoyant un descripteur de fichier à travers lequel il est possible d'obtenir des informations sur les pannes liées à la corruption des métadonnées ou à l'apparition d'erreurs d'entrée/sortie, ainsi que de suivre les changements d'état du FS, tels que le démontage et l'arrêt. De plus, un processus en arrière-plan géré par systemd, xfs_healer, a été proposé pour traiter les événements sur l'état du FS depuis l'espace utilisateur et, si nécessaire, le redémarrer automatiquement. procédures de récupération.
- Le système de fichiers Btrfs a ajouté un support expérimental pour la structure "arbre de remappage" (remap tree), qui pourrait à l'avenir être utilisée comme une couche intermédiaire lors de l'exécution des opérations d'entrée-sortie. L'ajout a pour but qu'après le déplacement des données sur le stockage, au lieu de mettre à jour toutes les structures associées à ces données, d'anciennes et de nouvelles adresses de données soient conservées dans la structure supplémentaire "remap tree", puis lors de l'accès aux données, les adresses soient remplacées. La nouvelle approche est présentée comme plus fiable et flexible, tout en simplifiant l'expansion future des fonctionnalités de Btrfs.
- Dans Btrfs réalisée support du passage direct en entrée/sortie dans les situations où la taille du bloc dépasse la taille de la page mémoire dans le système.
- Comprend le sont incluses. nouveau système de fichiers Nullfs, qui peut être utilisé comme un substitut pour le système de fichiers racine. Le système de fichiers Nullfs est toujours vide, ne contient pas de données et ne supporte pas les modifications. L'objectif de Nullfs est d'être utilisé comme système de fichiers initial pour simplifier le processus de démarrage du système – d'autres systèmes de fichiers sont ensuite montés sur Nullfs et l'appel système pivot_root() est utilisé pour changer le système de fichiers racine au lieu de vider le contenu de l'initramfs et d'utiliser le système de fichiers racine associé.
- Implémenté la mise à jour des informations sur le temps de modification des fichiers en mode non-bloquant. Auparavant, l'appel file_update_time_flags() avec le drapeau IOCB_NOWAIT retournait une erreur -EAGAIN, ce qui empêchait l'utilisation des opérations d'écriture directe en mode non-bloquant.
- Dans les systèmes de fichiers sous forme d'options activables séparément, traduit le support des verrouillages de notification (lease). Par défaut, ce mécanisme n'est plus activé en raison de problèmes avec le système de fichiers, initialement non conçu pour son utilisation. Par exemple, il n'est pas pris en charge par les systèmes de fichiers 9p et cephfs.
- Dans le système de fichiers EROFS (Extendable Read-Only File System), destiné à être utilisé sur des partitions accessibles uniquement en lecture, l'algorithme LZMA est utilisé par défaut pour la compression. Les algorithmes DEFLATE et Zstandard sont disponibles en option et ne sont plus marqués comme expérimentaux. Le partage d'entrées dans le cache de pages (page-cache) pour des fichiers identiques dans différents systèmes de fichiers EROFS a été implémenté.
- Supprimé Le mode laptop_mode, qui économise l'énergie en retardant et en regroupant les opérations d'écriture sur le disque dur afin de prolonger le temps d'inactivité du disque et de réduire le nombre de réveils, a perdu de son importance car dans les dispositifs mobiles modernes, les disques durs ont été remplacés par des disques à état solide.
- Le système de fichiers F2FS a été transformé pour utiliser de grands folios de pages mémoire (large folios).
- La réécriture du pilote ntfs3 a été relancée, développée par la société Paragon Software. Le support des opérations avec des fichiers basées sur iomap a été ajouté, les options llseek SEEK_DATA/SEEK_HOLE ont été implémentées, et le mode delalloc pour l'allocation différée de blocs a été ajouté. Entre-temps, dans la liste de diffusion des développeurs du noyau, en février, il a été approuvé d'intégrer dans l'une des futures versions du noyau une nouvelle implémentation de NTFS — ntfsplus, conçue pour remplacer ntfs3.
- Par défaut, lors de la construction, sont incluses. la version du protocole NFS 4.1 (CONFIG_NFS_V4_1). Une verrouillage de l'exportation via NFS de systèmes de fichiers pseudo-spécialisés, tels que pidfs et nsfs, a été assuré. Dans NFSD, réalisée une possibilité expérimentale d'utiliser des ACL POSIX et ajouté le support du changement dynamique du pool de threads (thread-pool) en fonction de la charge a été ajouté.
- Mémoire et services système
- Virtualisation et sécurité
- dans le système d'E/S asynchrone io_uring réalisée la possibilité d'attacher des programmes BPF avec des filtres contrôlant ce que peuvent faire certaines opérations SQE (Submission Queue Entry) (similaires aux appels système dans io_uring). La fonction ajoutée est l'analogue des filtres d'appels système. Les filtres peuvent être liés à des tâches spécifiques et sont hérités lors de la création d'autres processus après un appel à fork(). En présence de filtres actifs, les filtres ajoutés en superposition ne peuvent qu'attacher des restrictions supplémentaires, sans pouvoir désactiver les filtres existants. La fonction mise en œuvre permettra de bloquer des méthodes le contournement de la filtration des appels système dans des environnements sandbox, basés sur l'exécution d'opérations analogiques fournies dans io_uring.
- Dans SELinux ajouté la possibilité de gérer l'accès aux jetons BPF, permettant à des processus non privilégiés d'effectuer certaines opérations privilégiées avec BPF, par exemple, charger des programmes BPF dans le noyau et créer des structures de type map.
- Ajouté le support de l'algorithme de signature numérique ML-DSA (CRYSTALS-Dilithium), basé sur la théorie des réseaux et résistant à une attaque par ordinateur quantique. Fournie la possibilité d'utiliser ML-DSA pour l'authentification des modules noyau.
- Retirée la possibilité d'utiliser des schémas de signature numérique avec l'algorithme SHA-1 pour certifier les modules noyau (le support de chargement de modules signés est maintenu).
- Dans l'enregistrement d'audit NETFILTER_PKT ajoutées les champs sport et dport pour inspecter les numéros de ports réseau, et non seulement les adresses IP.
- Pour les systèmes avec architecture RISC-V réalisée le support des extensions Zicfiss et Zicfilp, fournissant des capacités matérielles pour appliquer la protection CFI (Control Flow Integrity), bloquant les violations de l'ordre normal d'exécution des instructions (flow de contrôle) en raison de l'application d'exploits modifiant les pointeurs de fonction stockés en mémoire.
- Dans l'hyperviseur KVM réalisée la possibilité de transmettre aux systèmes invités des informations sur le support par le processeur de l'extension ERAPS (Enhanced Return Address Predictor Security), permettant d'éviter certaines opérations de réinitialisation de l'état du CPU lors du retour de contrôle à l'hôte par le système invité. De plus, ajouté prise en charge du rattachement des systèmes invités à l'équipement pour le suivi des performances (PMU, Performance Monitoring Unit), ce qui permet d'améliorer la précision du profilage par rapport à l'utilisation de PMU émulées.
- Pour le pilote de l'hyperviseur Hyper-V ajouté prise en charge de l'interface debugfs pour afficher des statistiques sur le fonctionnement de l'hyperviseur.
- Sous-système réseau
- L'extension AccECN est activée par défaut (Notification explicite précise de congestion), qui implémente une version améliorée de l'extension ECN (wikipedia.org), permettant aux hôtes de marquer les paquets IP en cas de surcharge au lieu de les abandonner, ce qui permet de détecter l'apparition d'une congestion initiale dans les canaux de communication sans perte de paquets. L'extension ECN d'origine a une limitation qui ne permet d'émettre qu'un seul signal de saturation dans un cycle de transmission TCP (RTT, Round-Trip Time, envoi de la demande et réception de la réponse). AccECN supprime cette limitation et permet au destinataire de transmettre plusieurs marqueurs de surcharge à l'expéditeur dans l'en-tête du paquet TCP. Les algorithmes de contrôle de la congestion peuvent utiliser ces informations pour réagir plus précisément aux surcharges et éviter une réduction brusque de l'intensité d'envoi de paquets lors d'une légère surcharge.
- Dans la mise en œuvre de l'algorithme de gestion des files d'attente réseau Cake ajouté , possibilité de traiter plusieurs files d'attente pour répartir la charge sur plusieurs cœurs CPU. L'algorithme CAKE est appliqué pour réduire l'impact négatif de la mise en mémoire tampon intermédiaire des paquets sur l'équipement réseau frontal, visant à atteindre la bande passante maximale possible et le niveau de latence minimal, même sur des canaux de communication lents.
- Sur les sockets VSOCK, utilisés pour interagir avec des machines virtuelles, ajouté prise en charge des espaces de noms réseau (network namespace).
- Ajouté mise en œuvre initiale de la future norme WiFi 8 (802.11bn, WiFi ultra haute fiabilité).
- Ajoutés optimisations qui ont permis d'augmenter de 12 % le rendement du traitement des paquets UDP entrants lors des tests de stress sur un réseau de 100 gigabit.
- Matériel
- Dans le pilote AMDGPU réalisée la prise en charge des blocs IP, utilisés dans les nouveaux GPU AMD, tels que SMUIO 15.x, PSP 15.x, IH 6.1.1/7.1, MMHUB 3.4/4.2, GC 11.5.4/12.1, SDMA 6.1.4/7.1/7.11.4 et JPEG 5.3.
- Dans le pilote Nouveau, la gestion de la fréquence a été améliorée sur les systèmes Tegra 186+.
- Dans le pilote i915 ajouté prise en charge initiale du bloc IP d'affichage Xe3p_LPD utilisé dans les processeurs Intel Nova Lake-P.
- Poursuivie le travail sur le pilote drm (Direct Rendering Manager) Xe pour les GPU basés sur l'architecture Intel Xe, utilisé dans les cartes graphiques Intel de la famille Arc et le graphisme intégré à partir des processeurs Tiger Lake. Ajout du mode Multi Queue. Ajoutés composants nécessaires au diagnostic des plantages de GPU dans Mesa. Ajouté prise en charge du mécanisme MERT pour la gestion de l'accès à la mémoire GPU.
- Poursuivie intégration des composants du pilote Nova pour les GPU NVIDIA équipés de firmware GSP, utilisés à partir de la série NVIDIA GeForce RTX 2000 basée sur l'architecture Turing. Le pilote est écrit en Rust. La nouvelle version prépare la prise en charge des GPU basés sur l'architecture Turing et inclut divers changements internes.
- Ajouté prise en charge des contrôleurs et des périphériques avec une interface SPI (Serial Peripheral Interface) multicanal permettant de transmettre des données dans plusieurs flux parallèles.
- Ajouté pilote pour connecteurs combinés Type-C utilisés sur des appareils basés sur des puces Apple Silicon, combinant les interfaces USB3, DP-AltMode et Thunderbolt/USB4.
- Ajout de la prise en charge des sous-systèmes audio des puces Tegra238, Minisforum V3 SE, iBasso DC04U, Intel Nova Lake, Nova Lake S et Focusrite Forte.
- Ajout de la prise en charge des plates-formes ARM, SoC et des dispositifs : Arduino UnoQ, OrangePi 6 Plus, OrangePi CM5, Anbernic RG-DS, Realtek Kent, Qualcomm Kaanapali, Mediatek Ezurio, Facebook Anacapa, Microchip LAN9668, Khadas VIM1S, QNAP TS133, i.MX952, i.MX93, i.MX94, VHIP4 EvalBoard, TQ-Systems MBLS1028A, Agilex5, Radxa CM3J, Glymur,
- Ajout de la prise en charge des smartphones et tablettes : Fairphone Gen 6 (SoC Qualcomm Milos/Snapdragon 7s Gen 3), Pixel 3/3 xl, Microsoft surface pro 11.
Simultanément, la Fondation latino-américaine pour le logiciel libre a formé une variante du noyau entièrement libre 7.0 – Linux-libre 7.0-gnu, débarrassé des éléments des firmwares et des pilotes contenant des composants ou des segments de code non libres, dont l'usage est restreint par le fabricant. Dans la version 7.0, un nettoyage des blobs du pilote iwlwifi a été effectué. Le code de nettoyage a été mis à jour pour les pilotes amdgpu, adreno, TI PRUeth, air_en8811h, ath12k, TI VPE, rtw8852b, rt1320, rt5575 SPI, tas2783, Intel catpt. Les noms des blobs ont été nettoyés dans les fichiers dts (devicetree) pour les puces ARM.
Source : linux.org.ru
