

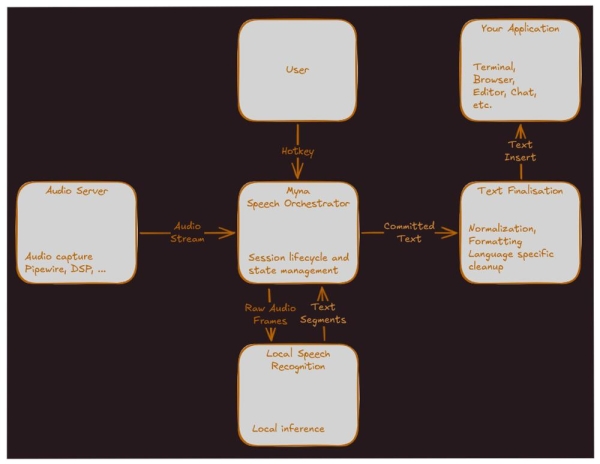
Canonical a présenté le projet Myna — un nouveau système de conversion de la parole en texte pour Ubuntu Desktop. Le projet vise à intégrer la dictée : l'utilisateur appuie sur une touche de raccourci, parle et le texte reconnu s'affiche dans l'application active. Dans l'annonce, il est souligné que Myna doit se sentir comme une partie naturelle du bureau Ubuntu tout en prenant en compte la vie privée de l'utilisateur. La liste des langues d'entrée prises en charge au moment de la publication de l'annonce n'a pas été divulguée.
Le premier objectif du projet est de Ubuntu 26.10. À ce stade, Canonical n'essaie pas de créer un véritable assistant vocal ni un système de contrôle du bureau par la voix. Les développeurs ont délibérément limité le champ de la première version à une dictée simple et fiable : appuyer sur une combinaison de touches, prononcer un texte et obtenir le résultat dans le champ de saisie actuel. L'environnement de test principal est Ubuntu Desktop sur Wayland avec GNOME, mais l'architecture devrait rester suffisamment ouverte pour un soutien futur à d'autres environnements.
Myna est conçu pour la reconnaissance vocale locale. Après l'installation des modèles nécessaires, aucune connexion Internet n'est requise pour que la dictée fonctionne, le microphone ne doit être utilisé qu'après activation explicite par l'utilisateur, l'audio est traité en mémoire puis rejeté, et aucun enregistrement n'est envoyé à des services externes. La spécification du projet précise également que la solution doit éviter de conserver l'audio par défaut et ne doit pas basculer discrètement vers un service cloud.
Le code et la documentation de Myna sont publiés dans le dépôt Canonical sur GitHub. Le projet est décrit comme une application légère de conversion de la parole en texte pour Ubuntu Desktop et est distribué sous la licence GPL-3.0. Cependant, le projet est encore à un stade précoce : aucune version publiée n'est encore disponible dans le dépôt, et la spécification architecturale a le statut Proposed.
Fonctionnalités principales et caractéristiques de Myna
Dictée Push-to-talk. L'utilisateur maintient une touche de raccourci personnalisable, parle, et le système insère le texte reconnu dans le champ de saisie sélectionné. La dictée se termine à la libération de la touche.
Reconnaissance vocale locale. La reconnaissance est effectuée sur la machine de l'utilisateur via un cadre d'inférence local. Cela réduit la dépendance au cloud et permet de fonctionner hors ligne après l'installation des modèles.
Traitement audio privé. Le microphone s'active uniquement pendant la session de dictée de l'utilisateur. L'audio ne doit pas être enregistré sur le disque par défaut, un tampon limité en mémoire est utilisé et est vidé après la fin de la session.
Indicateur visuel d'activité. Pendant l'enregistrement et la transcription, l'utilisateur doit voir un indicateur d'état clair. La spécification mentionne des états tels que Enregistrement, Transcription, Finalisation et Erreur.
Insertion de texte uniquement stable. Dans la première mise en œuvre, les hypothèses intermédiaires de reconnaissance ne doivent pas être insérées directement dans l'application. Seul le texte final confirmé est envoyé dans le champ cible.
Post-traitement du texte. La transcription brute peut subir une normalisation, une ponctuation, une capitalisation, un formatage et une conversion des formes orales en formes écrites, par exemple « twenty two » → « 22 ».
Choix de la langue de dictée. Le système doit prendre en charge une langue de dictée personnalisable, par défaut en fonction de la langue de l'interface utilisateur, si un modèle approprié est disponible pour celle-ci.
Profils de qualité du modèle. La spécification prévoit différents profils de modèles : une option légère avec une consommation de ressources moindre, un profil équilibré par défaut et une option de haute qualité mais plus lourde.
Fonctionnement sécurisé avec le focus d'entrée. L'objectif d'insertion de texte est choisi au début de la session. Si le focus de la fenêtre change pendant la dictée, le système ne doit pas silencieusement envoyer le texte vers une autre application.
Blocage dans les champs protégés. La dictée doit être bloquée dans les champs de mot de passe, les fenêtres d'authentification et d'autres lieux protégés, si l'application ou la boîte à outils permet de le déterminer.
Intégration avec Wayland/GNOME. La première version est axée sur Wayland et GNOME. Pour l'insertion initiale de texte, IBus est envisagé, et dans le futur, un chemin Wayland plus natif à travers les protocoles input-method/text-input est prévu.
Paramètres utilisateur. Dans l'interface de paramètres prévue, il doit y avoir l'activation/désactivation de la STT, le choix du raccourci clavier, de la langue de dictée, du microphone, du profil de modèle, des options de post-traitement et de l'indicateur d'activité.
Lors de la première itération, les fonctions hors du projet incluent l'éveil par mot-clé, l'écoute constante en arrière-plan, la reconnaissance vocale dans le cloud, l'assistant vocal, les commandes vocales, le contrôle du bureau, la traduction de la parole, l'identification de l'interlocuteur, la détection automatique de la langue et l'historique des dictées. En d'autres termes, Canonical ne commence pas par un « assistant AI », mais par une fonctionnalité plus pragmatique : la saisie vocale locale dans les applications Ubuntu ordinaires.
Source : linux.org.ru
