

Après cinq mois de développement, la version 1.1 du projet IncidentRelay a été publiée. Ce projet développe un système ouvert pour l'organisation de gardes, le routage des alertes et la gestion des incidents, déployable sur un serveur propre (auto-hébergé). IncidentRelay 1.1 est marqué comme la première version stable (la branche 1.0 avait le statut bêta). Le projet est destiné aux équipes SRE, DevOps et infrastructures qui recherchent une alternative déployable localement aux services SaaS pour la gestion des gardes, l'application des politiques d'escalade et la réactivité face aux incidents. Le code du projet est écrit en Python et est distribué sous licence MIT.
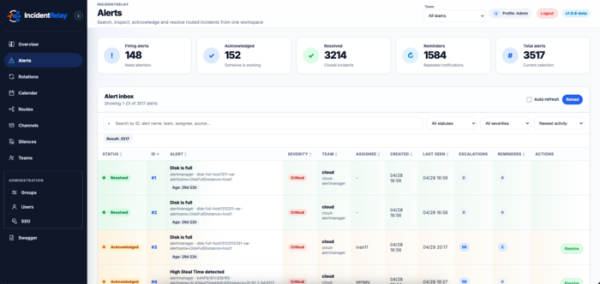
IncidentRelay reçoit des événements des systèmes de surveillance, les associe à un service, une équipe et une rotation, puis délivre des notifications aux gardes ou équipes responsables. Le système inclut des plannings de gardes, de rotations, des remplacements, la confirmation de réception d'incidents, les états ACK/Résoudre, des rappels, des escalades, des remplacements temporaires de gardes, la définition des moments de travaux planifiés et le filtrage des alertes bruyantes.
L'avantage principal du projet est le contrôle total sur l'infrastructure et la logique de routage. IncidentRelay s'installe dans son propre environnement, fonctionne avec sa propre base de données et permet de séparer clairement les chemins entrants, les équipes, les rotations et les canaux de livraison. Les jetons entrants appartiennent aux chemins et non aux canaux, ce qui facilite la compréhension de la source externe autorisée à envoyer des événements à une équipe spécifique.
IncidentRelay supporte la réception d'événements provenant de Prometheus Alertmanager, Grafana Alerting, Zabbix, Sentry, LibreNMS, RMON, AWS SNS/CloudWatch et de webhooks personnalisés. Pour les notifications, des canaux comme Mattermost, Slack, Telegram, Discord, Microsoft Teams, email, webhooks, et des notifications push browser/PWA sont prévus. Dans Mattermost et Telegram, les notifications peuvent contenir des actions pour confirmer et résoudre un problème, ce qui permet de traiter un incident sans avoir à passer par une interface séparée.
Le projet peut être lancé via Docker Compose, un package RPM pour les distributions de type Red Hat, manuellement via systemd, ainsi que dans Kubernetes à l'aide d'un chart Helm. Pour les petites installations, SQLite peut être utilisé, tandis que pour les systèmes de production et des charges plus élevées, PostgreSQL est recommandé.
La nouvelle version propose les changements suivants :
- Ajout de rotations d'astreinte hiérarchiques avec des restrictions de temps, des priorités de niveaux et une prise en compte des remplacements temporaires.
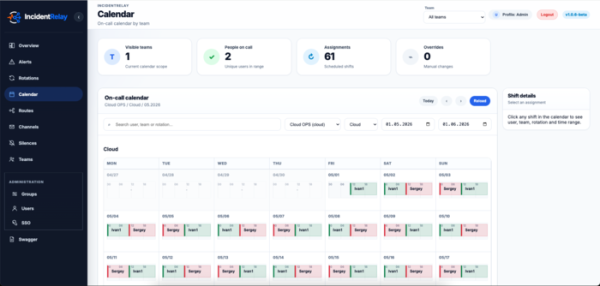
- Un calendrier d'astreinte est désormais disponible, avec des abonnements CalDAV et ICS pour des calendriers externes.
- Politiques d'escalade des incidents mises en œuvre avec des chaînes d'augmentation multi-étapes.
- Ajout de groupes d'alerte, de regroupement d'événements, de notifications différées et d'une fusion manuelle des alertes connexes.
- Des fenêtres pour la planification de travaux et des alertes 'silencieuses' sont disponibles.
- Ajout de la possibilité d'ajouter des commentaires aux alertes.
- Ajout de priorités d'incidents (P1-P5) et augmentation automatique de la priorité en fonction de l'importance.
- Catalogue de services, dépendances des services, SLI/SLO, historique d'impact sur les systèmes (Service Impact History) et services commerciaux (Business Services) mis en œuvre.
- Explain Trace pour analyser le routage : pourquoi une alerte a été incluse ou non dans l'équipe, a été regroupée, supprimée ou envoyée à un canal spécifique.
- Ajout de vérifications (Heartbeats/détecteur de mort) pour le watchdog, la sauvegarde, ETL et d'autres tâches où l'absence d'un signal attendu est problématique.
Source : opennet.ru
