

Dans le cadre du projet Qwenputer, les chercheurs ont préparé une version étendue du modèle AI Qwen3.5-4B, qui intègre un simulateur complet d'un CPU 32 bits basé sur l'architecture RISC-V (RV32IM), prenant en charge l'extension Zba et équipé d'un coprocesseur bignum pour les opérations arithmétiques sur de grands nombres. La mise en œuvre du cœur CPU est compilée en un ensemble de poids et intégrée dans un grand modèle linguistique sous la forme de 11 couches supplémentaires de transformateurs, ajoutées avant les couches principales de Qwen. Les calculs sont effectués directement pendant le passage avant (forward pass) du réseau neuronal, sans outils ou plugins externes.
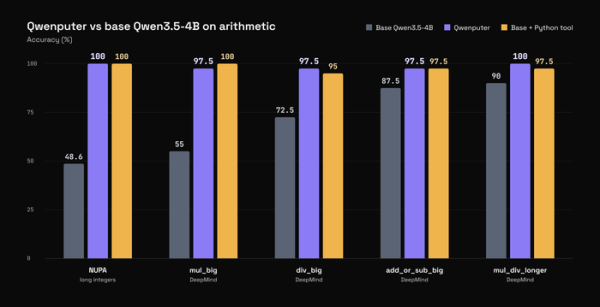
L'implémentation passe avec succès tous les tests du jeu officiel de tests riscv-tests et est capable d'exécuter du code compilé en C et MicroPython. Lors de l'exécution de calculs arithmétiques avec de grands nombres, Qwenputer assure une précision de 97,5 à 100 %, ce qui est comparable ou supérieur aux résultats du modèle de base Qwen3.5 avec un interpréteur Python externe connecté.
Pour simuler la mémoire vive dans le modèle, des couches séparées de Gated DeltaNet (RNN linéaires) sont utilisées, appliquées dans le modèle AI standard Qwen pour conserver un état modifié lors du traitement de grandes fenêtres contextuelles. En fixant l'état du frein et en appliquant un codage unitaire (one-hot), chaque demande d'écriture réécrit exactement une ligne de la matrice d'état, ce qui permet d'utiliser l'état DeltaNet comme une mémoire adressable de taille fixe, évitant la croissance linéaire du cache KV (Key-Value) avec l'augmentation de la longueur du contexte. Dans une telle mémoire, on place les registres du CPU, les données et le code machine exécuté.
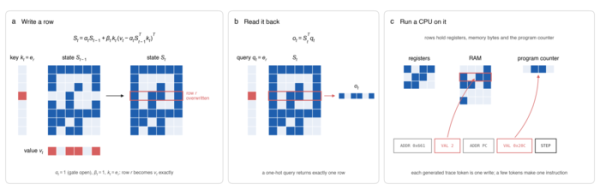
Les instructions du processeur, telles que la lecture des registres, les opérations arithmétiques et les sauts conditionnels, sont compilées directement dans les poids des couches de transformateur. Chaque instruction est associée à des tokens spéciaux (ADDR, VAL, STEP), que les couches du modèle AI interprètent comme la logique de fonctionnement du CPU. Pour initialiser le CPU et charger le firmware, un petit pilote externe RvChat est utilisé, mais le code machine est entièrement traité à l'intérieur des poids du modèle.
Parmi les limitations du projet, on mentionne une augmentation d'environ deux fois par rapport à la modèle original Qwen, atteignant 18,8 Go, tout en conservant les instantanés d'état (checkpoint), principalement en raison de l'ajout de couches supplémentaires. On note également une vitesse de calcul relativement faible (environ 3200 jetons par seconde sur le GPU L4), ce qui fait que des calculs complexes peuvent prendre des secondes au lieu de millisecondes.
Une variante expérimentale du modèle IA a également été mise en œuvre avec un système de fichiers, permettant de stocker jusqu'à 512 fichiers avec 53 000 jetons de texte à l'intérieur des poids du modèle IA. Comme dans la mise en œuvre de la mémoire vive, le stockage est organisé en fonction des états de DeltaNet, mais se distingue par le fait que le système de fichiers garantit un stockage permanent, sans perte d'état entre les sessions.
Les résultats de Qwenputer ont également servi de base à l'étude de nouvelles problématiques potentielles de sécurité en IA. À travers l'exemple de Qwenputer, il est démontré comment un modèle IA spécialement modifié peut dissimuler son raisonnement dans l'état RNN et contourner les mécanismes de surveillance du raisonnement du modèle (CoT, Chain-of-Thought). Également démontré
la possibilité de créer des mécanismes de contrôle et de surveillance de la sécurité, intégrés aux poids du modèle IA, que le modèle lui-même ne peut ni désactiver ni modifier.
Source : opennet.ru
