

Dans le cadre de l'activité professionnelle, les développeurs, les pentesters et les spécialistes en sécurité doivent faire face à des processus tels que la gestion des vulnérabilités (VM) et le SDLC sécurisé.
Ces termes recouvrent divers ensembles de pratiques et d'outils utilisés, qui sont entrelacés bien qu'ils soient destinés à des consommateurs différents.
Le progrès technique n'est pas encore parvenu au point de remplacer l'homme par un seul outil pour réaliser l'analyse de la sécurité de l'infrastructure et des logiciels.
Il est intéressant de comprendre pourquoi cela en est ainsi et quels problèmes se posent.
Processus
Le processus de gestion des vulnérabilités (« Vulnerability Management ») est conçu pour assurer une surveillance continue de la sécurité de l'infrastructure et la gestion des correctifs.
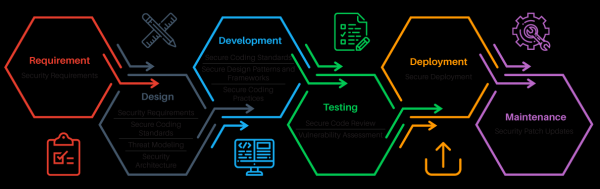
Le processus du SDLC sécurisé (« Secure SDLC ») a pour but de soutenir la sécurité de l'application tout au long de son développement et de son exploitation.
Une partie similaire de ces processus est le processus d'évaluation des vulnérabilités — l'analyse des vulnérabilités et le scan de celles-ci.
La principale différence dans la scan de la VM et du SDLC est que dans le premier cas, l'objectif est de découvrir les vulnérabilités connues dans les logiciels tiers ou dans la configuration. Par exemple, une version obsolète de Windows ou une chaîne communautaire par défaut pour SNMP.
Dans le second cas, l'objectif est de détecter des vulnérabilités non seulement dans les composants tiers (dépendances), mais surtout dans le code du nouveau produit.
Cela crée des différences dans les outils et les approches. À mon avis, la tâche de trouver de nouvelles vulnérabilités dans l'application est beaucoup plus intéressante, car elle ne se limite pas à l'analyse des versions, à la collecte de bannières, au craquage de mots de passe, etc.
Pour un scan automatisé des vulnérabilités des applications de qualité, des algorithmes tenant compte de la sémantique de l'application, de son objectif et des menaces spécifiques sont nécessaires.
Un scanner d'infrastructure peut souvent être remplacé par un chronomètre, comme l'a exprimé L'idée est que, statistiquement, vous pouvez considérer votre infrastructure comme vulnérable si vous ne l'avez pas mise à jour, disons, depuis un mois.
Outils
Le scan, tout comme l'analyse de sécurité, peut être effectué à la fois en boîte noire et en boîte blanche.
Black Box
Lors d'un scan en boîte noire, l'outil doit pouvoir interagir avec le service par les mêmes interfaces que celles utilisées par les utilisateurs.
Les scanners d'infrastructure (Tenable Nessus, Qualys, MaxPatrol, Rapid7 Nexpose, etc.) recherchent les ports réseau ouverts, collectent des « bannières », identifient les versions des logiciels installés et consultent leur base de données pour des informations sur les vulnérabilités de ces versions. Ils tentent également de détecter des erreurs de configuration, telles que des mots de passe par défaut ou un accès ouvert aux données, des algorithmes de chiffrement SSL faibles, etc.
Les scanners d'applications web (Acunetix WVS, Netsparker, Burp Suite, OWASP ZAP, etc.) peuvent également identifier des composants et leurs versions connus (par exemple, CMS, frameworks, bibliothèques JS). Les étapes principales d'un scanner sont le crawling et le fuzzing.
Au cours du crawling, le scanner collecte des informations sur les interfaces existantes de l'application et les paramètres HTTP. Pendant le fuzzing, des données mutées ou générées sont injectées dans tous les paramètres détectés afin de provoquer une erreur et de découvrir une vulnérabilité.
Ces types de scanners d'applications appartiennent aux classes DAST et IAST — respectivement Dynamic et Interactive Application Security Testing.
Boîte blanche
Dans le cadre du scanning en boîte blanche, il y a plus de différences.
Dans le cadre du processus VM, il est souvent donné aux scanners (Vulners, Incsecurity Couch, Vuls, Tenable Nessus, etc.) un accès aux systèmes, en réalisant un scan authentifié. Ainsi, le scanner peut extraire les versions de packages installés et les paramètres de configuration directement depuis le système, sans avoir à les deviner à partir des bannières des services réseau.
Le scan est plus précis et complet.
En ce qui concerne le scanning en boîte blanche (CheckMarx, HP Fortify, Coverity, RIPS, FindSecBugs, etc.) des applications, cela concerne généralement l'analyse statique du code et l'utilisation d'outils appropriés de la classe SAST — Static Application Security Testing.
Problèmes
Il y a de nombreux problèmes liés au scanning ! La plupart d'entre eux me confrontent personnellement dans le cadre des services de mise en place de processus de scanning et de développement sécurisé, ainsi que lors de l'analyse de la sécurité.
Je vais souligner 3 groupes principaux de problèmes, qui sont confirmés lors des discussions avec des ingénieurs et des responsables des services de sécurité dans diverses entreprises.
Problèmes de scanning des applications web
- Difficulté d'implémentation. Les scanners doivent être déployés, configurés et personnalisés pour chaque application, allouer un environnement de test pour les analyses et s'intégrer dans le processus CI/CD afin d'être efficaces. Sinon, cela deviendra une procédure formelle inutilisée, se traduisant par de faux positifs.
- Durée de l'analyse. Même en 2019, les scanners ont du mal avec la dé-duplication des interfaces et peuvent passer des jours à scanner mille pages avec dix paramètres chacune, les considérant comme différentes alors qu'elles sont gérées par le même code. Dans le même temps, la décision de déployer en production dans le cadre du cycle de développement doit être prise rapidement.
- Recommandations limitées. Les scanners fournissent des recommandations relativement générales, et il n'est pas toujours facile pour un développeur de comprendre rapidement comment réduire le niveau de risque, et surtout, s'il est nécessaire de le faire tout de suite ou si ce n'est pas urgent.
- Impact destructeur sur l'application. Les scanners peuvent conduire à des attaques par déni de service (DoS) sur l'application, ainsi qu'à la création d'un grand nombre d'entités ou à la modification de celles existantes (par exemple, créer des dizaines de milliers de commentaires sur un blog), donc il n'est pas judicieux de lancer une analyse en production sans réflexion.
- Faible qualité de détection des vulnérabilités. Les scanners utilisent généralement un ensemble fixe de charges utiles (« payloads ») et peuvent facilement passer à côté d'une vulnérabilité qui ne correspond pas à un scénario de comportement connu de l'application.
- Incompréhension des fonctionnalités de l'application par le scanner. Les scanners ne savent pas ce qu'est une « banque en ligne », un « paiement », un « commentaire ». Pour eux, il n'y a que des liens et des paramètres, donc une grande partie des vulnérabilités potentielles de la logique métier reste complètement non couverte, ils ne penseront pas à effectuer un double débit, à consulter des données d'autrui par ID, ou à manipuler le solde par un arrondi.
- Incompréhension de la sémantique des pages par le scanner. Les scanners ne savent pas lire les FAQ, ne reconnaissent pas les CAPTCHA, ils ne comprendront pas comment s'inscrire ni qu'il faut se reconnecter ensuite, qu'il ne faut pas cliquer sur « se déconnecter », et comment signer les requêtes lors de la modification des valeurs des paramètres. En conséquence, une grande partie de l'application pourrait rester complètement non analysée.
Problèmes d'analyse du code source.
- Faux positifs. L'analyse statique est une tâche complexe, qui nécessite de nombreux compromis. Il est souvent nécessaire de sacrifier la précision, et même les scanners d'entreprise coûteux produisent un grand nombre de fausses alertes.
- Difficulté d'implémentation. Pour améliorer la précision et l'exhaustivité de l'analyse statique, il est nécessaire de peaufiner les règles de scan, et rédiger ces règles peut s'avérer trop laborieux. Parfois, il est plus simple de trouver tous les endroits dans le code avec un bug et de les corriger plutôt que d'écrire une règle pour détecter de tels cas.
- Absence de support pour les dépendances. Les grands projets dépendent d'un grand nombre de bibliothèques et de frameworks qui étendent les capacités du langage de programmation. Si la base de connaissances du scanner ne contient pas d'informations sur les zones à risque (« sinks ») dans ces frameworks, cela deviendra un angle mort, et le scanner ne comprendra simplement pas le code.
- Durée de l'analyse. La recherche de vulnérabilités dans le code est une tâche complexe en termes d'algorithmes. Le processus peut donc s'étendre dans le temps et nécessiter des ressources informatiques considérables.
- Couverture faible. Malgré la consommation de ressources et la durée du scan, les développeurs d'outils SAST doivent toujours faire des compromis et n'analysent pas tous les états dans lesquels un programme peut se trouver.
- Reproductibilité des découvertes. Indiquer une ligne spécifique et une trace de la pile qui mène à une vulnérabilité est excellent, mais en réalité, le scanner ne fournit souvent pas suffisamment d'informations pour vérifier la présence d'une vulnérabilité de l'extérieur. En effet, la lacune peut se trouver dans un code mort, qui est inaccessible pour un attaquant.
Problèmes de scan d'infrastructure.
- Inventaire insuffisant. Dans de grandes infrastructures, en particulier celles qui sont géographiquement dispersées, il est souvent plus difficile de comprendre quels hôtes doivent être scannés. En d'autres termes, la tâche de scan est étroitement liée à la gestion des actifs.
- Mauvaise priorisation. Les scanners réseau produisent souvent de nombreux résultats avec des défauts qui, en pratique, ne sont pas exploitables, mais qui, sur le plan formel, présentent un risque élevé. Le consommateur reçoit un rapport qui est difficile à interpréter, et il n'est pas clair ce qui doit être corrigé en premier.
- Recommandations limitées. Dans la base de connaissances du scanner, on trouve souvent des informations très générales sur les vulnérabilités et leurs correctifs, si bien que les administrateurs doivent se tourner vers Google. La situation est un peu meilleure avec les scanners whitebox, qui peuvent fournir des commandes spécifiques pour corriger les problèmes.
- Travail manuel. Les infrastructures peuvent comporter de nombreux nœuds, et donc potentiellement de nombreuses vulnérabilités, dont les rapports doivent être examinés et analysés manuellement à chaque itération.
- Mauvaise couverture. La qualité du scan de l'infrastructure dépend directement de l'étendue de la base de connaissances sur les vulnérabilités et les versions des logiciels. Cependant, , même pour les leaders du marché, la base de connaissances n'est pas exhaustive, et les bases de solutions gratuites contiennent de nombreuses informations qui manquent aux leaders.
- Problèmes de patching. Le plus souvent, le patching des vulnérabilités dans l'infrastructure consiste à mettre à jour un package ou à modifier un fichier de configuration. Le gros problème ici est que le système, en particulier les systèmes hérités, peut se comporter de manière imprévisible suite à une mise à jour. En fait, il faudra réaliser des tests d'intégration sur l'infrastructure en production.
Approches
Que faire ?
Je détaillerai les exemples et comment aborder bon nombre des problèmes mentionnés dans les prochaines parties, mais pour l'instant, je vais indiquer les principales orientations à explorer :
- Agrégation de divers outils de scan. En utilisant correctement plusieurs scanners, on peut considérablement accroître la base de connaissances et la qualité des détections. Il est même possible de découvrir plus de vulnérabilités que la somme de toutes celles détectées individuellement, tout en évaluant plus précisément le niveau de risque et en fournissant davantage de recommandations.
- Intégration SAST et DAST. Il est possible d'augmenter la couverture DAST et la précision SAST grâce à l'échange d'informations entre eux. Les sources peuvent fournir des informations sur les routes existantes, et DAST peut vérifier si la vulnérabilité est visible de l'extérieur.
- Apprentissage automatique™. En 2015, j'ai (et ) parlé de l'application de la statistique pour donner aux scanners l'intuition d'un hacker et les accélérer. Cela constitue certainement une base pour le développement de l'analyse automatique de la sécurité à l'avenir.
- Intégration IAST avec des tests automatiques et OpenAPI. Dans le cadre d'un pipeline CI/CD, il est possible de créer un processus de scan basé sur des outils fonctionnant comme un proxy HTTP et des tests fonctionnels fonctionnant sur HTTP. Les tests et les contrats OpenAPI/Swagger fourniront au scanner l'information manquante sur les flux de données, permettant ainsi de scanner l'application dans différents états.
- Configuration correcte. Un profil de scan adapté à chaque application et infrastructure doit être créé, prenant en compte le nombre et la nature des interfaces ainsi que les technologies utilisées.
- Personnalisation des scanners. Souvent, une application ne peut pas être scannée sans modification du scanner. Par exemple, une passerelle de paiement où chaque requête doit être signée. Sans l'écriture d'un connecteur pour le protocole de la passerelle, les scanners enverront aveuglément des requêtes avec une signature incorrecte. Il est également nécessaire d'écrire des scanners spécialisés pour des types spécifiques de vulnérabilités, telles que
- Gestion des risques. L'utilisation de différents scanners et l'intégration avec des systèmes externes, tels que la gestion des actifs et la gestion des menaces, permettront d'utiliser de nombreux paramètres pour évaluer le niveau de risque, offrant ainsi à la direction une vue adéquate sur l'état actuel de la sécurité du développement ou de l'infrastructure.
Restez à l'écoute et disruptons le scan de vulnérabilités !
Source : habr.com
