

Salut, Habr !
À l'automne dernier, un concours de classification des dessins à la main Quick Draw Doodle Recognition a eu lieu sur Kaggle, où, entre autres, une équipe de R-istes a participé, composée de , et . Nous n'allons pas décrire le concours en détail, cela a déjà été fait dans .
Cette fois, pas de médailles, mais de nombreuses expériences précieuses ont été acquises, donc nous aimerions partager avec la communauté quelques-uns des sujets les plus intéressants et utiles sur Kaggle et dans le travail quotidien. Parmi les sujets abordés : la vie difficile sans OpenCV, le parsing de JSON (ces exemples examinent l'intégration de code C++ dans des scripts ou des packages R via Rcpp), la paramétrisation des scripts et la dockerisation de la solution finale. Tout le code de ce message est disponible dans un format exécutable dans .
Contenu :
1. Chargement efficace des données CSV dans la base MonetDB
Les données de ce concours ne sont pas fournies sous forme d'images prêtes à l'emploi, mais sous la forme de 340 fichiers CSV (un fichier par classe), contenant des JSON avec les coordonnées des points. En reliant ces points par des lignes, nous obtenons l'image finale de 256x256 pixels. Pour chaque enregistrement, une étiquette indique si l'image a été correctement reconnue par le classifier utilisé au moment de la collecte du dataset, un code pays à deux lettres où réside l'auteur du dessin, un identifiant unique, un timestamp et le nom de la classe, correspondant au nom du fichier. La version simplifiée des données pèse 7,4 Go en archive et environ 20 Go après décompression, tandis que les données complètes après décompression occupent 240 Go. Les organisateurs ont garanti que les deux versions reproduisent les mêmes dessins, c'est-à-dire que la version complète est redondante. Quoi qu'il en soit, conserver 50 millions d'images dans des fichiers graphiques ou sous forme de tableaux a immédiatement été jugé non rentable, et nous avons décidé de fusionner tous les fichiers CSV de l'archive train_simplified.zip dans une base de données avec génération ultérieure des images de la taille requise 'à la volée' pour chaque lot.
La base de données choisie est la réputée MonetDB, notamment la réalisation pour R sous forme de package . Le package inclut une version embarquée du serveur de base de données et permet de lancer le serveur directement depuis une session R et d'y travailler. La création de la base de données et la connexion à celle-ci se font en une seule commande :
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Nous aurons besoin de créer deux tables : une pour toutes les données, l'autre pour les informations de service sur les fichiers téléchargés (utile en cas de problème pour reprendre le processus après avoir téléchargé plusieurs fichiers) :
Création des tables
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
La méthode la plus rapide pour charger les données dans la base de données s'est révélée être la copie directe des fichiers CSV à l'aide de SQL — la commande COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT, où nom_de_table — le nom de la table et chemin — le chemin vers le fichier. Lors de l'utilisation de l'archive, nous avons constaté que l'implémentation intégrée unzip en R ne fonctionne pas correctement avec certains fichiers de l'archive, c'est pourquoi nous avons utilisé l'outil système unzip (en utilisant le paramètre getOption("unzip")).
La fonction pour enregistrer dans la base de données
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
Dans le cas où il est nécessaire de transformer la table avant de l'enregistrer dans la base de données, il suffit de passer en argument preprocess la fonction qui transformera les données.
Le code pour le chargement séquentiel des données dans la base :
Enregistrement des données dans la base
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
Le temps de chargement des données peut varier en fonction des caractéristiques de vitesse du stockage utilisé. Dans notre cas, la lecture et l'écriture d'un SSD à un autre ou d'une clé USB (fichier source) vers un SSD (base de données) prennent moins de 10 minutes.
Quelques secondes supplémentaires sont nécessaires pour créer une colonne avec une étiquette de classe entière et une colonne d'index (ORDERED INDEX) avec les numéros de ligne, qui sera utilisé pour l'échantillonnage des observations lors de la création de lots :
Création de colonnes supplémentaires et d'un index
message("Générer des étiquettes")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Générer des numéros de ligne")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
Pour résoudre le problème de la formation de lots « à la volée », nous devions atteindre une vitesse maximale d'extraction de lignes aléatoires à partir de la table. doodles. Pour cela, nous avons utilisé trois astuces. La première consistait à réduire la dimension du type dans lequel l'ID d'observation est stocké. Dans le jeu de données d'origine, le type requis pour stocker l'ID est bigint, mais le nombre d'observations permet d'adapter leurs identifiants, équivalents à leur numéro d'ordre, à un type int. La recherche s'effectue alors beaucoup plus rapidement. La deuxième astuce était l'utilisation de ORDERED INDEX — cette solution a été trouvée empiriquement, en examinant toutes les options disponibles. . La troisième consistait à utiliser des requêtes paramétrées. Le principe de la méthode repose sur l'exécution unique de la commande PREPARE suivie de l'utilisation de l'instruction préparée pour créer un ensemble de requêtes similaires, mais en pratique, le gain obtenu par rapport à une simple requête SELECT s'est avéré dans la plage de l'erreur statistique.
Le processus de chargement des données consomme pas plus de 450 Mo de RAM. Cela signifie que l'approche décrite permet de traiter des ensembles de données pesant plusieurs dizaines de gigaoctets sur presque n'importe quel matériel bon marché, y compris certaines cartes à un seul processeur, ce qui est assez impressionnant.
Il reste à mesurer la vitesse d'extraction des données (aléatoires) et à évaluer l'évolutivité lors de la sélection de lots de tailles différentes :
Benchmark de la base de données
library(ggplot2)

set.seed(0)
# Connexion à la base de données
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Fonction pour préparer la requête côté serveur
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Fonction pour extraire les données
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Exécution de la mesure
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Paramètres de benchmark
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("temps médian, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 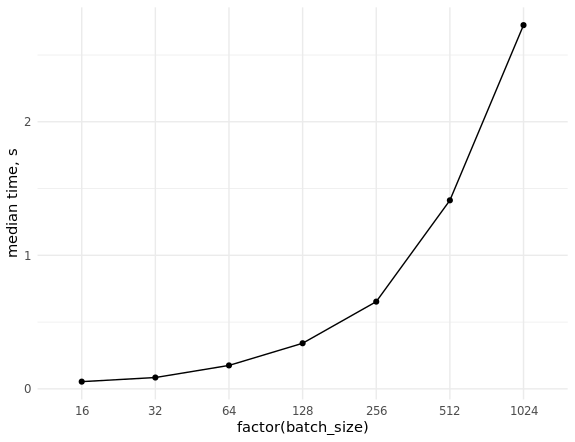
2. Préparation des lots
Le processus de préparation des lots se compose des étapes suivantes :
- Analyse de plusieurs fichiers JSON contenant des vecteurs de chaînes avec les coordonnées des points.
- Dessiner des lignes colorées selon les coordonnées des points sur une image de taille appropriée (par exemple, 256×256 ou 128×128).
- Transformation des images obtenues en tenseur.
Dans le cadre de la compétition parmi les noyaux en Python, la tâche a été principalement résolue à l'aide de OpenCV. Un des équivalents les plus simples et évidents en R serait le suivant :
Mise en œuvre de la transformation JSON en tenseur en R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # Analyse de JSON
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Supprimer le fichier temporaire à la fin de la fonction
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Graphique vide
  plot.new()
  # Taille de la fenêtre de graphique
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Couleurs des lignes
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Conversion de l'image en un tableau à 3 dimensions
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Fusion des tableaux d'images à 3 dimensions en un tableau à 4 dimensions dans un tenseur
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
Le dessin est effectué à l'aide des outils standard de R tout en sauvegardant dans un PNG temporaire, qui est stocké en mémoire (sur Linux, les répertoires temporaires de R se trouvent dans le répertoire /tmp, monté en mémoire). Ensuite, ce fichier est lu sous forme de tableau à trois dimensions avec des nombres allant de 0 à 1. Cela est important car un BMP plus courant aurait été lu dans un tableau brut avec des codes hexadécimaux de couleurs.
Testons le résultat :
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 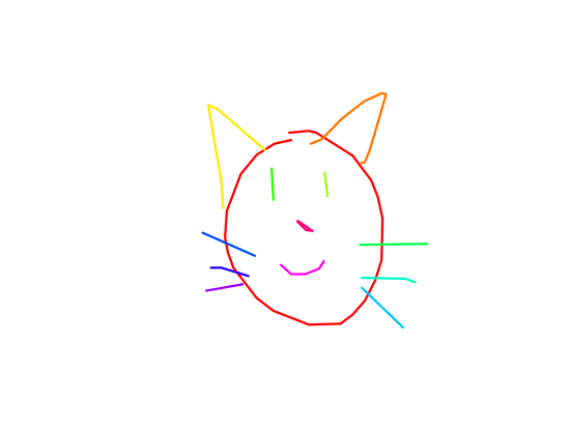
Le lot sera formé de la manière suivante :
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
Cette implémentation nous a semblé peu optimale, car la création de gros lots prend un temps excessif, et nous avons décidé de tirer parti de l'expérience de nos collègues en utilisant une bibliothèque puissante OpenCV. À l'époque, il n'existait pas de paquet prêt à l'emploi pour R (et il n'en existe toujours pas), donc une implémentation minimale de la fonctionnalité requise a été écrite en C++ avec intégration dans le code R via Rcpp.
Pour résoudre le problème, les paquets et bibliothèques suivants ont été utilisés :
OpenCV pour travailler avec des images et dessiner des lignes. Nous avons utilisé des bibliothèques et fichiers d'en-tête système préinstallés, ainsi qu'un lien dynamique.
xtensor pour le travail avec des tableaux multidimensionnels et des tenseurs. Nous avons utilisé des fichiers d'en-tête inclus dans le package R éponyme. La bibliothèque permet de travailler avec des tableaux multidimensionnels, que ce soit en ordre ligne ou en ordre colonne.
ndjson pour l'analyse JSON. Cette bibliothèque est utilisée dans xtensor automatiquement lorsqu'elle est présente dans le projet.
RcppThread pour organiser le traitement multithread d'un vecteur à partir de JSON. Nous avons utilisé les fichiers d'en-tête fournis par ce package. De plus, le plus populaire RcppParallel le package se distingue, entre autres, par son mécanisme intégré d'interruption de boucle.
Il convient de noter que xtensor s'est avéré être une véritable aubaine : en plus de posséder une vaste gamme de fonctionnalités et une haute performance, ses développeurs se sont montrés très réactifs et ont répondu rapidement et en détail aux questions posées. Grâce à eux, il a été possible de réaliser des transformations de matrices OpenCV en tenseurs xtensor, ainsi que de combiner des tenseurs d'images 3D en un tenseur 4D de bonne dimension (en réalité un lot).
Matériaux pour étudier Rcpp, xtensor et RcppThread
Pour compiler des fichiers utilisant des fichiers système et un lien dynamique avec des bibliothèques installées sur le système, nous avons utilisé le mécanisme de plugins réalisé dans le package Rcpp. Pour la recherche automatique des chemins et des drapeaux, nous avons utilisé l'outil populaire linux pkg-config.
Implémentation d'un plugin Rcpp pour utiliser la bibliothèque OpenCV
Rcpp::registerPlugin("opencv", function() {
  # Noms possibles du package
  pkg_config_name <- c("opencv", "opencv4")
  # Fichier binaire de l'outil pkg-config
  pkg_config_bin <- Sys.which("pkg-config")
  # Vérification de la disponibilité de l'outil dans le système
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Vérification de l'existence du fichier de configuration OpenCV pour pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("Configuration OpenCV pour le pkg-config non trouvée", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
En conséquence du travail du plugin, les valeurs suivantes seront fournies lors de la compilation :
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
Le code d'implémentation du parsing JSON et de la formation d'un batch pour transmission au modèle est indiqué sous spoiler. Ajoutons d'abord le répertoire local du projet pour la recherche des fichiers d'en-tête (nécessaire pour ndjson) :
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Implémentation de la conversion JSON en tenseur en C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Ce code doit être placé dans le fichier src/cv_xt.cpp et compilé avec la commande Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); il faudra également nlohmann/json.hpp de . Le code est divisé en plusieurs fonctions :
to_xt— fonction template pour convertir une matrice d'image (cv::Mat) en tenseurxt::xtensor;parse_json— fonction qui parse une chaîne JSON, extrait les coordonnées des points et les emballe dans un vecteur ;ocv_draw_lines— dessine des lignes de couleurs différentes à partir du vecteur de points obtenu ;process— combine les fonctions décrites ci-dessus et ajoute la possibilité de mettre à l'échelle l'image obtenue ;cpp_process_json_str— enveloppe la fonctionprocess, qui exporte le résultat dans un objet R (tableau multidimensionnel) ;cpp_process_json_vector— enveloppe la fonctioncpp_process_json_str, qui permet de traiter un vecteur de chaînes en mode multithreading.
Pour le dessin de lignes de couleurs différentes, un modèle de couleur HSV a été utilisé avec conversion ultérieure en RGB. Testons le résultat :
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 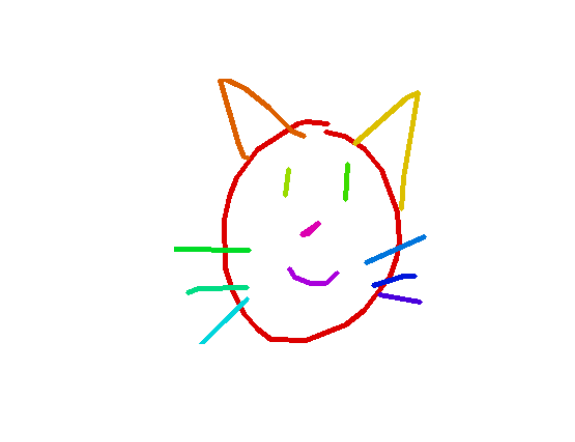
Comparaison de la vitesse d'exécution des implémentations en R et en C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Paramètres du banc d'essai
cols <- c("expression", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   expression                min     median       max `itr/sec` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Réalisation de la mesure
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expression   batch_size      min   median      max `itr/sec` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>        <bch:tm> <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("temps médian, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 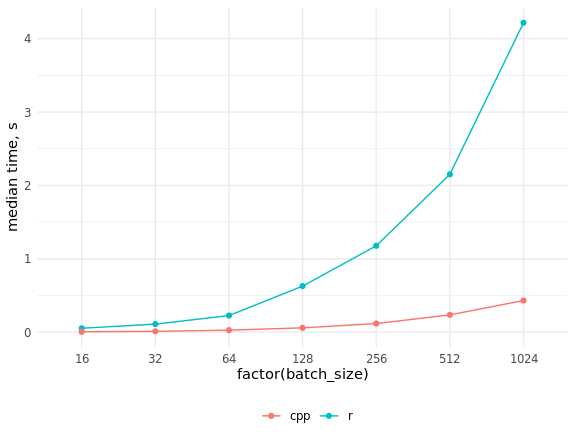
Comme nous le voyons, le gain de vitesse s'est avéré très significatif, et il ne semble pas possible de rattraper le code en C++ en parallélisant le code en R.
3. Itérateurs pour l'extraction de lots depuis la base de données
R a une réputation bien méritée en tant que langage pour le traitement des données qui tiennent en mémoire, tandis que Python est plus caractérisé par le traitement itératif des données, permettant de réaliser facilement et sans effort des calculs out-of-core (calculs utilisant une mémoire externe). Un exemple classique et pertinent pour notre tâche est celui des réseaux neuronaux profonds, formés par la méthode de la descente de gradient avec l'approximation du gradient à chaque étape sur une petite portion d'observations, ou mini-batch.
Les frameworks de deep learning écrits en Python ont des classes spéciales implémentant des itérateurs sur les données : tableaux, images dans des dossiers, formats binaires, etc. On peut utiliser des variantes prêtes à l'emploi ou écrire les siennes pour des tâches spécifiques. En R, nous avons accès à toutes les fonctionnalités de la bibliothèque Python keras avec ses différents backends grâce au package éponyme, qui fonctionne au-dessus du package reticulate. Ce dernier mérite un article long à lui seul ; il permet non seulement d'exécuter du code Python depuis R, mais facilite également le transfert d'objets entre les sessions R et Python, en exécutant automatiquement toutes les conversions de types nécessaires.
Nous avons éliminé la nécessité de stocker toutes les données en mémoire grâce à l'utilisation de MonetDBLite, tout le travail « neuronal » sera effectué par du code Python original, il ne nous reste qu'à écrire un itérateur pour les données, car il n'existe pas de solution prête à l'emploi pour ce cas tant en R qu'en Python. Les exigences à cet égard sont essentiellement deux : il doit renvoyer des batches en boucle infinie et conserver son état entre les itérations (la dernière étant réalisée de la manière la plus simple en R à l'aide de fermetures). Auparavant, il fallait explicitement convertir les tableaux R en tableaux numpy à l'intérieur de l'itérateur, mais la version actuelle du package keras le fait automatiquement.
L'itérateur pour les données d'entraînement et de validation est le suivant :
Itérateur pour les données d'entraînement et de validation
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
La fonction prend en entrée une variable de connexion à la base de données, les numéros des lignes utilisées, le nombre de classes, la taille du batch, l'échelle (scale = 1 correspond à l'affichage d'images de 256x256 pixels, scale = 0.5 — 128x128 pixels), un indicateur de coloris (color = FALSE indique un affichage en niveaux de gris, lors de l'utilisation couleur = TRUE chaque trait est dessiné avec une nouvelle couleur) et un indicateur de prétraitement pour les réseaux pré-entraînés sur imagenet. Ce dernier est nécessaire pour ajuster les valeurs des pixels de l'intervalle [0, 1] à l'intervalle [-1, 1], qui a été utilisé lors de l'entraînement des modèles fournis. keras modèles.
La fonction externe contient une vérification des types d'arguments, une table data.table avec des numéros de ligne mélangés aléatoirement provenant de samples_index et des numéros de lots, un compteur et un nombre maximal de lots, ainsi qu'une expression SQL pour extraire des données de la base de données. De plus, nous avons défini une version rapide de la fonction keras::to_categorical(). Nous avons utilisé presque toutes les données pour l'entraînement, en laissant un demi-pour cent pour la validation, donc la taille de l'époque était limitée par le paramètre steps_per_epoch lors de l'appel keras::fit_generator(), et la condition if (i > max_i) ne se déclenchait que pour l'itérateur de validation.
Dans la fonction interne, un échantillonnage des indices de lignes pour le lot suivant a lieu, extraction des enregistrements de la base de données avec une augmentation du compteur de lots, parsing des JSON (la fonction cpp_process_json_vector(), écrite en C++) et création des tableaux correspondants aux images. Ensuite, des vecteurs one-hot avec des étiquettes de classe, des tableaux de valeurs de pixels et des étiquettes sont combinés dans une liste, qui est la valeur de retour. Pour accélérer le processus, des index ont été créés dans les tables data.table et une modification par référence — sans ces « astuces » du paquet, data.table il est assez difficile d'imaginer un travail efficace avec des volumes de données significatifs dans R.
Les résultats des mesures de la vitesse de traitement sur un Core i5 d'ordinateur portable sont les suivants :
Benchmark de l'itérateur
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Indices pour l'ensemble d'entraînement
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Indices pour l'ensemble de validation
val_ind <- ind[-train_ind]
rm(ind)
# Coefficient d'échelle
scale <- 0.5

# Réalisation des mesures
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Paramètres du benchmark
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("temps médian, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 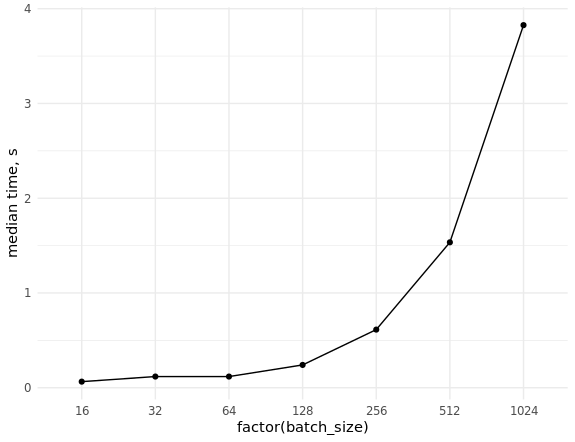
Si vous avez suffisamment de RAM, vous pouvez accélérer considérablement le fonctionnement de la base de données en la chargeant dans cette RAM (32 Go suffisent pour notre tâche). Sous Linux, une partition est montée par défaut, /dev/shm, occupant jusqu'à la moitié de la mémoire vive. Vous pouvez allouer plus d'espace en modifiant /etc/fstab, de sorte à obtenir un enregistrement de type tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Il est impératif de redémarrer et de vérifier le résultat en exécutant la commande df -h.
L'itérateur pour les données de test est beaucoup plus simple, car l'ensemble de données de test tient entièrement dans la RAM :
Itérateur pour les données de test
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Choix de l'architecture du modèle
La première architecture utilisée a été , dont les caractéristiques sont examinées dans le message. Elle est incluse dans la distribution standard keras et est donc disponible dans le paquet homonyme pour R. Mais en tentant de l'utiliser avec des images en niveaux de gris, il s'est avéré étrange que le tenseur d'entrée doit toujours avoir la dimension (batch, height, width, 3), c'est-à-dire que le nombre de canaux ne peut pas être changé. En Python, il n'y a pas de telle restriction, donc nous avons été rapides et avons écrit notre propre implémentation de cette architecture, en suivant l'article original (sans dropout, qui figure dans la version Keras) :
Architecture mobilenet v1
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Les inconvénients de cette approche sont évidents. Nous souhaitons tester de nombreux modèles, mais nous ne voulons pas réécrire manuellement chaque architecture. Nous avons également été privés de la possibilité d'utiliser les poids des modèles pré-entraînés sur Imagenet. Comme d'habitude, consulter la documentation a aidé. La fonction get_config() permet d'obtenir la description du modèle dans un format éditable (base_model_conf$layers — une liste classique en R), et la fonction from_config() effectue la transformation inverse en un objet modèle :
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Il est maintenant facile d'écrire une fonction universelle pour obtenir n'importe quel modèle fourni avec des poids entraînés sur Imagenet ou sans eux : keras Fonction pour charger des architectures prêtes à l'emploi
get_model <- function(name = "mobilenet_v2", input_shape = NULL, weights = "imagenet", pooling = "avg", num_classes = NULL, optimizer = keras::optimizer_adam(lr = 0.002), loss = "categorical_crossentropy", metrics = NULL, color = TRUE, compile = FALSE) { # Vérification des arguments checkmate::assert_string(name) checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3) checkmate::assert_count(num_classes) checkmate::assert_flag(color) checkmate::assert_flag(compile)# On obtient l'objet depuis le paquet keras model_fun <- get0(paste0("application_", name), envir = asNamespace("keras")) # Vérification de l'existence de l'objet dans le paquet if (is.null(model_fun)) { stop("Modèle ", shQuote(name), " non trouvé.", call. = FALSE) }base_model <- model_fun( input_shape = input_shape, include_top = FALSE, weights = weights, pooling = pooling )# Si l'image n'est pas en couleur, on change la dimension d'entrée if (!color) { base_model_conf <- keras::get_config(base_model) base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L base_model <- keras::from_config(base_model_conf) }predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax") model <- keras::keras_model( inputs = base_model$input, outputs = predictions )if (compile) { keras::compile( object = model, optimizer = optimizer, loss = loss, metrics = metrics ) }return(model) }
Lors de l'utilisation d'images à un seul canal, les poids pré-entraînés ne sont pas utilisés. Cela pourrait être corrigé : en utilisant la fonctionget_weights() pour obtenir les poids du modèle sous forme de liste de tableaux R, modifier la dimension du premier élément de cette liste (en prenant un canal de couleur ou en moyennant les trois), puis recharger les poids dans le modèle via la fonction set_weights() . Nous n'avons pas ajouté cette fonctionnalité, car il était déjà clair à ce stade qu'il était plus productif de travailler avec des images en couleur.. Nous n'avons pas ajouté cette fonctionnalité, car à ce stade, il était déjà clair qu'il était plus efficace de travailler avec des images en couleur.
La majorité des expériences ont été réalisées en utilisant mobilenet versions 1 et 2, ainsi que resnet34. Dans cette compétition, des architectures plus modernes telles que SE-ResNeXt ont bien performé. Malheureusement, nous n'avions pas de mises en œuvre prêtes à l'emploi et nous n'en avons pas écrites nous-mêmes (mais nous le ferons certainement).
5. Paramétrisation des scripts
Pour plus de commodité, tout le code pour lancer l'apprentissage a été présenté sous la forme d'un script unique, paramétré à l'aide de comme suit :
doc <- '
Usage:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [options]

Options:
  -h --help                   Affiche ce message.
  -l --list-models            Liste les modèles disponibles.
  -m --model=          Nom du modèle de réseau de neurones [default: mobilenet_v2].
  -b --batch-size=      Taille du lot [default: 32].
  -s --scale-factor=   Facteur d'échelle [default: 0.5].
  -c --color                  Utiliser des lignes colorées [default: FALSE].
  -d --db-dir=          Chemin vers le répertoire de la base de données [default: Sys.getenv("db_dir")].
  -r --validate-ratio= Ratio d'échantillon de validation [default: 0.995].
  -n --n-gpu=         Nombre de GPU [default: 1].
'
args <- docopt::docopt(doc)
Package docopt représente une implémentation pour R. Grâce à cela, les scripts sont lancés par des commandes simples du type Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db ou ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, si le fichier train_nn.R est exécutable (cette commande lancera l'apprentissage du modèle resnet50 sur des images RGB de taille 128x128 pixels, la base de données doit être dans le dossier /home/andrey/doodle_db). Il est possible d'ajouter la vitesse d'apprentissage, le type d'optimiseur et d'autres paramètres configurables. Lors de la préparation de la publication, il a été constaté que l'architecture mobilenet_v2 de la version actuelle keras dans R utilise en raison de modifications non prises en compte dans le package R — nous attendons qu'ils corrigent cela.
Cette approche a permis d'accélérer considérablement les expériences avec différents modèles par rapport au lancement plus traditionnel de scripts dans RStudio (comme alternative possible, nous mentionnons le package ). Mais le principal avantage réside dans la capacité à gérer facilement le lancement de scripts dans Docker ou simplement sur un serveur, sans devoir installer RStudio.
6. Dockerisation des scripts
Nous avons utilisé Docker pour assurer la portabilité de l'environnement pour l'apprentissage des modèles entre les membres de l'équipe et pour un déploiement rapide dans le cloud. On peut commencer à découvrir cet outil relativement peu familier pour un programmeur R avec une série de publications ou d' .
Docker permet de créer des images personnalisées « à partir de zéro », ainsi que d'utiliser d'autres images comme base pour en créer de nouvelles. En analysant les options disponibles, nous avons conclu que l'installation des pilotes NVIDIA, de CUDA + cuDNN et des bibliothèques Python constituait une part importante de l'image, et avons décidé de prendre pour base l'image officielle tensorflow/tensorflow:1.12.0-gpu, en y ajoutant les packages R nécessaires.
Le fichier Docker final est le suivant :
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
Pour plus de commodité, les packages utilisés ont été extraits dans des variables ; la majeure partie des scripts écrits est copiée à l'intérieur des conteneurs lors de la construction. Nous avons également changé le shell en /bin/bash pour faciliter l'utilisation du contenu /etc/os-release. Cela a permis d'éviter de devoir spécifier la version du système d'exploitation dans le code.
De plus, un petit script bash a été écrit pour permettre de lancer le conteneur avec différentes commandes. Par exemple, cela peut inclure des scripts pour entraîner des réseaux de neurones, préalablement intégrés dans le conteneur, ou un shell pour le débogage et la surveillance du fonctionnement du conteneur :
Script pour lancer le conteneur
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Si ce script bash est exécuté sans paramètres, un script par défaut sera lancé à l'intérieur du conteneur. train_nn.R Si le premier argument positionnel est « bash », alors le conteneur démarrera en mode interactif avec un shell. Dans tous les autres cas, les valeurs des arguments positionnels sont substituées : CMD="Rscript /app/train_nn.R $@".
Il est à noter que les répertoires contenant les données sources et la base de données, ainsi que le répertoire pour sauvegarder les modèles entraînés, sont montés à l'intérieur du conteneur depuis le système hôte, ce qui permet d'accéder aux résultats des scripts sans manœuvres inutiles.
7. Utilisation de plusieurs GPU dans Google Cloud
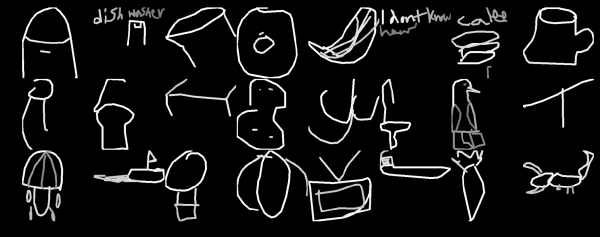
L'une des caractéristiques de la compétition était des données assez bruyantes (voir l'image en tête, empruntée à @Leigh.plt du Slack ODS). Pour y faire face, de grandes tailles de lot sont utiles, et après avoir expérimenté sur un PC avec un GPU, nous avons décidé de nous lancer dans l'entraînement de modèles sur plusieurs GPU dans le cloud. Nous avons utilisé GoogleCloud () en raison du large choix de configurations disponibles, de prix abordables et de $300 de bonus. Par avidité, une instance avec 4xV100 avec SSD et beaucoup de RAM a été commandée, et cela s'est avéré être une grande erreur. Une telle machine consomme rapidement de l'argent, et sans un pipeline éprouvé, on peut rapidement faire faillite lors des expérimentations. Pour des objectifs d'apprentissage, il vaut mieux opter pour une K80. Cependant, une grande quantité de RAM a été utile - le SSD cloud n'était pas très impressionnant en termes de rapidité, donc la base de données était transférée à chaque démarrage de l'instance sur dev/shm.
Le segment de code gérant l'utilisation de plusieurs GPU est particulièrement intéressants. D'abord, le modèle est créé sur CPU en utilisant un gestionnaire de contexte, tout comme en Python :
with(tensorflow::tf$device("/cpu:0"), {
  model_cpu <- get_model(
    name = model_name,
    input_shape = input_shape,
    weights = weights,
    metrics =(top_3_categorical_accuracy,
    compile = FALSE
  )
})
Ensuite, le modèle non compilé (ce qui est important) est copié sur le nombre spécifié de GPU disponibles, et ce n'est qu'après qu'il est compilé :
model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu)
keras::compile(
  object = model,
  optimizer = keras::optimizer_adam(lr = 0.0004),
  loss = "categorical_crossentropy",
  metrics = c(top_3_categorical_accuracy)
)
Il n'a pas été possible d'appliquer la technique classique consistant à geler tous les calques sauf le dernier, à entraîner le dernier calque, à déverrouiller et à réentraîner le modèle entier pour plusieurs GPU.
Nous avons surveillé l'entraînement sans utiliser tensorboard, en se limitant à l'enregistrement des journaux et à la sauvegarde des modèles avec des noms informatifs après chaque époque :
Callbacks
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. En guise de conclusion
Une série de problèmes auxquels nous avons été confrontés n'ont pas encore été résolus :
- dans keras il n'existe pas de fonction prête à l'emploi pour rechercher automatiquement le taux d'apprentissage optimal (l'analogue de
lr_finderdans la bibliothèque fast.ai); en faisant quelques efforts, il est possible de porter des implémentations tierces sur R, par exemple, ; - en conséquence du point précédent, il n'a pas été possible de trouver le bon taux d'apprentissage lors de l'utilisation de plusieurs GPU ;
- il manque des architectures de réseaux neuronaux modernes, en particulier les pré-entraînées sur imagenet ;
- il n'y a pas de politique one cycle et de taux d'apprentissage discriminants (le cosine annealing a été fait à notre demande, , merci ).
Ce que nous avons pu tirer de cette compétition :
- Sur du matériel relativement peu puissant, il est possible de travailler sans douleur avec des volumes de données décents (supérieurs de beaucoup à la taille de la RAM). Le package data.table économise de la mémoire grâce à la modification in-place des tableaux, ce qui permet d'éviter leur copie, et lorsqu'il est utilisé correctement, il démontre presque toujours la plus grande vitesse parmi tous les outils connus pour les langages de script. La sauvegarde des données dans une base de données permet dans de nombreux cas de ne pas penser à la nécessité de faire entrer l'ensemble du jeu de données dans la RAM.
- Les fonctions lentes en R peuvent être remplacées par des fonctions rapides en C++ à l'aide du package Rcpp. De plus, si l'on utilise RcppThread ou RcppParallel, nous obtenons des implémentations multiplates-formes multithread, donc le code au niveau R n'a pas besoin d'être parallélisé.
- Le package Rcpp peut être utilisé sans connaissances approfondies en C++, le minimum requis y est décrit . Les fichiers d'en-tête pour plusieurs bibliothèques C puissantes comme xtensor sont disponibles sur CRAN, ce qui signifie qu'une infrastructure se forme pour la réalisation de projets intégrant dans R du code hautes performances prêt à l'emploi en C++. Un confort supplémentaire est apporté par la coloration syntaxique et l'analyseur statique de code en C++ dans RStudio.
- docopt permet d'exécuter des scripts autonomes avec des paramètres. C'est pratique pour une utilisation sur un serveur distant, y compris sous Docker. Effectuer des expériences d'entraînement de réseaux neuronaux de plusieurs heures dans RStudio n'est pas pratique, et l'installation de l'IDE sur le serveur n'est pas toujours justifiée.
- Docker assure la portabilité du code et la reproductibilité des résultats entre développeurs avec différentes versions de systèmes d'exploitation et de bibliothèques, tout en facilitant son déploiement sur des serveurs. Il est possible de lancer l'ensemble du pipeline d'apprentissage avec une seule commande.
- Google Cloud est une façon économique d'expérimenter sur du matériel coûteux, mais il est nécessaire de choisir les configurations avec soin.
- Mesurer la vitesse d'exécution de différentes parties du code est très utile, en particulier lorsqu'on combine R et C++, et avec le paquet bench — c'est également très simple.
Dans l'ensemble, cette expérience a été très bénéfique, et nous continuons à travailler sur la résolution de certaines des problématiques évoquées.
Source : habr.com
