

Les algorithmes RAID ont été présentés au public en 1987. À ce jour, ils restent la technologie de protection et d'accélération d'accès aux données la plus demandée dans le domaine du stockage d'informations. Cependant, l'âge d'une technologie IT qui a franchi le cap des 30 ans n'est pas tant un signe de maturité, mais plutôt de vieillesse. Cela est dû au progrès, qui apporte sans cesse de nouvelles opportunités. À une époque où il n'existait pratiquement d'autres dispositifs de stockage que les HDD, les algorithmes RAID permettaient d'utiliser les ressources de stockage disponibles de la manière la plus efficace. Cependant, avec l'apparition des SSD, la situation a radicalement changé. Aujourd'hui, le RAID, lorsqu'il est utilisé avec des disques à état solide, devient une "étranglement" de leurs performances. Ainsi, pour libérer tout le potentiel de vitesse des SSD, un tout nouvel approche est nécessaire.
Outre les différences évidentes entre les HDD et les SSD en termes de fonctionnement, ces types de dispositifs de stockage ont une autre caractéristique importante : tout disque dur peut réécrire des données avec une granularité d'un bloc (ce qui est généralement 4 Ko). Pour les SSD, le processus de réécriture représente une procédure beaucoup plus complexe :
- Les données modifiées sont copiées à un nouvel emplacement. Ici, la granularité est le même bloc, mais composé de plusieurs pages et ayant une taille de 256 Ko à 4 Mo. C'est-à-dire que lorsque les mêmes 4 Ko sont modifiés, toutes les pages voisines qui forment un bloc doivent également être copiées.
- Les "anciens" blocs sont marqués comme non utilisés afin d'être ensuite supprimés par le collecteur de "déchets" (Garbage Collector).
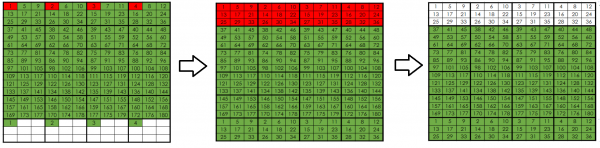
Écriture/réécriture séquentielle sur SSD
Dans le cas de l'écriture/réécriture séquentielle, cette particularité de fonctionnement des SSD n'a pas un impact significatif sur ses performances, car les blocs sont situés à proximité, et le collecteur de "déchets" gère assez bien son travail en arrière-plan. Mais dans la réalité, surtout dans le segment Enterprise, l'accès aléatoire aux données est le plus souvent utilisé pour les SSD, et ces données sont écrites à des emplacements arbitraires sur le disque.
Plus il y a de données écrites sur le SSD, plus il devient difficile pour le collecteur de 'déchets' de fonctionner, car la fragmentation augmente considérablement. Cela entraîne un moment où le processus de nettoyage du stockage cesse d'être 'en arrière-plan' : la performance du SSD chute significativement, car une partie notable est absorbée par le Garbage Collector.
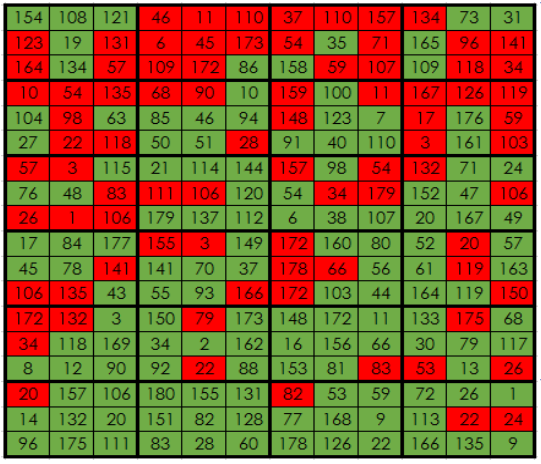
La véritable disposition des données sur le SSD lors d'une utilisation quotidienne
Pour illustrer l'effet de l'activité du collecteur de 'déchets' en fonction du mode d'écriture sur le stockage, on peut réaliser des tests simples : écriture séquentielle et aléatoire en blocs de 4 Ko sur un stockage de 100 Go. (Source – la société )
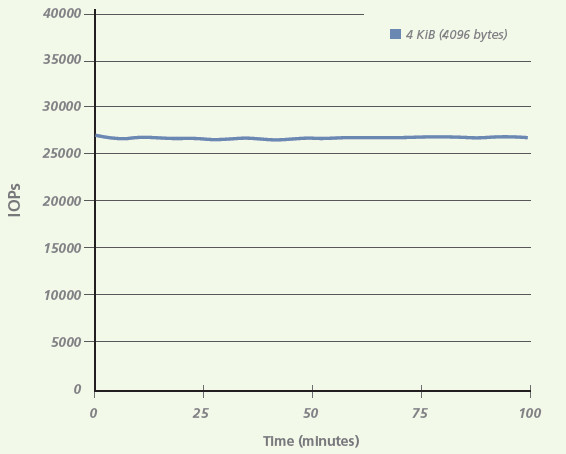
Performance lors de l'écriture séquentielle
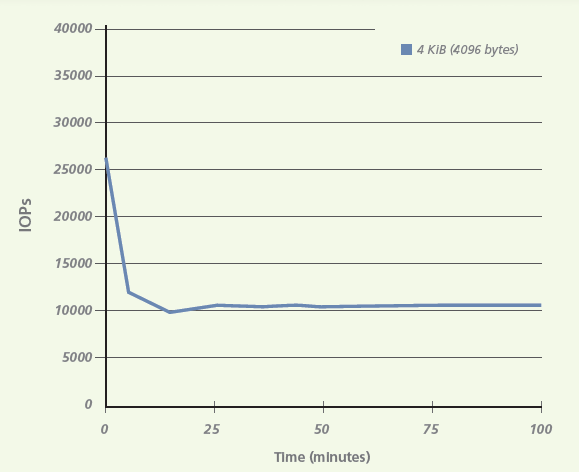
Performance lors de l'écriture aléatoire
Comme le montrent les tests, la baisse de performance peut atteindre plus du double. Et cela pour un seul stockage. En cas d'utilisation de SSD dans un groupe RAID, le nombre d'opérations de réécriture augmente considérablement grâce au traitement avec parité.
En général, grâce à ces particularités de fonctionnement des SSD, il existe un paramètre pour eux, appelé le coefficient d'écriture (write amplification). C'est le rapport entre le volume de données écrites sur le stockage et le volume de données réellement envoyées par l'hôte. Et pour le RAID5 le plus populaire, ce coefficient est d'environ ~3.5.
En fin de compte, les systèmes avec RAID classique ne tirent parti des SSD qu'à environ ~10% de leur vitesse réelle et évoluent peu en performance à mesure que le nombre de stockages dépasse une dizaine.
Notons également que les opérations d'écriture excessives non seulement diminuent la performance des SSD, mais réduisent également leur durée de vie, qui n'est pas infinie.
, qui constitue le cœur de tous les produits AccelStor, a été développée comme une alternative aux algorithmes RAID classiques pour le travail avec des SSD. L'innovation de cette technologie est reconnue par divers brevets et récompenses (notamment au Flash Memory Summit 2016), ainsi que par les résultats de tests indépendants (par exemple, SPC1).
Essence consiste à transformer toutes les demandes d'écriture entrantes, et principalement celles de type aléatoire, en un ensemble de blocs, aussi similaire que possible au mode d'écriture séquentielle du point de vue du support de stockage. En conséquence, l'écriture sur SSD se fait dans un mode qui leur est le plus confortable, et la performance finale dépasse celle de tous les systèmes avec un RAID classique.
Tous les SSD des systèmes AccelStor sont divisés en deux groupes symétriques FlexiRemap®. La taille du groupe dépend du modèle et varie de 5 à 11 disques. Pour la tolérance aux pannes à l'intérieur du groupe, un système de parité similaire au RAID5 est appliqué. Les deux groupes sont utilisés ensemble, formant un espace de stockage commun. Par conséquent, la tolérance aux pannes finale sera similaire à celle d'un ensemble RAID50 composé de deux groupes : le système peut supporter la panne de jusqu'à deux SSD, mais pas plus d'un dans chaque groupe FlexiRemap®.
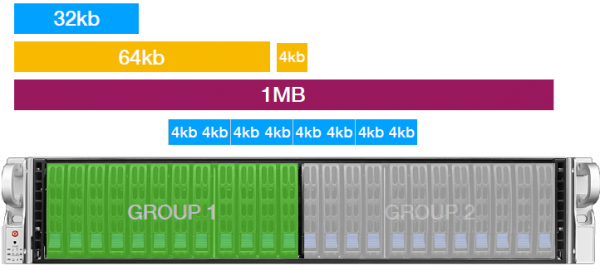
Toutes les demandes d'écriture entrantes sont fragmentées en blocs de 4 Ko, qui sont enregistrés en mode round robin sur les deux groupes FlexiRemap®. Parallèlement, le système tient toujours compte de la demande des blocs écrits, cherchant à enregistrer des blocs similaires les uns à côtés des autres lors des modifications. Cela crée un analogue virtuel au tiercing, en utilisant la terminologie des systèmes de stockage. Cela facilite considérablement le travail du collecteur de « déchets » : les blocs non utilisés seront toujours proches les uns des autres.
Il convient de noter que contrairement aux produits concurrents, n'utilisent pas la fonctionnalité de mise en cache des demandes entrantes dans la mémoire vive du contrôleur. Tous les blocs de données entrants sont immédiatement écrits sur le SSD. Le serveur reçoit la confirmation d'une écriture réussie uniquement après que les données aient été physiquement placées sur les disques. En RAM, ne sont stockées que les tables de placement des blocs sur le SSD pour accélérer l'accès et déterminer où écrire le prochain bloc de données. Bien sûr, pour la fiabilité, des copies de ces tables sont également situées sur les supports eux-mêmes. En conséquence, les systèmes AccelStor n'ont besoin d'aucune protection de cache sous forme de batterie/condenseur (bien que la possibilité de se connecter à un UPS existe – pour un arrêt « en douceur » en cas de problème d'alimentation).
Grâce à une telle approche dans l'organisation des enregistrements, le collecteur de « déchets » est réellement capable de fonctionner en arrière-plan, sans affecter de manière significative la vitesse des supports, ce qui permet d'utiliser jusqu'à 90 % de la performance des SSD au sein du système. C'est cela qui explique les performances élevées en IOPS des systèmes AccelStor par rapport à l'All Flash, basés sur des algorithmes RAID.
Une autre caractéristique importante de la technologie FlexiRemap® est la réduction significative des opérations d'écriture redondantes sur les SSD. Ainsi, le coefficient d'écriture (write amplification) pour les systèmes AccelStor est seulement de 1,3, ce qui, en d'autres termes, signifie une augmentation de la durée de vie des supports par rapport au RAID5 de plus de 2,5 fois !
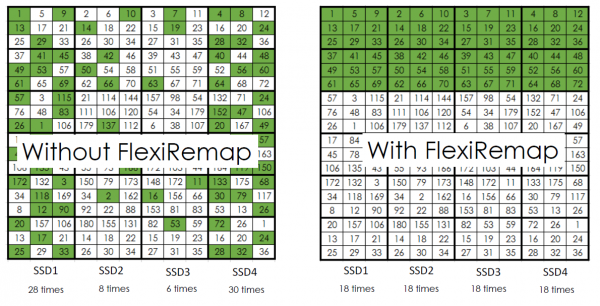
Grâce à la surveillance continue de la politique de placement des données sur les SSD par le système, tous les supports s'usent de manière uniforme. Cette approche permet de prévoir leur durée de vie et d'alerter l'administrateur lorsque la ressource d'écriture est épuisée.
Il est évident que les SSD peuvent tomber en panne. Dans ce cas, le système commencera immédiatement un rebuild sur l'un des disques de sauvegarde. Pendant ce temps, le groupe FlexiRemap®, en état dégradé, passe en mode « lecture seule », et toutes les demandes d'écriture sont dirigées vers le second groupe. Ce mécanisme de protection est prévu pour accélérer l'opération de rebuild et réduire la probabilité de défaillance d'un autre support au sein du même groupe. En effet, pendant le rebuild, tous les supports du groupe subissent une charge accrue à cause des interférences des opérations de lecture, d'écriture et de récupération sur le hot spare. Cela augmente ainsi le risque de défaillance d'un autre disque. Plus il y a d'opérations d'écriture, plus le rebuild prendra du temps.
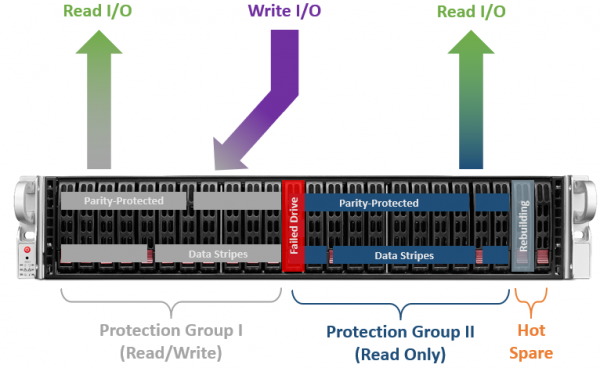
Après la fin du processus de récupération et le retour du groupe FlexiRemap® dans un état normal, il y aura un petit déséquilibre dans la ressource d'écriture entre les deux groupes. Par conséquent, pour le réajuster, les opérations d'écriture suivantes seront plus fréquentes sur le groupe restauré (bien sûr, en veillant à ce que la performance globale du système ne soit pas trop affectée).
Améliorer les performances des systèmes All Flash basés sur des algorithmes RAID au-delà de certaines valeurs (~280K IOPS@4K écrit aléatoire) n'est pas possible, même avec des systèmes de mise en cache complexes. La technologie FlexiRemap®, grâce à une approche entièrement différente de l'organisation de l'espace de stockage, ne se contente pas de franchir cette barrière, mais augmente également plusieurs fois la durée de vie des SSD. Ainsi, les systèmes ont des avantages significatifs par rapport aux matrices All Flash sur de nombreux aspects (IOPS/$, Go/$, TCO, ROI), les rendant idéaux pour des postes clés dans les centres de données des clients afin de résoudre des tâches gourmandes en ressources.
Source : habr.com
