

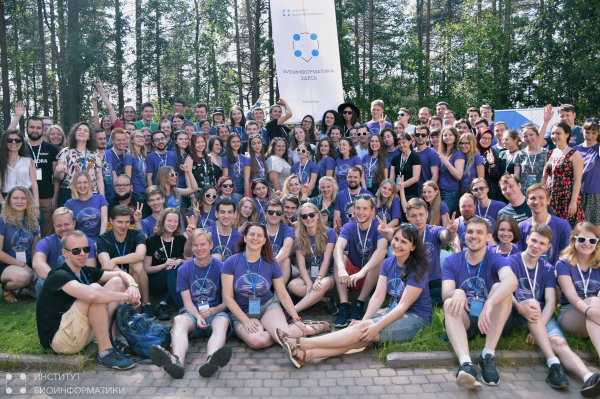
 En été 2018, une école d'été annuelle de bioinformatique s'est tenue près de Saint-Pétersbourg, réunissant 100 étudiants et doctorants pour explorer la bioinformatique et son application dans divers domaines de la biologie et de la médecine.
Le principal objectif de cette école était la recherche sur le cancer, mais des conférences sur d'autres domaines de la bioinformatique ont également eu lieu, allant de l'évolution à l'analyse des données de séquençage unicellulaire. Au cours de la semaine, les participants ont appris à travailler avec des données de séquençage de nouvelle génération, ont programmé en Python et en R, ont utilisé des outils et des cadres bioinformatiques standard, se sont familiarisés avec les méthodes de biologie systémique, de génétique des populations, et de modélisation des médicaments dans l'étude des tumeurs, et bien plus encore.
Vous trouverez ci-dessous les vidéos de 18 conférences données lors de l'école, accompagnées de descriptions et de diapositives. Celles marquées d'un astérisque « * » sont assez basiques et peuvent être regardées sans préparation préalable.
1*. Oncogénomique et oncologie personnalisée | Mikhaïl Pyatnitski, Institut de chimie biomédicale
|
Mikhaïl a brièvement parlé de la génomique des tumeurs et de la manière dont la compréhension de l'évolution des cellules cancéreuses permet de résoudre des problèmes pratiques en oncologie. Il a particulièrement souligné la différence entre oncogènes et oncogénérateurs, les méthodes de recherche des « gènes du cancer » et l'identification des sous-types moléculaires des tumeurs. En conclusion, Mikhaïl s'est attardé sur l'avenir de l'oncogénomique et sur les problèmes qui pourraient survenir.
2*. Diagnostic génétique des syndromes tumoraux héréditaires | Andreï Afanassiev, yRisk
|
Andreï a présenté les syndromes tumoraux héréditaires, en expliquant leur biologie, épidémiologie et manifestations cliniques. Une partie de la conférence était dédiée à la question du test génétique : qui doit le faire, comment cela se déroule, quelles sont les difficultés rencontrées lors de traitement des données et de l'interprétation des résultats, et enfin, quel bénéfice cela peut apporter aux patients et à leurs proches.
3*. Le Pan-Cancer Atlas | Hermann Demidov, BIST/UPF
|
Malgré des décennies de recherches en génomique et en épigénomique du cancer, la réponse à la question « comment, où et pourquoi surviennent les syndromes tumoraux » n’est toujours pas complète. L’une des raisons à cela est la nécessité d’une acquisition et d’un traitement standardisés d’un grand nombre de données pour détecter des effets de faible ampleur, difficiles à identifier dans un ensemble de données limité (qui est typiquement le cas dans une ou plusieurs laboratoires), mais qui, dans l’ensemble, jouent un rôle énorme dans une maladie aussi complexe et multifactorielle que le cancer.
Au cours des dernières années, de nombreuses équipes de recherche de premier plan dans le monde ont, conscientes de ce problème, commencé à unir leurs efforts pour tenter de détecter et de décrire tous ces effets. Une de ces initiatives (The PanCancer Atlas) et les résultats obtenus dans le cadre de ce consortium de laboratoires, publiés dans un numéro spécial de Cell, ont été abordés par German lors de cette conférence.
4. ChIP-Seq dans l’étude des mécanismes épigénétiques | Oleg Shpynov, JetBrains Research
|
La régulation de l'expression des gènes se fait de plusieurs manières. Lors de sa conférence, Oleg a parlé de la régulation épigénétique par la modification des histones, de l’étude de ces processus par la méthode ChIP-seq et des moyens d'analyser les résultats obtenus.
5. Multiomique dans les recherches sur le cancer | Konstantin Okonchnikov, Centre allemand de recherche sur le cancer
|
Le développement des technologies expérimentales en biologie moléculaire a permis de combiner l’étude d’un large éventail de processus fonctionnels dans les cellules, les organes ou même l’organisme entier. Pour établir des liens entre les composants des processus biologiques, il est nécessaire d'utiliser la multiomique, qui combine des données expérimentales massives en génomique, transcriptomique, épigénomique et protéomique. Konstantin a donné des exemples concrets d'application de la multiomique dans le domaine de la recherche sur les maladies cancéreuses, en se concentrant sur l'oncologie pédiatrique.
6. La diversité et les limites de l'analyse des cellules uniques | Konstantin Okonchnikov
|
Une conférence plus détaillée sur le séquençage RNA de cellules uniques et les méthodes d'analyse de ces données, ainsi que sur les moyens de surmonter des problèmes évidents et cachés lors de leur étude.
7. Analyse des données single-cell RNA-seq | Konstantin Zaïtsev, Université de Washington à St.Louis
|
Cours introductif sur le séquençage des cellules uniques. Konstantin aborde les méthodes de séquençage, les difficultés rencontrées lors des étapes de travail en laboratoire et d'analyse bioinformatique, ainsi que les moyens de les surmonter.
8. Diagnostic de la dystrophie musculaire par séquençage à nanopores | Pavel Avdeev, Université George Washington
|
Le séquençage utilisant la technologie d'Oxford Nanopore offre des avantages qui peuvent être exploités pour identifier les causes génétiques des maladies, comme la dystrophie musculaire. Lors de sa conférence, Pavel a discuté du développement d'un pipeline pour le diagnostic de cette maladie.
9*. Représentation graphique du génome | Ilia Minkin, Université d'État de Pennsylvanie
|
Les modèles graphiques permettent de représenter de manière compacte un grand nombre de séquences similaires et sont souvent utilisés en génomique. Ilia a expliqué en détail comment les graphes sont utilisés pour reconstruire les séquences génomiques, pourquoi et comment le graphe de Bruijn est utilisé, dans quelle mesure cette approche 'graphique' augmente la précision de la recherche de mutations, et quels problèmes non résolus avec l'utilisation de graphes subsistent encore.
10*. Protéo-mique fascinante | Pavel Sinitsyn, Institut Max Planck de biochimie (2 parties)
, |,
Les protéines sont responsables de la plupart des processus biochimiques dans un organisme vivant, et la protéomique est pour l'instant la seule méthode permettant l'analyse globale de l'état de milliers de protéines simultanément. Le spectre des problèmes à résoudre est impressionnant, allant de l'identification des anticorps et des antigènes à la localisation de plusieurs milliers de protéines. Lors de ses conférences, Pavel a abordé ces applications et d'autres de la protéomique, son développement actuel et les écueils de l'analyse des données.
11*. Principes fondamentaux des simulations moléculaires | Pavel Iakovlev, BIOCAD
|
Cours théorique introductif sur la dynamique moléculaire : pourquoi elle est nécessaire, ce qu'elle fait et comment elle est utilisée dans le développement de médicaments. Pavel a abordé les méthodes de dynamique moléculaire, expliqué les forces moléculaires, décrit les liaisons, les concepts de 'champ de forces' et 'intégration', ainsi que les limites de la modélisation, et bien d'autres sujets.
12*. Biologie moléculaire et génétique | Youri Barbitov, Institut de bioinformatique
, , |
Introduction à la biologie moléculaire et à la génétique en trois parties pour les étudiants et diplômés des spécialités techniques. La première conférence aborde les concepts de la biologie moderne, les questions de la structure du génome et l'émergence des mutations. La deuxième traite en détail des fonctions des gènes, des processus de transcription et de traduction, la troisième — de la régulation de l'expression des gènes et des principales méthodes de biologie moléculaire.
13*. Principes d'analyse des données NGS | Youri Barbitov, Institut de bioinformatique
|
La conférence traite des méthodes de séquençage de deuxième génération (NGS), de leurs types et caractéristiques. L'intervenant explique en détail comment les données « à la sortie » du séquenceur sont structurées, comment elles sont transformées pour l'analyse et quelles sont les méthodes de travail avec ces données.
14*. Utilisation de la ligne de commande, pratique | Guennadi Zakharov, EPAM
Aperçu pratique des commandes utiles dans la ligne de commande Linux, des options et des bases de leur utilisation. Les exemples concernent l'analyse des séquences d'ADN séquencées. En plus des opérations standard de Linux (par exemple, cat, grep, sed, awk), des utilitaires pour travailler avec les séquences (samtools, bedtools) sont également examinés.
15*. Visualisation des données pour les plus petits | Nikita Alexeïev, Université ITMO
|
Il est arrivé à chacun d'illustrer les résultats de ses projets scientifiques ou d'étudier les diagrammes, graphiques et images des autres. Nikita a expliqué comment interpréter correctement les graphiques et les diagrammes, en mettant en avant l'essentiel; comment dessiner des images compréhensibles. L'intervenant a également souligné sur quoi se concentrer lors de la lecture d'un article ou du visionnage d'une publicité.
16*. Carrière en bioinformatique | Viktoria Korjova, Max Planck Institute of Biochemistry
Vidéo : , |
Viktoria a parlé de la structure de la science académique à l'étranger et de ce sur quoi il faut porter attention pour construire une carrière dans la science ou dans l'industrie en étant étudiant au niveau de la licence, du master ou du doctorat.
17*. Comment un chercheur doit rédiger un CV | Viktoria Korjova, Max Planck Institute of Biochemistry
Que garder dans un CV et que supprimer ? Quels faits intéressent le futur employeur, et quels éléments mieux vaut éviter ? Comment organiser l'information pour que votre CV attire l'attention ? La conférence répondra à ces questions et d'autres.
18*. Comment fonctionne le marché de la bioinformatique | Andrei Afanasev, yRisk
|
Comment est structuré le marché et où travailler en bioinformatique ? La réponse à cette question est détaillée, avec des exemples et des conseils, dans la conférence d'Andrei.
Fin
Comme vous l'avez peut-être remarqué, les conférences à l'école sont assez variées en termes de thèmes — de la modélisation moléculaire et de l'utilisation des graphes pour l'assemblage du génome, à l'analyse des cellules uniques et à la construction d'une carrière scientifique. Au sein de l'Institut de bioinformatique, nous nous efforçons d'inclure dans le programme de l'école divers sujets afin de couvrir autant de disciplines bioinformatiques que possible, et pour que chaque participant apprenne quelque chose de nouveau et d'utile.
La prochaine école de bioinformatique se déroulera du 29 juillet au 3 août 2019 près de Moscou. . Le thème de cette année sera la bioinformatique dans les recherches sur le développement (biologie du développement) et le vieillissement (aging).
Pour ceux qui souhaitent approfondir leurs connaissances en bioinformatique, nous continuons à accepter les candidatures pour notre à Saint-Pétersbourg. Ou suivez nos actualités concernant l'ouverture du programme à Moscou déjà cet automne.
Pour ceux qui ne sont pas à Saint-Pétersbourg ou à Moscou, mais qui souhaitent vivement devenir bioinformaticiens — nous avons préparé sur les algorithmes, la programmation, la génétique et la biologie.
Nous avons également des dizaines , que vous pouvez commencer à suivre dès maintenant.
En 2018, l'école d'été de bioinformatique a été organisée avec le soutien de nos partenaires réguliers – les entreprises JetBrains, BIOCAD et EPAM, pour lesquelles nous leur sommes très reconnaissants.
À tous les bioinformaticiens !
P.S. Si cela vous semble peu, et .
Source : habr.com
