

Introduction philosophique
Comme on le sait, il existe seulement deux méthodes pour résoudre des problèmes :
- La méthode d'analyse ou méthode déductive, ou de l général au particulier.
- La méthode de synthèse ou méthode inductive, ou du particulier au général.
Pour résoudre le problème "améliorer la performance de la base de données", cela peut ressembler à ceci.
Analyse — nous décomposons le problème en parties distinctes et en les résolvant, nous essayons finalement d'améliorer la performance globale de la base de données.
En pratique, l'analyse ressemble à ceci :
- Un problème survient (incident de performance)
- Nous collectons des informations statistiques sur l'état de la base de données
- Nous cherchons les goulets d'étranglement
- Nous résolvons les problèmes des goulets d'étranglement
Goulets d'étranglement de la base de données — infrastructure (CPU, Mémoire, Disques, Réseau, OS), configurations (postgresql.conf), requêtes :
Infrastructure: les possibilités d'influence et de changement pour l'ingénieur sont presque nulles.
Configurations de la base de données: les possibilités de changements sont légèrement supérieures au cas précédent, mais généralement toujours assez difficiles, surtout dans le cloud.
Requêtes à la base de données : le seul domaine de manœuvre.
Synthèse — nous améliorons la performance des parties individuelles, en espérant qu'en conséquence, la performance de la base de données s'améliorera.
Introduction lyrique ou pourquoi tout cela est nécessaire
Comment se déroule le processus de résolution d'incidents de performance, si la performance de la base de données n'est pas surveillée :
Client - "nous avons tout mauvais, lent, faites-nous bien"
Ingénieur - "mauvais, c'est quoi ?"
Client - "voici comment c'est actuellement (il y a une heure, hier, la dernière fois c'était), lent"
Ingénieur - "et quand c'était bien ?"
Client - "il y a une semaine (deux semaines), c'était pas mal." (C'est de la chance)
Client - "je ne me souviens pas quand c'était bon, mais maintenant c'est mauvais" (Réponse habituelle)
Le résultat donne un tableau classique :
Qui est responsable et que faire ?
Pour la première partie de la question, il est plus facile de répondre - c'est toujours la faute de l'ingénieur DBA.
Pour la deuxième partie, ce n'est pas trop difficile non plus - il faut mettre en place un système de surveillance des performances de la base de données.
La première question se pose - que surveiller ?
Chemin 1. Nous allons surveiller TOUT
La charge CPU, le nombre d'opérations de lecture/écriture sur le disque, la taille de la mémoire allouée, et encore une méga-tonne de différents compteurs que tout système de surveillance fonctionnel peut fournir.
Le résultat est une multitude de graphiques, de tableaux récapitulatifs et des alertes constantes par e-mail, ainsi qu'une occupation à 100 % de l'ingénieur à traiter une multitude de tickets identiques, qui se formulent généralement de manière standard — « Problème temporaire. Aucune action requise ». Mais au moins, tout le monde est occupé, et il y a toujours quelque chose à montrer au client — le travail est en cours.
Voie 2. Surveiller uniquement ce qui est nécessaire, et ne pas surveiller ce qui n'est pas nécessaire.
On peut surveiller, un peu différemment : uniquement les entités et les événements :
- Sur lesquels l'ingénieur DBA peut agir.
- Pour lesquels il existe un algorithme d'actions en cas d'événement ou de changement d'entité.
À partir de cette hypothèse et en se souvenant de «Introduction philosophique», afin d'éviter la répétition régulière de «Introduction lyrique ou pourquoi tout cela est nécessaire», il serait judicieux de surveiller la performance des requêtes spécifiques, pour optimiser et analyser, ce qui devrait finalement mener à une amélioration des performances de l'ensemble de la base de données.
Mais pour améliorer une requête lourde qui affecte la performance générale de la base de données, il faut d'abord la trouver.
Ainsi, deux questions interdépendantes se posent :
- quelle requête est considérée comme lourde
- comment trouver les requêtes lourdes.
Évidemment, une requête lourde est celle qui utilise beaucoup de ressources système pour obtenir un résultat.
Passons à la deuxième question — comment chercher et ensuite surveiller les requêtes lourdes ?
Quelles options de surveillance des requêtes existent dans PostgreSQL ?
Comparé à Oracle, les options sont un peu limitées, mais quelques actions peuvent tout de même être entreprises.
PG_STAT_STATEMENTS
Pour trouver et surveiller les requêtes lourdes dans PostgreSQL, l'extension standard pg_stat_statements est utilisée.
Après l'installation de l'extension, une vue du même nom apparaît dans la base de données cible, qui doit être utilisée à des fins de surveillance.
Colonnes cibles de pg_stat_statements pour construire un système de surveillance :
- queryid Code de hachage interne, calculé à partir de l'arbre d'analyse de l'instruction.
- max_time Temps maximum consacré à l'instruction, en millisecondes.
En accumulant et en utilisant des statistiques sur ces deux colonnes, on peut construire un système de surveillance.
Comment pg_stat_statements est utilisé pour surveiller les performances de PostgreSQL
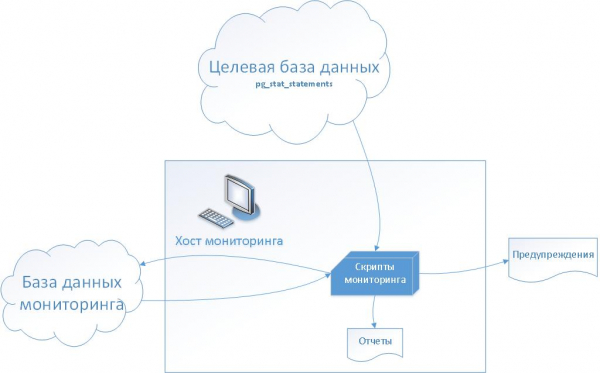
Pour surveiller les performances des requêtes, on utilise :
Du côté de la base de données cible — la vue pg_stat_statements
Du côté de serveurs et de la base de données de surveillance — un ensemble de scripts bash et de tables de service.
Étape 1 - collecte de données statistiques
Sur l'hôte de surveillance, un script est exécuté régulièrement par cron, qui copie le contenu de la vue pg_stat_statements de la base de données cible dans la table pg_stat_history de la base de données de surveillance.
Ainsi, l'historique de l'exécution des requêtes individuelles est constitué, ce qui peut être utilisé pour générer des rapports de performance et configurer des métriques.
Étape 2 - configuration des métriques de performance
Sur la base des données collectées, nous choisissons les requêtes dont l'exécution est la plus critique/essentielle pour le client (l'application). En accord avec le client, nous établissons les valeurs des métriques de performance en utilisant les champs queryid et max_time.
Résultat - début de la surveillance des performances
- Lors de son lancement, le script de surveillance vérifie les métriques de performance configurées, en comparant la valeur max_time de la métrique avec la valeur de la vue pg_stat_statements dans la base de données cible.
- Si la valeur dans la base de données cible dépasse la valeur de la métrique, un avertissement est généré (incident dans le système de tickets)
Fonctionnalité supplémentaire 1
Historique des plans d'exécution des requêtes
Pour une résolution ultérieure des incidents de performance, il est très utile d'avoir un historique des modifications des plans d'exécution des requêtes.
Pour stocker l'historique, une table de service log_query est utilisée. La table est remplie lors de l'analyse du fichier journal chargé de PostgreSQL. Étant donné que le fichier journal, contrairement à la vue pg_stat_statements, contient le texte complet avec les valeurs des paramètres d'exécution, et non le texte normalisé, il est possible de conserver non seulement le temps et la durée des requêtes, mais aussi d'enregistrer les plans d'exécution à un moment donné.
Fonctionnalité supplémentaire 2
Processus d'amélioration continue des performances
La surveillance des requêtes individuelles n'est généralement pas destinée à résoudre le problème de l'amélioration continue des performances de la base de données dans son ensemble, car elle ne gère que les problèmes de performance pour des requêtes spécifiques. Cependant, il est possible d'élargir la méthode et de configurer la surveillance des requêtes pour toutes les bases de données.
Pour cela, il faut introduire des métriques de performance supplémentaires :
- Ces derniers jours
- Pour une période de base
Le script sélectionne les requêtes de la vue pg_stat_statements de la base de données cible et compare la valeur max_time à la moyenne max_time, dans le premier cas sur les jours récents ou sur une période de temps choisie (baseline), dans le second cas.
Ainsi, en cas de dégradation des performances pour toute requête, un avertissement sera généré automatiquement, sans analyse manuelle des rapports.
Et quel est le rapport avec la synthèse ?
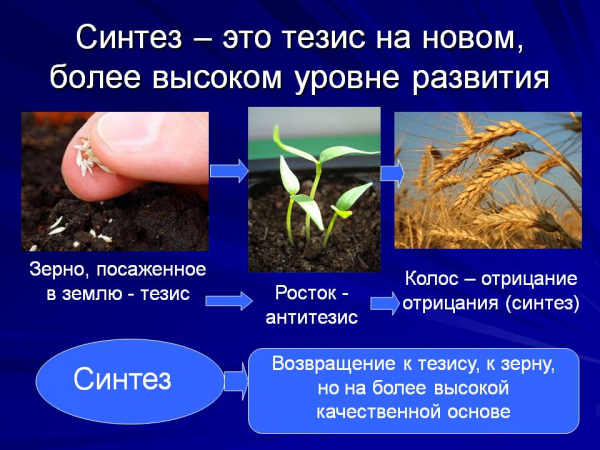
Dans l'approche décrite, comme le suppose la méthode de synthèse - en améliorant des parties individuelles du système, nous améliorons le système dans son ensemble.
- Requête exécutée par la base de données - thèse
- Requête modifiée - antithèse
- Changement d'état du système - synthèse
Développement du système
- Extension des statistiques collectées en ajoutant l'historique à la vue système pg_stat_activity
- Extension des statistiques collectées en ajoutant l'historique pour les statistiques des tables individuelles participant aux requêtes
- Intégration avec le système de surveillance dans le cloud AWS
- Et encore, on peut imaginer quelque chose…
Source : habr.com
