

Qu'est-ce qui peut pousser une grande entreprise comme Lamoda, avec un processus bien rodé et des dizaines de services interconnectés, à changer radicalement d'approche ? Les motivations peuvent être variées : de la législation au désir d'expérimentation qui caractérise tous les programmeurs.
Mais cela ne signifie pas qu'il n'y a pas d'avantages supplémentaires à en attendre. En quoi peut-on réellement bénéficier de l'implémentation d'une API basée sur des événements avec Kafka, nous l'expliquera Sergueï Zaïka (). Des leçons tirées d'expériences passées et des découvertes fascinantes seront également partagées – une expérience ne peut se passer d'elles.
Avertissement : Cet article est basé sur les matériaux d'un meetup que Sergueï a tenu en novembre 2018 lors de HighLoad++. L’expérience concrète de Lamoda avec Kafka a captivé l’auditoire tout autant que d'autres présentations de l'événement. Nous pensons que c'est un excellent exemple de la nécessité de toujours trouver des parties prenantes, et les organisateurs de HighLoad++ continueront à créer une ambiance propice à cela.
Concernant le processus
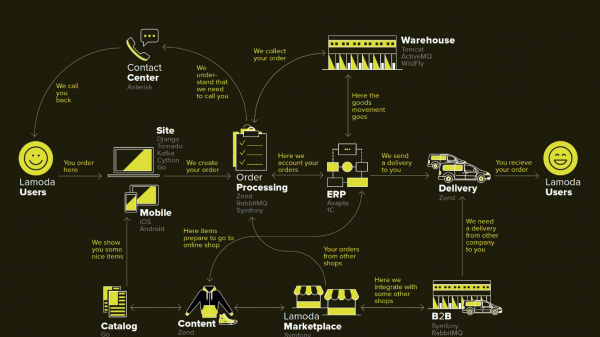
Lamoda est une grande plateforme e-commerce disposant de son propre centre de contact, de son service de livraison (ainsi que de nombreux partenaires), d'un studio photo, d'un immense entrepôt, et tout cela fonctionne avec son propre logiciel. Il existe des dizaines de méthodes de paiement, des partenaires B2B qui peuvent utiliser une partie ou la totalité de ces services et qui souhaitent connaître les informations actualisées sur leurs produits. De plus, Lamoda opère dans trois pays en plus de la Russie et chaque marché a ses spécificités. En tout, il y a probablement plus d'une centaine de façons de configurer une nouvelle commande qui doit être traitée d'une certaine manière. Tout cela fonctionne grâce à des dizaines de services qui communiquent parfois de manière peu évidente. Il y a également un système central dont la principale responsabilité est de gérer les statuts des commandes. Nous l'appelons BOB, et je travaille avec lui.
Outil de Remboursement avec API basée sur des événements
Le terme 'basé sur des événements' est assez répandu, et nous préciserons un peu plus tard ce que cela signifie. Je commencerai par le contexte dans lequel nous avons décidé de tester l'approche de l'API basée sur des événements avec Kafka.
Dans tout magasin, en plus des commandes pour lesquelles les clients paient, il arrive que le magasin doive rembourser de l'argent parce que le produit ne convient pas au client. Ce processus relativement court consiste à vérifier les informations, si nécessaire, puis à transférer les fonds.
Cependant, le retour est devenu plus compliqué en raison des changements législatifs, et nous avons dû mettre en place un microservice séparé pour cela.
Notre motivation :
- Loi FZ-54 — en résumé, la loi exige de signaler à l'administration fiscale chaque opération financière, qu'il s'agisse d'un retour ou d'une entrée, dans un SLA assez court de quelques minutes. Nous, en tant qu'e-commerce, effectuons de nombreuses opérations. Techniquement, cela signifie une nouvelle responsabilité (et donc un nouveau service) et des modifications dans tous les systèmes concernés.
- BOB split — un projet interne de l'entreprise visant à libérer BOB d'un grand nombre de responsabilités non essentielles et à réduire sa complexité globale.
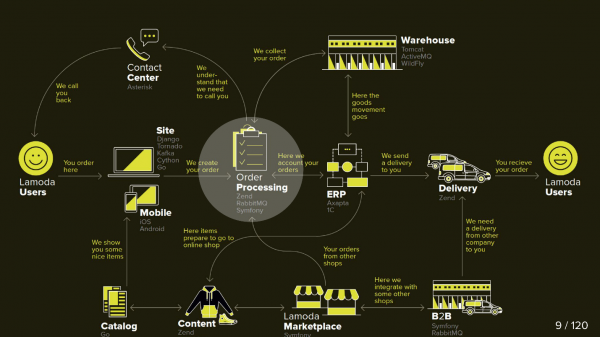
Ce schéma représente les principaux systèmes de Lamoda. Actuellement, la plupart d'entre eux sont plutôt un regroupement de 5 à 10 microservices autour d'un monolithe en réduction.Ils croissent lentement, mais nous essayons de les réduire, car déployer un fragment isolé au milieu est effrayant — il ne faut pas permettre qu'il échoue. Tous les échanges (flèches) doivent être réservés, anticipant que l'un d'eux pourrait être indisponible.
Il y a aussi pas mal d'échanges dans BOB : systèmes de paiement, de livraison, de notification, etc.
Techniquement, BOB c'est :
- ~150k lignes de code + ~100k lignes de tests ;
- php7.2 + Zend 1 & Symfony Components 3 ;
- >100 API & ~50 intégrations sortantes ;
- 4 pays avec leur propre logique commerciale.
Déployer BOB coûte cher et est difficile, la quantité de code et les tâches qu'il gère sont telles que personne ne peut le garder en tête entièrement. En somme, il y a beaucoup de raisons de le simplifier.
Processus de retour
Au départ, deux systèmes sont impliqués : BOB et Payment. Maintenant, deux autres apparaissent :
- Fiscalization Service, qui s'attaquera aux problèmes de fiscalisation et communiquera avec des services externes.
- Refund Tool, où de nouveaux échanges sont simplement transférés pour ne pas alourdir BOB.
Maintenant, le processus ressemble à ceci :
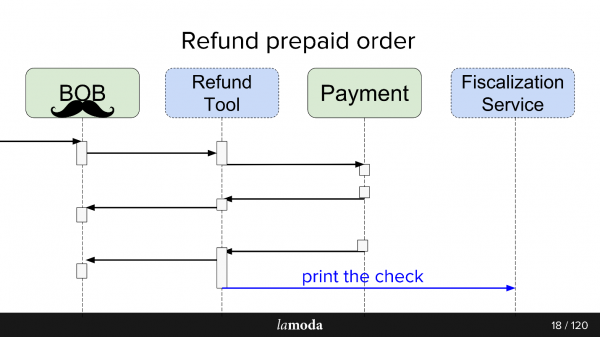
- Une demande de remboursement arrive à BOB.
- BOB en informe le Refund Tool.
- Refund Tool informe Payment : « Remboursez l'argent ».
- Payment rembourse l'argent.
- Refund Tool et BOB synchronisent leurs statuts, car pour le moment, cela leur est nécessaire à tous les deux. Nous ne sommes pas encore prêts à nous déconnecter complètement dans Refund Tool, car BOB a une interface utilisateur, des rapports pour la comptabilité, et beaucoup de données qui ne peuvent pas être transférées facilement. Nous devons rester sur deux chaises.
- Une demande de fiscalisation est envoyée.
En fin de compte, nous avons créé une sorte de bus d'événements sur Kafka, qui est devenu notre point de référence. Hourra, maintenant nous avons un point de défaillance unique (sarcasme).
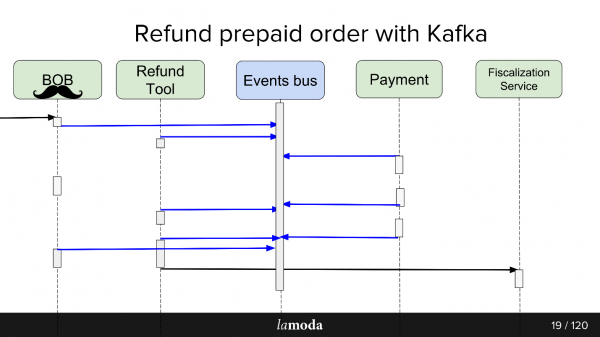
Les avantages et les inconvénients sont assez évidents. Nous avons créé un bus, donc maintenant tous les services en dépendent. Cela simplifie la conception, mais introduit un point de défaillance unique dans le système. Si Kafka tombe, le processus s'arrête.
Qu'est-ce qu'une API basée sur les événements ?
Une bonne réponse à cette question se trouve dans le rapport de Martin Fowler (GOTO 2017). .
En résumé, voici ce que nous avons fait :
- Nous avons encapsulé tous les échanges asynchrones via le stockage des événements.Au lieu de communiquer par le réseau avec chaque consommateur concerné concernant un changement de statut, nous écrivons dans un stockage centralisé un événement de changement d'état, et les consommateurs intéressés par le sujet lisent tout ce qui apparaît là-bas.
- Un événement dans ce contexte est une notification (notifications) que quelque chose a changé quelque part. Par exemple, le statut d'une commande a changé. Un consommateur qui a besoin de certaines données accompagnant le changement de statut, et qui ne sont pas dans la notification, peut vérifier son état lui-même.
- La version maximale serait un event sourcing complet, transfert d'état, où un événement contient toutes les informations nécessaires au traitement : d'où et dans quel statut cela a changé, comment les données ont été modifiées, etc. La question ne concerne que la faisabilité et le volume d'informations que vous pouvez vous permettre de stocker.
Dans le cadre du lancement de l'outil de remboursement, nous avons utilisé la troisième option. Cela a simplifié le traitement des événements, car aucune information détaillée n'a besoin d'être récupérée, et cela a exclu le scénario où chaque nouvel événement déclenche une vague de requêtes GET d'éclaircissement de la part des consommateurs.
Le service de remboursement n'est pas chargé, donc Kafka est plutôt un essai qu'une nécessité. Je ne pense pas que si le service de remboursement devenait un projet à fort trafic, l'entreprise serait contente.
Échange asynchrone tel quel
Pour les échanges asynchrones, le département PHP utilise généralement RabbitMQ. Nous rassemblons les données pour la demande, les mettons dans une file d'attente, et le consommateur de ce même service les lit et les envoie (ou ne les envoie pas). Pour l'API, Lamoda utilise activement Swagger. Nous concevons l'API, la décrivons dans Swagger, et générons le code client et serveur. Nous utilisons aussi un JSON RPC 2.0 légèrement étendu.
Des bus ESB sont utilisés par certains, d'autres vivent sur ActiveMQ, mais dans l'ensemble, RabbitMQ - standard.
Échange asynchrone À FAIRE
En concevant l'échange via le bus d'événements, on peut faire une analogie. Nous décrivons de manière similaire l'échange futur de données à travers des descriptions de la structure de l'événement. Le format yaml, la génération de code devait être effectuée par nos soins, le générateur selon la spécification crée des DTO et enseigne aux clients et aux serveurs comment travailler avec eux. La génération se fait dans deux langages - golang et php. Cela permet de garder les bibliothèques cohérentes. Le générateur est écrit en golang, ce qui lui a valu le nom de gogi.
Event sourcing sur Kafka est quelque chose de typique. Il existe une solution de la version enterprise principale Kafka Confluent, il y a , une solution de nos « frères » dans le domaine de Zalando. Notre motivation pour commencer avec Kafka vanilla est de garder la solution gratuite, tant que nous n'avons pas décidé de l'utiliser de manière généralisée, et également de nous laisser de la place pour manœuvrer et améliorer : nous voulons le support de notre JSON RPC 2.0, des générateurs pour deux langages et voir ce qu'il y a d'autre.
Ironiquement, même dans un tel cas heureux, où il existe une entreprise à peu près similaire à Zalando, qui a fait une solution à peu près similaire, nous ne pouvons pas l'utiliser efficacement.
Architecturalement, au lancement, le modèle est le suivant : nous lisons directement à partir de Kafka, mais écrivons uniquement via le bus d'événements. Pour la lecture, il y a beaucoup de choses prêtes : brokers, équilibreur de charge et elle est plus ou moins prête pour le scaling horizontal, c'est quelque chose que nous voulions conserver. L'écriture, en revanche, nous avons voulu l'encapsuler via un Gateway alias Events-bus, et voici pourquoi.
Events-bus
Ou bus d'événements. C'est simplement un gateway http sans état, qui prend plusieurs rôles importants :
- Validation du production — nous vérifions que les événements répondent à notre spécification.
- Système maître des événements, c'est-à-dire que c'est le système principal et unique dans l'entreprise, qui répond à la question, quels événements avec quelles structures sont considérés comme valides. Dans la validation, sont inclus simplement des types de données et des enums pour spécifier strictement le contenu.
- Fonction de hachage pour le partitionnement - la structure du message Kafka est de type key-value et c'est à partir du hachage de la clé que l'on calcule où mettre cela.
Pourquoi
Nous travaillons dans une grande entreprise avec un processus bien rodé. Pourquoi changer quelque chose ? C'est une expérience, et nous prévoyons d'en tirer plusieurs avantages.
Échanges 1:n+1 (un à plusieurs)
Avec Kafka, il est très simple de connecter de nouveaux consommateurs à l'API.
Supposons que vous ayez un annuaire qui doit être mis à jour dans plusieurs systèmes en même temps (y compris dans de nouveaux). Auparavant, nous avions inventé un bundle qui implémentait le set-API, et la master-system informait les adresses des consommateurs. Maintenant, la master-system envoie des mises à jour dans un topic, et tous ceux que cela intéresse les lisent. Un nouveau système est apparu — il a été abonné au topic. Oui, c'est aussi un bundle, mais plus simple.
Dans le cas de l'outil de remboursement, qui est en fait une petite partie de BOB, il nous convient de les synchroniser via Kafka. Le paiement indique que l'argent a été remboursé : BOB et RT en ont été informés, ont mis à jour leurs statuts, le service de fiscalisation en a été informé et a émis le reçu.
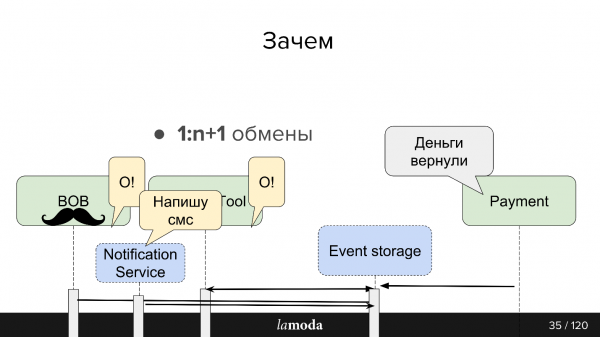
Nous avons des plans pour créer un service de notifications unifié, qui informerait le client des nouvelles concernant sa commande/retours. Actuellement, cette responsabilité est dispersée entre les systèmes. Il nous suffira d'apprendre au service de notifications à extraire les informations pertinentes de Kafka et à y réagir (et à désactiver ces notifications dans les autres systèmes). Aucun nouvel échange direct ne sera nécessaire.
Axé sur les données
L'information entre les systèmes devient transparente — quel que soit le « gros entreprise » que vous ayez et peu importe la taille de votre backlog. Lamoda dispose d'un département d'analyse de données qui collecte des données sur les systèmes et les normalise pour les rendre réutilisables, tant pour le business que pour les systèmes intelligents. Kafka permet de leur fournir rapidement beaucoup de données et de maintenir ce flux d'information à jour.
Journal de réplication
Les messages ne disparaissent pas après avoir été lus, comme dans RabbitMQ. Lorsque l'événement contient suffisamment d'informations pour être traité, nous avons un historique des dernières modifications apportées à l'objet, et, si vous le souhaitez, la possibilité d'appliquer ces modifications.
La durée de conservation du journal de réplication dépend de l'intensité des écritures dans ce topic. Kafka permet de configurer de manière flexible les limites de temps de stockage et le volume des données. Pour les topics à fort trafic, il est important que tous les consommateurs puissent lire les informations avant qu'elles ne disparaissent, même en cas de défaillance temporaire. En général, nous arrivons à conserver les données pendant un certain nombre de jours, ce qui est tout à fait suffisant pour le support.
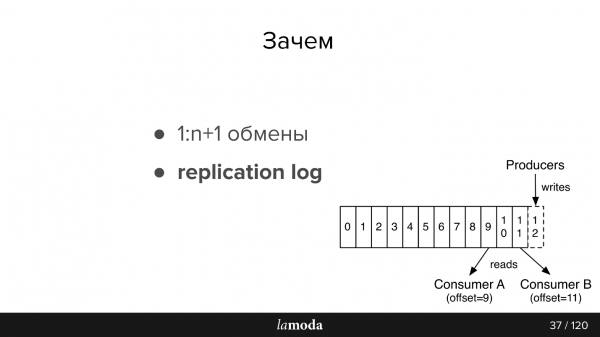
Un petit résumé de la documentation pour ceux qui ne sont pas familiers avec Kafka (l'image provient également de la documentation)
Dans AMQP, il existe des files d'attente : nous écrivons des messages dans une file d'attente pour le consommateur. En règle générale, une seule file d'attente est gérée par un système avec la même logique commerciale. Si plusieurs systèmes doivent être notifiés, l'application peut être configurée pour écrire dans plusieurs files d'attente ou configurer un exchange avec un mécanisme fanout, qui les clone automatiquement.
Dans Kafka, il existe une abstraction similaire topic, dans laquelle vous écrivez des messages, mais ils ne disparaissent pas après lecture. Par défaut, lorsque vous vous connectez à Kafka, vous recevez tous les messages, et vous avez la possibilité de conserver la position à laquelle vous vous êtes arrêté. C'est-à-dire que vous lisez séquentiellement, vous n'êtes pas obligé de marquer le message comme lu, mais vous pouvez sauvegarder l'id à partir duquel vous continuerez à lire. L'id à laquelle vous vous êtes arrêté s'appelle offset, et le mécanisme est ce qu'on appelle commit offset.
Par conséquent, il est possible de mettre en œuvre différentes logiques. Par exemple, nous avons BOB qui existe en 4 instances pour différents pays - Lamoda est présent en Russie, au Kazakhstan, en Ukraine et en Biélorussie. Étant donné qu'ils sont déployés séparément, ils ont un peu leurs propres configurations et leur propre logique commerciale. Nous indiquons dans le message à quel pays il se rattache. Chaque consommateur BOB dans chaque pays lit avec différents groupId, et, si le message ne le concerne pas, il l'ignore, c'est-à-dire qu'il commet immédiatement offset +1. Si le même topic est lu par notre Service de Paiement, il le fait avec un groupe séparé, et c'est pourquoi les offsets ne se chevauchent pas.
Exigences sur les événements :
- Complétude des données. Il serait souhaitable que l'événement contienne suffisamment de données pour pouvoir être traité.
- Intégrité. Nous déléguons au bus d'événements la vérification de la cohérence de l'événement et de sa capacité à être traité.
- L'ordre est important. Dans le cas d'un retour, nous devons travailler avec l'historique. Pour les notifications, l'ordre n'est pas important, si ce sont des notifications homogènes, l'email sera identique peu importe lequel des ordres est arrivé en premier. Dans le cas d'un retour, il y a un processus clair, si l'ordre est modifié, cela peut entraîner des exceptions, un remboursement ne sera pas créé ou traité - nous entrerons dans un autre statut.
- Cohérence. Nous avons un stockage, et maintenant nous créons des événements au lieu d'une API. Nous avons besoin d'un moyen rapide et peu coûteux de transmettre des informations sur de nouveaux événements et sur les modifications des événements existants à nos services. Cela est réalisé grâce à une spécification commune dans un dépôt git séparé et des générateurs de code. Ainsi, les clients et les serveurs dans différents services sont synchronisés.
Kafka chez Lamoda
Nous avons trois installations de Kafka :
- Logs ;
- R&D ;
- Events-bus.
Aujourd'hui, nous ne parlons que du dernier point. Dans l'events-bus, nous avons des installations plutôt modestes - 3 courtiers (serveurs) et seulement 27 sujets. En général, un sujet correspond à un processus. Mais c'est un point délicat, et nous allons y revenir.
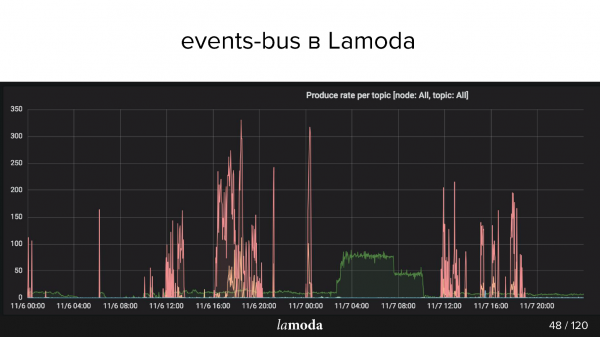
Ci-dessus, le graphique des rps. Le processus des remboursements est marqué par une ligne turquoise (oui, celle qui est sur l'axe X), et par une ligne rose - le processus de mise à jour du contenu.
Le catalogue Lamoda contient des millions de produits, et les données sont constamment mises à jour. Certaines collections sortent de la mode, tandis que de nouvelles sont lancées, de nouveaux modèles apparaissent en permanence dans le catalogue. Nous essayons de prédire ce qui pourrait intéresser nos clients demain, c'est pourquoi nous achetons constamment de nouvelles choses, les photographions et mettons à jour la vitrine.
Les pics roses représentent des mises à jour de produits, c'est-à-dire des modifications concernant les articles. On peut voir que les équipes ont photographié, photographié, puis soudain ! - ils ont téléchargé un lot d'événements.
Cas d'utilisation de Lamoda Events
L'architecture construite est utilisée pour de telles opérations :
- Suivi des statuts des retours: appel à l'action et suivi des statuts de tous les systèmes impliqués. Paiement, statuts, fiscalisation, notifications. Ici, nous avons essayé une approche, créé des outils, rassemblé tous les bogues, écrit la documentation et expliqué à nos collègues comment les utiliser.
- Mise à jour des fiches produit : configuration, métadonnées, caractéristiques. Une seule système lit (celui qui affiche), tandis que plusieurs écrivent.
- Email, push et sms: commande rassemblée, commande arrivée, retour accepté, etc., il y en a beaucoup.
- Stock, mise à jour des inventaires - mise à jour quantitative des articles, juste des chiffres : arrivée au stock, retour. Il est nécessaire que tous les systèmes liés à la réservation de produits fonctionnent avec les données les plus à jour possibles. Actuellement, le système de mise à jour des stocks est assez complexe, Kafka permettra de le simplifier.
- Analyse des données (Département R&D), outils ML, analytics, statistiques. Nous souhaitons que les informations soient transparentes — c'est pourquoi Kafka convient bien.
Maintenant, la partie la plus intéressante concernant les erreurs commises et les découvertes fascinantes qui ont eu lieu au cours des six derniers mois.
Problèmes de conception
Supposons que nous souhaitons créer une nouvelle fonctionnalité — par exemple, transférer l'ensemble du processus de livraison vers Kafka. Actuellement, une partie du processus est implémentée dans Order Processing dans BOB. Dans la transmission de la commande au service de livraison, le déplacement vers l'entrepôt intermédiaire et d'autres éléments, il y a un modèle de statut. Il existe un monolithe entier, même deux, plus une multitude d'API dédiées à la livraison. Ils en savent beaucoup plus sur la livraison.
Il semble que ce soient des domaines similaires, mais pour Order Processing dans BOB et pour le système de livraison, les statuts sont différents. Par exemple, certains services de messagerie n'envoient pas de statuts intermédiaires, mais seulement finaux : « livré » ou « perdu ». D'autres, en revanche, informent très précisément sur le déplacement du produit. Chacun a ses propres règles de validation : pour certains, un email valide signifie qu'il sera traité ; pour d'autres — pas valide, mais la commande sera tout de même traitée car un numéro de téléphone est disponible, et certains diront qu'une telle commande ne sera pas traitée du tout.
Flux de données
Dans le cas de Kafka, la question de l'organisation du flux de données se pose. Cette tâche est liée au choix d'une stratégie sur plusieurs points, examinons-les tous.
Dans un seul topic ou dans plusieurs ?
Nous avons une spécification d'événement. Dans BOB, nous écrivons que cette commande doit être livrée, et nous indiquons : le numéro de commande, sa composition, certains SKU et codes-barres, etc. Lorsque le produit arrive à l'entrepôt, la livraison peut recevoir des statuts, des timestamps et tout ce qu'il faut. Mais ensuite, nous voulons recevoir des mises à jour sur ces données dans BOB. Un processus inverse de récupération de données de la livraison se met en place. Est-ce le même événement ? Ou s'agit-il d'un échange distinct qui mérite un topic séparé ?
Il est probable qu'ils soient très similaires, et la tentation de créer un seul topic n'est pas infondée, car un topic distinct signifie des consommateurs distincts, des configurations distinctes, une génération séparée de tout cela. Mais ce n'est pas certain.
Nouveau champ ou nouvel événement ?
Mais si nous utilisons les mêmes événements, un autre problème se pose. Par exemple, tous les systèmes de livraison ne peuvent pas générer un DTO qui puisse être généré par BOB. Nous leur envoyons un id, mais ils ne le conservent pas, car cela ne leur est pas nécessaire, alors que du point de vue du démarrage du processus event-bus, ce champ est obligatoire.
Si nous établissons pour l’event-bus la règle que ce champ est obligatoire, alors nous sommes contraints d'ajouter des règles de validation supplémentaires dans BOB ou dans le gestionnaire de l'événement de démarrage. La validation commence à se disperser dans le service - ce n'est pas très pratique.
Un autre problème est la tentation du développement incrémental. On nous dit qu'il faut ajouter quelque chose à l'événement et, peut-être, si l'on réfléchit bien, cela aurait dû être un événement distinct. Mais dans notre schéma, un événement distinct est un sujet distinct. Un sujet distinct correspond à tout le processus que j'ai décrit ci-dessus. Le développeur est tenté d'ajouter simplement un autre champ dans le schéma JSON et de régénérer.
Dans le cas des remboursements, nous avons ainsi abouti en six mois à des événements d'événements. Nous avions un méta-événement appelé mise à jour de remboursement, qui contenait un champ type, décrivant en quoi consistait précisément cette mise à jour. De là, nous avions des « superbements » des switches avec des validateurs qui indiquaient comment valider cet événement avec ce type.
Versionnage des événements
Pour valider les messages dans Kafka, on peut utiliser , mais il fallait dès le départ prévoir cela et utiliser Confluent. Dans notre cas avec le versionnage, il faut être prudent. Il ne sera pas toujours possible de relire les messages du journal de réplication, car le modèle « est parti ». En gros, on essaie de construire les versions de manière à ce que le modèle soit rétrocompatible : par exemple, rendre un champ temporairement non obligatoire. Si les différences sont trop importantes, nous commençons à écrire dans un nouveau sujet et nous transférons les clients lorsqu'ils ont fini de lire l'ancien.
Garantie de l'ordre de lecture des partitions
Les sujets dans Kafka sont divisés en partitions. Cela n'est pas très important tant que nous concevons des entités et des échanges, mais c'est crucial lorsque nous décidons comment les consommer et les étendre.
Dans un cas normal, vous publiez dans un seul topic Kafka. Par défaut, un seul partition est utilisé, et tous les messages de ce topic y sont envoyés. Le consommateur lit donc ces messages de manière séquentielle. Supposons maintenant qu'il faille étendre le système afin que deux consommateurs différents lisent les messages. Si, par exemple, vous envoyez un SMS, vous pouvez demander à Kafka de créer un partition supplémentaire, et Kafka commencera à répartir les messages en deux parties - la moitié là, la moitié ici.
Comment Kafka les divise-t-il ? Chaque message a un corps (dans lequel nous stockons le JSON) et une clé. Une fonction de hachage peut être appliquée à cette clé, déterminant ainsi à quel partition le message sera affecté.
Dans notre cas avec les remboursements, c'est important ; si nous prenons deux partitions, il y a une chance qu'un consommateur parallèle traite le deuxième événement avant le premier, ce qui engendrera des problèmes. La fonction de hachage garantit que les messages avec la même clé iront dans le même partition.
Événements vs commandes
C'est un autre problème auquel nous avons été confrontés. Un événement est quelque chose : nous disons que quelque chose s'est produit (something_happened), par exemple, un article a été annulé ou un remboursement a eu lieu. Si ces événements sont écoutés, alors à « article annulé », une entité de remboursement sera créée, et « remboursement effectué » sera consigné quelque part dans les paramètres.
Mais généralement, lorsque vous concevez des événements, vous ne voulez pas les écrire en vain - vous vous attendez à ce que quelqu'un les lise. Il y a une forte tentation d'écrire non pas something_happened (item_canceled, refund_refunded), mais something_should_be_done. Par exemple, article prêt pour le retour.
D'un côté, cela indique comment l'événement sera utilisé. D'un autre côté, cela semble beaucoup moins intitulé comme un événement normal. De plus, il n'est pas loin de l'ordre do_something. Mais vous n'avez aucune garantie que cet événement a été lu ; et s'il a été lu, il a été lu avec succès ; et s'il a été lu avec succès, il a été fait quelque chose, et ce quelque chose a réussi. Au moment où l'événement devient do_something, un retour d'information devient nécessaire, et c'est un problème.
Dans l'échange asynchrone avec RabbitMQ, lorsque vous avez lu le message, que vous êtes allé sur http, vous avez une réponse - au moins, que le message a été reçu. Lorsque vous avez écrit dans Kafka, il y a un message indiquant que vous avez écrit dans Kafka, mais vous ne savez rien de son traitement.
Dans notre cas, il a donc fallu mettre en place un événement de réponse et configurer la surveillance pour que, si un certain nombre d'événements survient, un nombre équivalent d'événements de réponse arrive dans un certain délai. Si cela ne se produit pas, cela signifie que quelque chose ne va pas. Par exemple, si nous avons envoyé l'événement « item_ready_to_refund », nous nous attendons à ce que le remboursement soit effectué, que l'argent soit retourné au client et que nous recevions l'événement « money_refunded ». Mais ce n'est pas toujours le cas, d'où la nécessité d'une surveillance.
Nuances
Il y a un problème assez évident : si vous lisez des messages de manière séquentielle et que vous rencontrez un message défaillant, le consommateur plante et vous ne pouvez plus avancer. Vous devez arrêter tous les consommateurs, valider l'offset pour continuer la lecture.
Nous étions au courant de cela, nous nous y attendions, et cela s'est quand même produit. Cela est arrivé parce que l'événement était valide du point de vue de l'events-bus, l'événement était valide selon le validateur d'application, mais il n'était pas valide du point de vue de PostgreSQL, car nous avons dans un système MySQL un UNSIGNED INT, tandis que dans le système récemment développé, il y avait un INT simple dans PostgreSQL. Sa taille est un peu plus petite, et l'Id ne tenait pas. Symfony a planté avec une exception. Nous avons bien sûr intercepté cette exception, car nous nous y attendions, et nous avions l'intention de valider cet offset, mais avant cela, nous voulions incrémenter le compteur de problèmes, puisque le message a échoué à être traité. Les compteurs de ce projet sont également stockés dans la base, et Symfony avait déjà fermé la communication avec la base, et une deuxième exception a tué tout le processus sans possibilité de valider l'offset.
Le service a été hors ligne pendant un certain temps – heureusement, avec Kafka, ce n'est pas si grave, car les messages restent. Lorsque le travail sera rétabli, ils pourront être relus. C'est pratique.
Kafka a la possibilité, grâce à des outils, de définir un offset arbitraire. Mais pour le faire, il faut arrêter tous les consommateurs – dans notre cas, préparer une version distincte qui n’aura pas de consommateurs, procedure de redeploiement. Alors, avec Kafka à travers l'outil, vous pouvez décaler l'offset et le message passera.
Une autre nuance – journal de réplication vs rdkafka.so — est lié à la spécificité de notre projet. Nous utilisons PHP, et dans PHP, en général, toutes les bibliothèques interagissent avec Kafka via le dépôt rdkafka.so, et ensuite, il y a une sorte d'enveloppe. Peut-être que ce sont nos difficultés personnelles, mais il s'est avéré qu'il n'est pas si facile de relire un morceau déjà lu. En somme, il y avait des problèmes logiciels.
En revenant aux particularités de travail avec les partitions, il est clairement indiqué dans la documentation consumers >= topic partitions. Mais j'ai appris cela bien plus tard que je ne l'aurais voulu. Si vous voulez vous développer et avoir deux consommateurs, vous avez besoin d'au moins deux partitions. C'est-à-dire que si vous aviez une seule partition, dans laquelle 20 000 messages se sont accumulés, et que vous en avez fait une nouvelle, le nombre de messages ne s'égalera pas de sitôt. Donc, pour avoir deux consommateurs parallèles, il faut se pencher sur les partitions.
Surveillance
Je pense que, selon notre suivi, il sera encore plus clair quels problèmes existent dans l'approche actuelle.
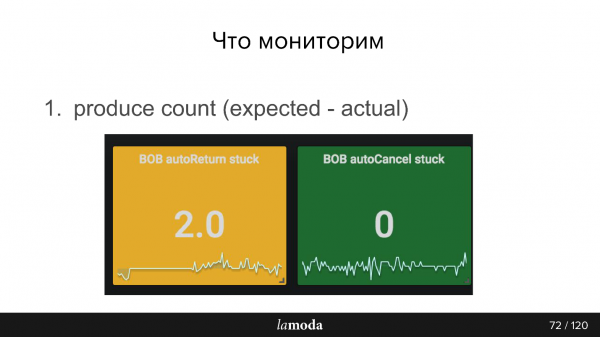
Par exemple, nous comptons combien de produits dans la base ont récemment changé de statut et, par conséquent, des événements auraient dû se produire selon ces changements, et nous envoyons ce nombre à notre système de suivi. Ensuite, nous obtenons de Kafka un second nombre, combien d'événements ont réellement été enregistrés. Évidemment, la différence entre ces deux nombres devrait toujours être nulle.
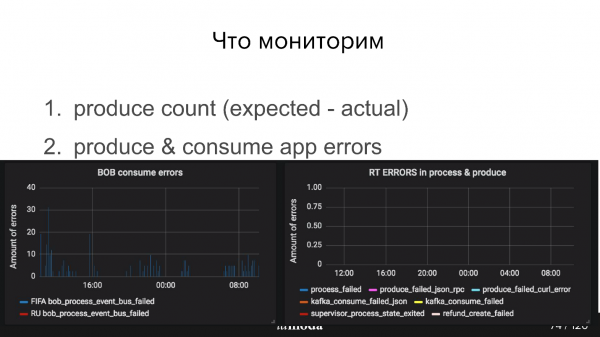
De plus, il faut surveiller comment ça se passe du côté du producteur, si l'events-bus a reçu des messages, et comment ça se passe du côté du consommateur. Par exemple, sur les graphes ci-dessous, tout va bien pour le Refund Tool, mais il y a clairement des problèmes pour BOB (pics bleus).
J'ai déjà mentionné le lag des groupes de consommateurs. Grosso modo, c'est le nombre de messages non lus. En général, nos consommateurs fonctionnent rapidement, donc le lag est généralement égal à 0, mais il peut parfois y avoir un pic temporaire. Kafka gère cela de manière native, mais il faut définir un certain intervalle.
Il y a un projet , qui vous donnera plus d'informations sur Kafka. Il renvoie simplement via l'API le statut de ce groupe de consommateurs, comment ce groupe s'en sort. En plus de OK et Failed, il y a des avertissements, et vous pourrez savoir que vos consommateurs n'arrivent pas à suivre le rythme de production — ils ne parviennent pas à lire ce qui est écrit. Le système est assez intelligent, il est facile à utiliser.
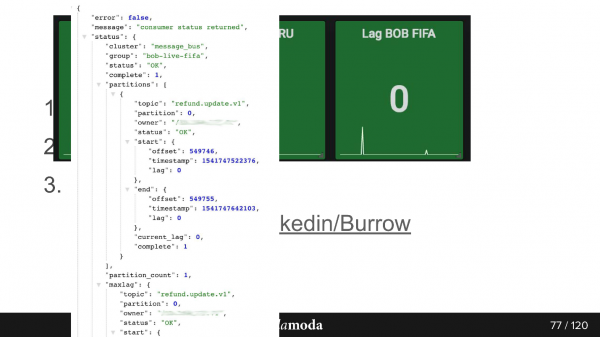
Voici à quoi ressemble la réponse de l'API. Ici, le groupe bob-live-fifa, la partition refund.update.v1, statut OK, lag 0 — le dernier offset final est tel quel.
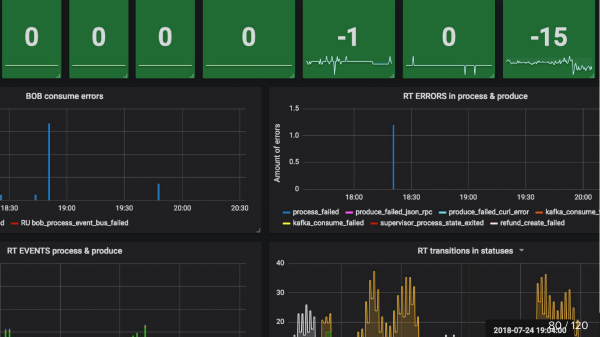
Surveillance updated_at SLA (stuck) J'ai déjà mentionné. Par exemple, un produit est passé au statut indiquant qu'il est prêt pour le retour. Nous mettons en place un Cron qui dit que si cet objet n'est pas passé en remboursement dans les 5 minutes (nous remboursons très rapidement via les systèmes de paiement), alors quelque chose ne va clairement pas et c'est un cas pour le support. Nous prenons donc simplement un Cron qui lit ces éléments, et s'ils sont supérieurs à 0, il envoie une alerte.
En résumé, il est pratique d'utiliser des événements lorsque:
- l'information est nécessaire à plusieurs systèmes ;
- le résultat du traitement n'est pas important ;
- il y a peu d'événements ou les événements sont petits.
À première vue, l'article semble avoir un sujet assez concret - API asynchrone sur Kafka, mais en rapport avec cela, j'ai beaucoup de recommandations à faire.
Tout d'abord, le suivant ne nécessite pas d'attendre jusqu'à novembre, sa version à Saint-Pétersbourg sera déjà en avril, et en juin, nous parlerons des charges élevées à Novossibirsk.
Deuxièmement, l'auteur de la présentation, Sergey Zaika, fait partie du comité de notre nouvelle conférence sur la gestion des connaissances. La conférence est d'un jour, se déroulera le 26 avril, mais son programme est très riche.
Et aussi en mai, il y aura et (avec DevOpsConf en tant que partie) - vous pouvez encore proposer votre propre sujet, partager votre expérience et parler de vos erreurs.
Source : habr.com
