

Certain companies, including our client, develop their product through a partner network. For example, large online stores are integrated with the delivery service—you order a product and soon receive a tracking number for the package. Another example is purchasing insurance or a ticket for the airport express along with your airline ticket.
To achieve this, a single API needs to be provided to partners through the API Gateway. This is the task we solved. In this article, we will discuss the details.
Given: an ecosystem and an API portal with an interface where users are registered, receive information, etc. We need to create a user-friendly and reliable API Gateway. In the process, we needed to ensure
- registration,
- API connection monitoring,
- monitoring how users use the end system,
- tracking business metrics.
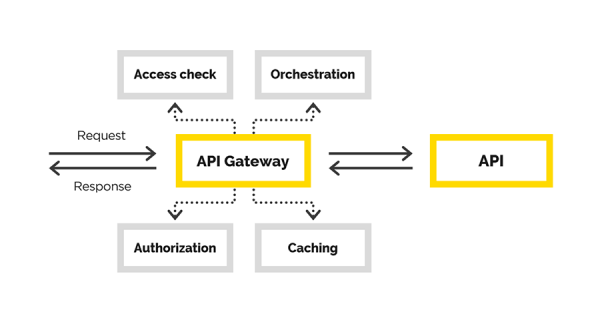
In this article, we will share our experience in creating an API Gateway, during which we addressed the following tasks:
- user authentication,
- user authorization,
- modification of the original request,
- request proxying,
- response post-processing.
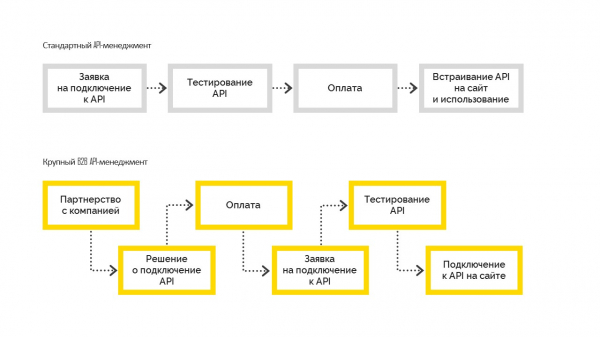
There are two types of API management:
1. Standard, which works as follows. Before connecting, the user tests the capabilities, then pays and integrates it into their website. It is most often used in small and medium-sized businesses.
2. Large B2B API Management, where the company first makes a business decision to connect, becomes a partner with contractual obligations, and only then connects to the API. After settling all formalities, the company receives test access, undergoes testing, and goes live. But this is not possible without a management decision to connect.
Our solution
In this part, we will discuss the creation of the API Gateway.
The end users of the created API gateway are our client's partners. We already have the necessary contracts stored for each of them. We will only need to expand the functionality, noting the provided access to the gateway. Accordingly, a controlled process for connection and management is required.
Certainly, it would have been possible to take some ready-made solution for API Management and creating an API Gateway in particular. For example, this could be. Cela ne nous convenait pas, car dans notre cas, nous avions déjà un portail API et un écosystème énorme construit autour. Tous les utilisateurs étaient déjà enregistrés et savaient où et comment obtenir les informations nécessaires. Les interfaces nécessaires existaient déjà dans le portail API, nous avions seulement besoin d'une API Gateway. C'est précisément son développement qui nous a occupés.
Ce que nous appelons API Gateway est une sorte de proxy. Ici, nous avions à nouveau le choix - soit écrire notre propre proxy, soit choisir quelque chose de déjà prêt. Dans ce cas, nous avons opté pour la seconde option et choisi la combinaison nginx+Lua. Pourquoi ? Nous avions besoin d'un logiciel fiable et éprouvé, soutenant l'évolutivité. Nous ne voulions pas avoir à vérifier à la fois la logique métier et le bon fonctionnement du proxy après la mise en œuvre.
Tout serveur web a une chaîne de traitement des requêtes. Dans le cas de nginx, cela se présente comme suit :
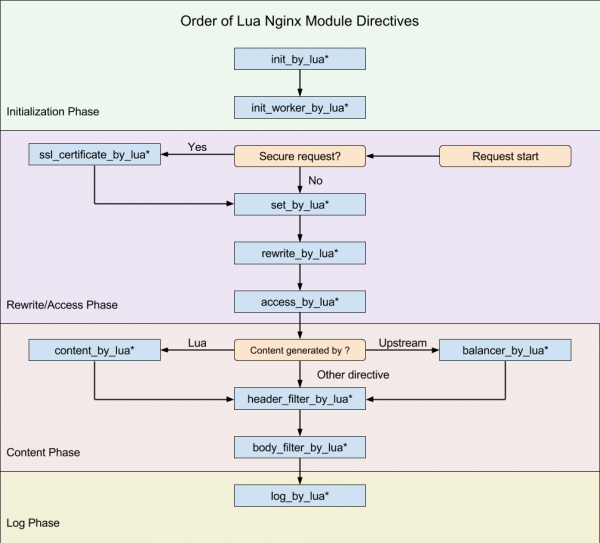
(schéma de )
Notre objectif était de s'intégrer dans cette chaîne au moment où nous pouvons modifier la requête initiale.
Nous souhaitons créer un proxy transparent, afin que la requête reste fonctionnellement telle qu'elle est arrivée. Nous contrôlons simplement l'accès à l'API finale, aidant la requête à y parvenir. Dans le cas où la requête était incorrecte, c'est l'API finale qui doit afficher l'erreur, et non nous. La seule raison pour laquelle nous pouvons rejeter une requête est l'absence d'accès pour le client.
Il existe déjà pour nginx sur . Lua est un langage de script, très léger et facile à apprendre. Nous avons donc réalisé la logique nécessaire à l'aide de Lua.
La configuration de nginx (analogie de l'application route), où tout le travail s'effectue, est assez compréhensible. La dernière directive est particulièrement remarquable - post_action.
location /middleware {
      more_clear_input_headers Accept-Encoding;
      lua_need_request_body on;
      rewrite_by_lua_file 'middleware/rewrite.lua';
      access_by_lua_file 'middleware/access.lua';
      proxy_pass https://someurl.com;
      body_filter_by_lua_file 'middleware/body_filter.lua';
      post_action /process_session;
}
Voyons ce qui se passe dans cette configuration :
more_clear_input_headers — nettoie la valeur des en-têtes spécifiés après la directive.
lua_need_request_body — détermine si le corps de la requête initiale doit être lu avant d'exécuter les directives rewrite/access/access_by_lua ou non. Par défaut, nginx ne lit pas le corps de la requête du client, et si vous devez y accéder, cette directive doit être définie sur on.
rewrite_by_lua_file — chemin vers le script où la logique pour modifier la requête est décrite
access_by_lua_file — chemin vers le script où la logique vérifiant l'accès à la ressource est décrite.
proxy_pass — url à laquelle la requête sera proxyfiée.
body_filter_by_lua_file — chemin vers le script où la logique pour filtrer la requête avant le retour au client est décrite.
Et enfin, post_action — directive non documentée qui permet d'effectuer d'autres actions après que la réponse ait été envoyée au client.
Nous allons maintenant expliquer dans l'ordre comment nous avons résolu nos problèmes.
Autorisation/authentification et modification de la requête
Autorisation
Nous avons construit l'autorisation et l'authentification en utilisant l'accès par certificat. Il y a un certificat racine. Un certificat personnel est généré pour chaque nouveau client du client, avec lequel il peut accéder à l'API. Ce certificat est configuré dans la section server des paramètres nginx.
ssl on;
ssl_certificate /usr/local/openresty/nginx/ssl/cert.pem;
ssl_certificate_key /usr/local/openresty/nginx/ssl/cert.pem;
ssl_client_certificate /usr/local/openresty/nginx/ssl/ca.crt;
ssl_verify_client on;
Modification
Il peut être légitime de se demander que faire avec un client certifié si soudainement nous voulons le déconnecter du système ? Ne faut-il pas réémettre des certificats pour tous les autres clients ?
Ainsi, nous avons progressivement abordé la prochaine tâche — la modification de la requête d'origine. La requête d'origine du client n'est pas valable pour le système final. L'une des tâches consiste à ajouter les parties manquantes à la requête pour la rendre valide. Le hic, c'est que les données manquantes varient pour chaque client. Nous savons que le client vient à nous avec un certificat dont nous pouvons prendre l'empreinte et extraire les données nécessaires du client à partir de la base.
Si à un moment donné il devient nécessaire de déconnecter un client de notre service, ses données disparaîtront de la base et il ne pourra rien faire.
Gestion des données du client
Nous devions assurer une haute disponibilité de la solution, en particulier pour la manière dont nous obtenons les données du client. La difficulté réside dans le fait que la source primaire de ces données est un service tiers qui ne garantit pas un fonctionnement ininterrompu et une vitesse de fonctionnement suffisamment élevée.
C'est pourquoi nous devions assurer une haute disponibilité des données clients. Comme outil, nous avons choisi , qui nous fournit :
- un accès rapide aux données,
- la possibilité d'organiser un cluster de plusieurs nœuds avec des données répliquées sur différents nœuds.
Nous avons suivi la stratégie la plus simple pour livrer les données en cache :
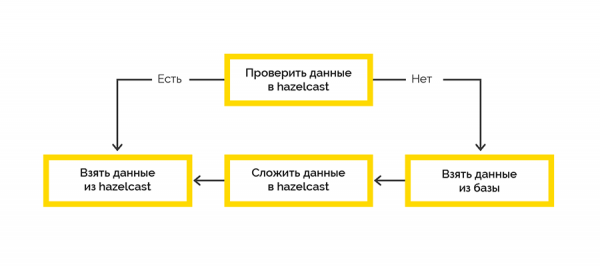
Le travail avec le système final se fait dans le cadre de sessions et il y a une limite sur le nombre maximal. Si le client n'a pas fermé la session, c'est à nous de le faire.
Les données sur la session ouverte proviennent du système final et sont initialement traitées du côté de Lua. Nous avons décidé d'utiliser Hazelcast pour sauvegarder ces données à l'aide d'un job écrit en .NET. Ensuite, à intervalles réguliers, nous vérifions la validité des sessions ouvertes et fermons celles qui ont expiré.
Accès à Hazelcast à la fois depuis Lua et depuis .NET
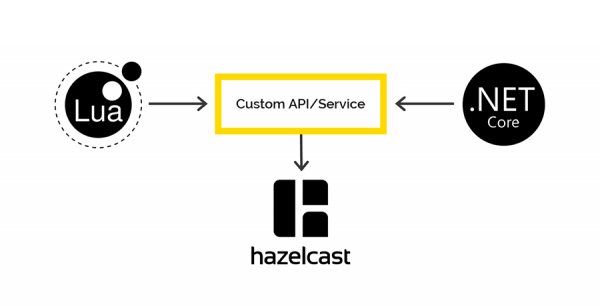
Il n'y a pas de clients Lua pour travailler avec Hazelcast, mais Hazelcast propose une API REST que nous avons décidé d'utiliser. Pour .NET, il existe , par lequel nous avions prévu d'accéder aux données Hazelcast côté .NET. Mais ce ne fut pas si simple.
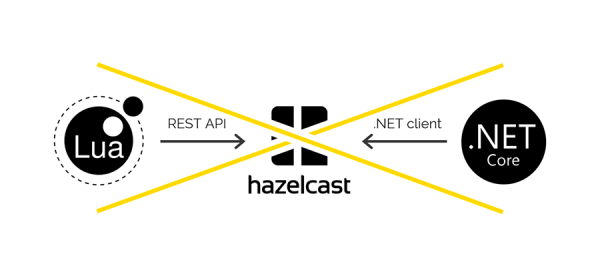
Lors de la sauvegarde des données via REST et de l'extraction à l'aide du client .NET, différents sérialiseurs/désérialiseurs sont utilisés. Il est donc impossible de mettre des données via REST et de les extraire avec le client .NET, et vice versa.
S'il y a des intéressés, nous en parlerons plus en détail dans un article séparé. Spoiler - sur le schéma.
Journalisation et surveillance
Notre standard d'entreprise pour la journalisation via .NET est Serilog, tous les journaux finissent par être envoyés dans Elasticsearch, et nous analysons les données via Kibana. Nous voulions faire à peu près la même chose dans ce cas. Cependant, le seul pour travailler avec Elastic en Lua que nous avons trouvé a échoué lors du premier require. Nous avons donc utilisé Fluentd.
est une solution open source pour fournir une couche unique de journalisation d'application. Elle permet de collecter des journaux provenant de différents niveaux de l'application, puis de les transmettre à une source unique.
API Gateway fonctionne dans K8S, nous avons donc décidé d'ajouter un conteneur avec Fluentd dans le même pod pour écrire les journaux dans le port tcp ouvert déjà existant de Fluentd.
Nous avons également étudié le comportement de Fluentd en cas de perte de connexion avec Elasticsearch. Pendant deux jours, des requêtes ont continué à arriver dans la passerelle, des journaux étaient envoyés à Fluentd, mais l'IP d'Elastic avait été bloquée. Après la restauration de la connexion, Fluentd a réussi à transférer tous les journaux vers Elastic.
Conclusion
L'approche choisie pour la mise en œuvre nous a permis de livrer un produit fonctionnel en production en seulement 2,5 mois.
Si jamais vous êtes amené à travailler sur ce type de tâches, nous vous conseillons de bien comprendre d'abord quel problème vous résolvez et quelles ressources vous avez déjà à disposition. Soyez attentif aux complexités d'intégration avec les systèmes de gestion API existants.
Comprenez ce que vous allez développer — uniquement la logique métier du traitement des requêtes ou, comme cela a pu être le cas pour nous, le proxy dans son intégralité. N'oubliez pas que tout ce que vous réaliserez par vous-même devra ensuite être rigoureusement testé.
Source : habr.com
