

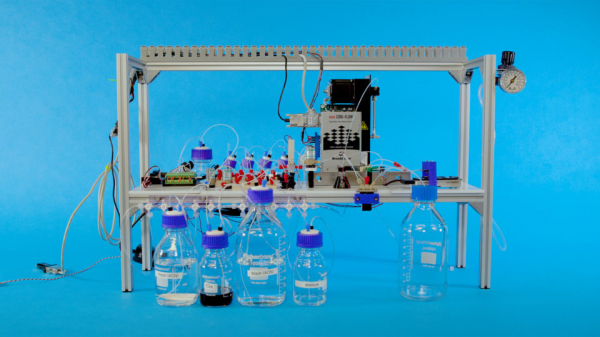
Des chercheurs de Microsoft et de l'Université de Washington ont démontré le premier système de stockage de données entièrement automatisé dans de l'ADN synthétique avec capacité de lecture. C'est une étape clé pour transférer cette nouvelle technologie des laboratoires de recherche vers des centres de données commerciaux.
Les développeurs ont confirmé le concept à l'aide d'un test simple : ils ont réussi à coder le mot « hello » dans des fragments de molécule d'ADN synthétique et à le reconvertir en données numériques, en utilisant un système entièrement automatisé de bout en bout, comme décrit dans , publié le 21 mars dans Nature Scientific Reports.
Les molécules d'ADN peuvent stocker des informations numériques avec une densité très élevée, c'est-à-dire dans un espace physique qui est de plusieurs ordres de grandeur plus petit que celui occupé par les centres de données modernes. C'est l'une des solutions prometteuses pour le stockage d'énormes quantités de données que le monde génère chaque jour, allant des dossiers commerciaux et vidéos d'animaux mignons aux images médicales et photos de l'espace.
Microsoft explore des moyens de surmonter le potentiel fossé entre et souhaitons conserver, et notre capacité à les stocker. Parmi ces moyens, on retrouve le développement d'algorithmes et de technologies de calcul moléculaire pour . Cela permettrait d'intégrer toutes les informations stockées dans un grand centre de données moderne dans un espace d'environ la taille de quelques dés.
« Notre principal objectif est de mettre en place un système qui se présentera pour l'utilisateur final presque comme n'importe quel autre système de stockage cloud : les informations sont envoyées dans un centre de données et y sont stockées, puis apparaissent simplement lorsqu'elles sont nécessaires au client, » déclare la chercheuse senior de Microsoft Karin Strauss. « Pour cela, nous devions prouver que cela avait un sens pratique en termes d'automatisation. »
Les informations sont stockées dans des molécules d'ADN synthétiques, créées en laboratoire, et non dans l'ADN des humains ou d'autres êtres vivants, et peuvent être cryptées avant d'être envoyées dans le système. Bien que des machines complexes, comme les synthétiseurs et les séquenceurs, effectuent déjà des parties clés du processus, de nombreuses étapes intermédiaires nécessitent encore un travail manuel dans les laboratoires de recherche. « Ce n'est pas adapté à une utilisation commerciale », a déclaré Chris Takahashi, chercheur principal à l'École d'informatique et d'ingénierie Paul G. Allen de l'Université des États-Unis.).
« Il ne peut pas y avoir de personnes avec des pipettes dans un centre de données, car cette approche présente un trop grand risque d'erreur humaine, elle est trop coûteuse et nécessite trop d'espace », a expliqué Takahashi.

Pour que cette méthode de stockage de données ait un sens sur le plan commercial, il est nécessaire de réduire les coûts tant pour la synthèse de l'ADN - la création de blocs de construction fondamentaux avec des séquences significatives - que pour le processus de séquençage nécessaire à la lecture des informations stockées. Les chercheurs disent que des avancées se font dans ce domaine. .
Selon les chercheurs de Microsoft, l'automatisation est une autre pièce maîtresse de ce puzzle, permettant d'organiser le stockage de données à l'échelle commerciale et de le rendre plus accessible.
Sous certaines conditions, l'ADN peut exister beaucoup plus longtemps que les moyens de stockage archivistique modernes, qui se dégradent en quelques décennies. Certaines ADN ont réussi à se conserver dans des conditions loin d'être idéales pendant des dizaines de milliers d'années - dans des dents de mammouth et des os d'hommes préhistoriques. Cela signifie qu'il est possible de stocker des données de cette manière tant que l'humanité existe.
Le système automatisé de stockage des données ADN utilise un logiciel développé par des spécialistes de Microsoft et de l'Université de Washington (UW). Il transforme des unités et des zéros de données numériques en séquences de nucléotides (A, T, C et G), qui représentent les « blocs de construction » de l'ADN. Ensuite, le système utilise du matériel de laboratoire standard à faible coût pour fournir les liquides et réactifs nécessaires au synthétiseur, qui assemble les fragments d'ADN fabriqués et les place dans un contenant de stockage.
Lorsque le système a besoin d'extraire des informations, il ajoute d'autres substances chimiques pour préparer correctement l'ADN et utilise des pompes microfluidiques pour pousser les liquides dans les parties du système qui lisent les séquences de molécules d'ADN et les convertissent à nouveau en informations compréhensibles pour l'ordinateur. Les chercheurs affirment que l'objectif du projet n'était pas de prouver que le système peut fonctionner rapidement ou à moindre coût, mais simplement de montrer que l'automatisation est possible.
L'un des avantages les plus évidents du système automatisé de stockage de l'ADN est qu'il libère les scientifiques pour s'attaquer à des problèmes plus complexes, leur permettant de ne pas perdre de temps à chercher des flacons de réactifs ou à ajouter monotoniquement des gouttes de liquide dans des tubes à essai.
« Avoir un système automatisé pour exécuter des tâches répétitives permet aux membres du laboratoire de se concentrer sur la recherche, de développer de nouvelles stratégies pour introduire des innovations plus rapidement », a déclaré le chercheur de Microsoft Bihlin Nguyen.
Équipe du Laboratoire des systèmes d'information moléculaire (MISL) a déjà démontré qu'elle peut stocker des photos de chatons, de remarquables œuvres littéraires, et des enregistrements d'archives dans l'ADN et extraire ces fichiers sans erreur. À ce jour, ils ont réussi à conserver 1 gigaoctet de données dans l'ADN, battant .
Les chercheurs ont également développé des méthodes pour , tels que la recherche et l'extraction uniquement d'images contenant une pomme ou un vélo vert, en utilisant les molécules elles-mêmes, sans reconvertir les fichiers en format numérique.
«On peut affirmer avec confiance que nous assistons à la naissance d'un nouveau type de système informatique, dans lequel les molécules sont utilisées pour le stockage des données, tandis que l'électronique sert à la gestion et au traitement. Cette combinaison ouvre des perspectives très intéressantes pour l'avenir», a déclaré le professeur de l'école Allen de l'université de Washington. .
Contrairement aux systèmes de calcul basés sur des composants en silicium, les systèmes de stockage et de calcul basés sur l'ADN doivent utiliser des liquides pour déplacer les molécules. Mais les liquides diffèrent fondamentalement des électrons et nécessitent des solutions techniques complètement nouvelles.
L'équipe de l'université de Washington, en collaboration avec Microsoft, développe également un système programmable qui automatise les expériences de laboratoire en utilisant les propriétés de l'électricité et de l'eau pour déplacer des gouttes sur une grille d'électrodes. L'ensemble complet de logiciels et de matériel a reçu les noms , capable de mélanger, séparer, chauffer ou refroidir différents liquides et d'exécuter des protocoles de laboratoire.
L'objectif est d'automatiser les expériences de laboratoire qui sont actuellement réalisées manuellement ou par des robots coûteux travaillant avec des liquides, et de réduire les coûts.
Les prochaines étapes pour l'équipe MISL incluent l'intégration d'un système automatisé simple avec des technologies comme Purple Drop, ainsi qu'avec d'autres technologies permettant de rechercher dans les molécules d'ADN. Les chercheurs ont spécifiquement conçu leur système automatisé de manière modulaire afin qu'il puisse évoluer avec l'émergence de nouvelles technologies pour la synthèse, le séquençage et le travail sur l'ADN.
«Un des avantages de ce système est que si nous voulons remplacer une partie par quelque chose de nouveau, de plus performant ou de plus rapide, nous pouvons simplement connecter la nouvelle pièce», a déclaré Nguyen. «Cela nous donne une grande flexibilité pour l'avenir».
Image en haut : des chercheurs de Microsoft et de l'université de Washington ont enregistré et lu le mot «hello», en utilisant le premier système de stockage de données entièrement automatisé basé sur l'ADN. C'est une étape clé pour transférer cette nouvelle technologie des laboratoires vers des centres de données commerciaux.
Source : habr.com
