

Annonce
Collègues, au milieu de l'été, je prévois de publier un autre cycle d'articles sur la conception de systèmes de service de masse : « Expérience VTrade » — une tentative d'écrire un cadre pour les systèmes de trading. Le cycle abordera la théorie et la pratique de la construction d'une bourse, d'une enchère et d'un magasin. À la fin de l'article, je vous propose de voter pour les sujets qui vous intéressent le plus.
C'est le dernier article de la série sur les applications réactives distribuées en Erlang/Elixir. Dans vous pouvez trouver les bases théoriques de l'architecture réactive. illustre les principaux modèles et mécanismes de construction de tels systèmes.
Aujourd'hui, nous aborderons les questions du développement de la base de code et des projets dans leur ensemble.
Organisation des services
Dans la vie réelle, lors de la conception d'un service, on doit souvent combiner plusieurs modèles d'interaction dans un seul contrôleur. Par exemple, le service users, qui s'occupe de la gestion des profils utilisateurs du projet, doit répondre aux requêtes req-resp et informer des mises à jour de profils via pub-sub. Ce cas est assez simple : un contrôleur gère le messaging, implémentant la logique du service et publiant les mises à jour.
La situation se complique lorsque nous devons mettre en place un service distribué tolérant aux pannes. Imaginons que les exigences relatives aux users aient changé :
- maintenant, le service doit traiter les requêtes sur 5 nœuds du cluster,
- avoir la capacité d'exécuter des tâches de traitement en arrière-plan,
- et aussi être capable de gérer dynamiquement les listes d'abonnement aux mises à jour de profils.
Remarque : Nous ne discutons pas de la question du stockage cohérent et de la réplication des données. Supposons que ces questions aient été résolues au préalable et qu'il existe déjà dans le système une couche de stockage fiable et évolutive, et que les gestionnaires aient des mécanismes pour interagir avec elle.
La description formelle du service users est devenue plus complexe. Du point de vue du programmeur, grâce à l'utilisation du messaging, les changements sont minimes. Pour satisfaire à la première exigence, nous devons configurer la répartition à la point d'échange req-resp.
La nécessité de traiter des tâches en arrière-plan se présente souvent. Dans les utilisateurs, cela peut inclure des vérifications de documents des utilisateurs, le traitement de multimédias téléchargés ou la synchronisation des données avec les réseaux sociaux. Ces tâches doivent être réparties au sein du cluster et leur progression contrôlée. Nous avons donc deux options : soit utiliser le modèle de répartition des tâches de l'article précédent, soit, si cela ne convient pas, écrire un planificateur de tâches personnalisé qui gérera le pool de travailleurs comme nécessaire.
Le point 3 nécessite une extension du modèle pub-sub. Pour cela, après avoir créé un point d'échange pub-sub, nous devons également démarrer le contrôleur de ce point dans notre service. Ainsi, nous extrayons la logique de gestion des abonnements et des désabonnements de la couche de messagerie vers l'implémentation des utilisateurs.
En fin de compte, la décomposition de la tâche a montré qu'afin de satisfaire les exigences, nous devions lancer 5 instances du service sur différents nœuds et créer une entité supplémentaire - un contrôleur pub-sub responsable des abonnements.
Pour lancer 5 travailleurs, il n'est pas nécessaire de modifier le code du service. La seule action supplémentaire consiste à configurer les règles d'équilibrage au point d'échange, ce dont nous discuterons un peu plus tard.
Une complexité supplémentaire est également apparue : le contrôleur pub-sub et le planificateur de tâches personnalisé doivent fonctionner en une seule instance. Encore une fois, le service de messagerie, en tant que fondamental, doit fournir un mécanisme de choix d'un leader.
Choix du leader
Dans les systèmes distribués, le choix d'un leader est la procédure d'attribution d'un seul processus responsable de la planification du traitement distribué d'une charge donnée.
Dans les systèmes peu enclins à la centralisation, des algorithmes universels et des algorithmes basés sur le consensus, tels que paxos ou raft, sont utilisés.
Étant donné que la messagerie est un courtier et un élément central, elle connaît tous les contrôleurs de service - candidats au leadership. La messagerie peut désigner un leader sans vote.
Tous les services, après leur démarrage et leur connexion au point d'échange, reçoivent un message système #'$leader'{exchange = ?EXCHANGE, pid = LeaderPid, servers = Servers}. Dans le cas où LeaderPid coïncide avec pid le processus actuel, il est désigné comme leader, et la liste Servers comprend tous les nœuds et leurs paramètres.
Lorsqu'un nouveau nœud de cluster est ajouté et qu'un nœud fonctionnel est désactivé, tous les contrôleurs de service reçoivent #'$slave_up'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} et #'$slave_down'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} respectivement.
Ainsi, tous les composants sont au courant de tous les changements, et dans le cluster, il y a toujours un leader assuré à tout moment.
Intermédiaires
Pour mettre en œuvre des processus de traitement distribués complexes, ainsi que pour optimiser une architecture existante, il est pratique d'utiliser des intermédiaires.
Pour ne pas modifier le code des services et résoudre, par exemple, des tâches de traitement supplémentaire, de routage ou de journalisation des messages, un gestionnaire proxy peut être intégré devant le service, qui effectuera tout le travail supplémentaire.
Un exemple classique d'optimisation pub-sub est une application distribuée avec un noyau métier générant des événements de mise à jour, comme un changement de prix sur le marché, et une couche d'accès — N serveurs fournissant une API websocket pour les clients web.
Si l'on considère la situation de manière directe, le service client se déroule comme suit :
- le client établit une connexion avec la plateforme. Du côté du serveur, qui termine le trafic, un processus est démarré pour gérer cette connexion.
- dans le contexte du processus de service, une autorisation et une inscription aux mises à jour se produisent. Le processus appelle la méthode subscribe pour les sujets.
- après la génération de l'événement dans le noyau, il est livré aux processus gérant les connexions.
Imaginons que nous ayons 50000 abonnés au sujet "news". Les abonnés sont répartis de manière uniforme sur 5 serveurs. En fin de compte, chaque mise à jour, arrivée à un point d'échange, sera répliquée 50000 fois : 10000 fois sur chaque serveur, selon le nombre d'abonnés sur celui-ci. Pas une méthode très efficace, n'est-ce pas ?
Pour améliorer la situation, introduisons un proxy qui a le même nom que le point d'échange. Le registrateur de noms globaux doit être capable de renvoyer le processus le plus proche par nom, c'est important.
Lançons ce proxy sur les serveurs de la couche d'accès, et tous nos processus gérant l'API websocket s'abonneront à lui, et non au point d'échange pub-sub d'origine dans le noyau. Le proxy s'abonne au noyau uniquement en cas d'abonnement unique et réplique le message reçu à tous ses abonnés.
En fin de compte, 5 messages seront transmis entre le noyau et les serveurs d'accès, au lieu de 50000.
Routage et équilibrage
Req-Resp
Dans l'implémentation actuelle de la messagerie, il existe 7 stratégies de répartition des requêtes :
default. La demande est envoyée à tous les contrôleurs.round-robin. Un parcours est effectué et les demandes sont distribuées cycliquement entre les contrôleurs.consensus. Les contrôleurs qui gèrent le service se divisent en un leader et des suiveurs. Les demandes sont uniquement envoyées au leader.consensus & round-robin. Il y a un leader dans le groupe, mais les demandes sont réparties entre tous les membres.sticky. Une fonction de hachage est calculée et attachée à un gestionnaire spécifique. Les demandes suivantes avec cette signature vont à ce même gestionnaire.sticky-fun. Lors de l'initialisation du point d'échange, une fonction de calcul de hachage est en outre fournie pourstickyl'équilibrage.fun. Semblable à sticky-fun, mais permet également de rediriger, de rejeter ou de prétraiter.
La stratégie de distribution est définie lors de l'initialisation du point d'échange.
Outre l'équilibrage, la messagerie permet de taguer les entités. Examinons les types de tags dans le système :
- Tag de connexion. Permet de comprendre par quelle connexion les événements sont arrivés. Utilisé lorsque le processus du contrôleur se connecte à un point d'échange unique, mais avec différentes clés de routage.
- Tag de service. Permet de regrouper des gestionnaires pour un service et d'élargir les possibilités de routage et d'équilibrage. Pour le modèle req-resp, le routage est linéaire. Nous envoyons une demande au point d'échange, puis elle la transmet au service. Mais si nous devons diviser les gestionnaires en groupes logiques, cela se fait à l'aide de tags. Lorsqu'un tag est spécifié, la demande sera dirigée vers un groupe particulier de contrôleurs.
- Tag de demande. Permet de distinguer les réponses. Étant donné que notre système est asynchrone, pour traiter les réponses du service, il est nécessaire de spécifier RequestTag lors de l'envoi de la demande. Grâce à cela, nous pourrons comprendre à quelle demande la réponse reçue correspond.
Pub-sub
Pour le pub-sub, c'est un peu plus simple. Nous avons un point d'échange où les messages sont publiés. Le point d'échange répartit les messages entre les abonnés qui se sont inscrits aux clés de routage qui les concernent (on peut dire que c'est l'analogue des sujets).
Scalabilité et résilience
La scalabilité du système dans son ensemble dépend du degré de scalabilité des couches et des composants du système :
- Les services se développent en ajoutant des nœuds supplémentaires avec des gestionnaires de ce service au cluster. Dans le cadre d'une exploitation expérimentale, il est possible de choisir la politique d'équilibrage optimale.
- Le service de messagerie lui-même, au sein d'un cluster distinct, se développe généralement soit en déplaçant des points d'échange particulièrement chargés vers des nœuds séparés du cluster, soit en ajoutant des processus proxy dans les zones les plus sollicitées du cluster.
- La scalabilité de l'ensemble du système en tant que caractéristique dépend de la flexibilité de l'architecture et de la capacité à unir des clusters distincts en une entité logique commune.
La simplicité et la rapidité de la scalabilité sont souvent déterminantes pour le succès d'un projet. La messagerie, dans sa forme actuelle, croît avec l'application. Même si nous manquons d'un cluster de 50 à 60 machines, nous pouvons recourir à la fédération. Malheureusement, la question de la fédération dépasse le cadre de cet article.
Redondance
Lors de l'examen de l'équilibrage de la charge, nous avons déjà discuté de la redondance des contrôleurs de services. Cependant, la messagerie doit également être redondée. En cas de défaillance d'un nœud ou d'une machine, la messagerie doit se rétablir automatiquement, et ce dans les plus brefs délais.
Dans mes projets, j'utilise des nœuds supplémentaires qui prennent en charge la charge en cas de défaillance. En Erlang, il existe une implémentation standard du mode distribué pour les applications OTP. Le mode distribué réalise justement la récupération en cas de panne en lançant l'application tombée sur un autre nœud préalablement actif. Le processus est transparent, après la panne, l'application est automatiquement transférée sur le nœud de secours. Vous pouvez lire plus sur cette fonctionnalité. .
Performance
Essayons d'au moins comparer approximativement les performances de rabbitmq et de notre messagerie personnalisée.
J'ai trouvé des tests de rabbitmq par l'équipe openstack.
Au point 6.14.1.2.1.2.2. du document original, le résultat du RPC CAST est présenté :
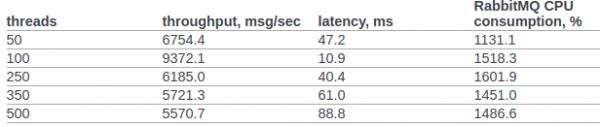
Préalablement, nous ne ferons aucune configuration supplémentaire dans le noyau OS ou l'ERLANG VM. Conditions de test :
- erl opts: +A1 +sbtu.
- Le test sur un seul nœud Erlang est exécuté sur un ordinateur portable avec un ancien i7 en version mobile.
- Les tests de cluster se déroulent sur des serveurs avec un réseau 10G.
- Le code fonctionne dans des conteneurs Docker. Réseau en mode NAT.
Code du test :
req_resp_bench(_) ->
  W = perftest:comprehensive(10000,
    fun() ->
      messaging:request(?EXCHANGE, default, ping, self()),
      receive
        #'$msg'{message = pong} -> ok
      after 5000 ->
        throw(timeout)
      end
    end
  ),
  true = lists:any(fun(E) -> E >= 30000 end, W),
  ok.
Scénario 1: Le test est exécuté sur un ordinateur portable avec un ancien i7 mobile. Le test, la messagerie et le service s'exécutent sur un seul nœud dans un même conteneur Docker :
Cycles séquentiels de 10000 en ~0 secondes (26987 cycles/s)
Cycles séquentiels de 20000 en ~1 seconde (26915 cycles/s)
Cycles séquentiels de 100000 en ~4 secondes (26957 cycles/s)
Parallèle 2 100000 cycles en ~2 secondes (44240 cycles/s)
Parallèle 4 100000 cycles en ~2 secondes (53459 cycles/s)
Parallèle 10 100000 cycles en ~2 secondes (52283 cycles/s)
Parallèle 100 100000 cycles en ~3 secondes (49317 cycles/s)
Scénario 2: 3 nœuds lancés sur différentes machines sous Docker (NAT).
Cycles séquentiels de 10000 en ~1 seconde (8684 cycles/s)
Cycles séquentiels de 20000 en ~2 secondes (8424 cycles/s)
Cycles séquentiels de 100000 en ~12 secondes (8655 cycles/s)
Parallèle 2 100000 cycles en ~7 secondes (15160 cycles/s)
Parallèle 4 100000 cycles en ~5 secondes (19133 cycles/s)
Parallèle 10 100000 cycles en ~4 secondes (24399 cycles/s)
Parallèle 100 100000 cycles en ~3 secondes (34517 cycles/s)
Dans tous les cas, l'utilisation du CPU n'a pas dépassé 250%
Résultats
J'espère que ce cycle ne ressemble pas à un déversement de conscience et que mon expérience apportera une réelle valeur tant aux chercheurs en systèmes distribués qu'aux praticiens qui commencent à construire des architectures distribuées pour leurs systèmes d'entreprise et qui s'intéressent à Erlang/Elixir, mais doutent de l'opportunité...
Photo
Seuls les utilisateurs enregistrés peuvent participer au sondage. , s'il vous plaît.
Quels sujets devrais-je couvrir plus en détail dans le cadre du cycle « Expérience VTrade » ?
Théorie : Marchés, ordres et durée de leur validité : DAY, GTD, GTC, IOC, FOK, MOO, MOC, LOO, LOC
Livre d'ordres. Théorie et pratique de la réalisation d'un livre avec des regroupements
Visualisation des échanges : Tick, barres, résolutions. Comment stocker et comment assembler
Back-office. Planification et développement. Contrôle des employés et enquête sur les incidents
API. Analysons quels interfaces sont nécessaires et comment les mettre en œuvre
Stockage des informations : PostgreSQL, Timescale, Tarantool dans les systèmes de trading
Réactivité dans les systèmes de trading
Autre. J'écrirai dans les commentaires
6 utilisateurs ont voté. 4 utilisateurs se sont abstenus.
Source : habr.com
