

Aujourd'hui, la plupart des produits logiciels sont développés en équipes. Les conditions de succès du développement en équipe peuvent être représentées sous la forme d'un schéma simple.
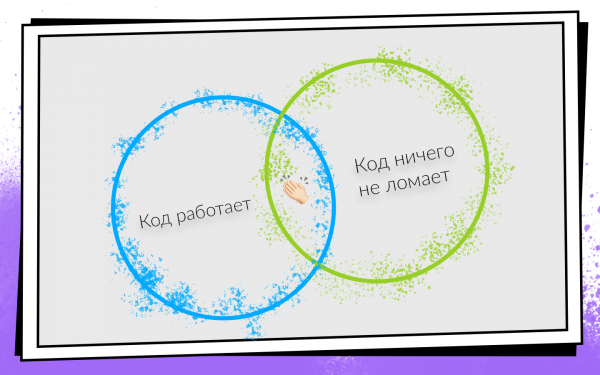
Après avoir écrit le code, vous devez vous assurer qu'il :
- Fonctionne.
- Ne casse rien, y compris le code écrit par vos collègues.
Si ces deux conditions sont remplies, vous êtes sur la voie du succès. Pour vérifier facilement ces conditions et ne pas dévier d'une voie avantageuse, l'intégration continue a été conçue.
L'intégration continue (CI) est un processus de travail où vous intégrez votre code dans le code principal du produit aussi souvent que possible. Et pas seulement l'intégrez, mais vérifiez également constamment que tout fonctionne. Comme il y a beaucoup à vérifier et souvent, il vaut la peine de penser à l'automatisation. Vous pouvez tout vérifier manuellement, mais ce n'est pas recommandé, et voici pourquoi.
- Les gens sont chers. Une heure de travail de tout programmeur coûte plus cher qu'une heure de travail de n'importe quel serveur.
- Les gens font des erreurs. Par conséquent, il peut se produire des situations où des tests sont lancés sur la mauvaise branche ou où un mauvais commit est assemblé pour les testeurs.
- Les gens sont paresseux. Parfois, quand je termine une tâche, je me dis : « Pourquoi vérifier ? J'ai écrit deux lignes, ça fonctionne sûrement ! » Je pense que certains d'entre vous ont aussi ces pensées de temps en temps. Mais il est toujours nécessaire de vérifier.
Comment l'intégration continue a été mise en œuvre et développée dans l'équipe de développement mobile d'Avito, comment on est passé de 0 à 450 builds par jour, et ce que les machines de build assemblent pendant 200 heures par jour, raconte Nikolai Nesterov () — participant à tous les changements évolutifs des CI/CD de l'application Android.
Le récit est basé sur l'exemple de l'équipe Android, mais la plupart des approches sont également applicables à iOS.
Il y a longtemps, dans l'équipe Android d'Avito, il travaillait une seule personne. Par définition, il n'avait besoin de rien en matière d'intégration continue : il n'y avait personne avec qui s'intégrer.
Mais l'application a grandi, de plus en plus de nouvelles tâches apparaissaient, et par conséquent, l'équipe s'est agrandie. À un certain moment, il est devenu essentiel de formaliser davantage le processus d'intégration du code. Il a été décidé d'utiliser le Git flow.
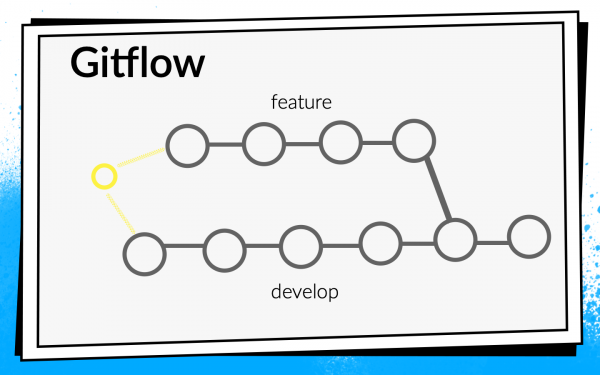
Le concept de Git flow est bien connu : dans un projet, il y a une branche principale develop, et pour chaque nouvelle fonctionnalité, les développeurs créent une branche distincte, y effectuent des commits, poussent, et lorsqu'ils souhaitent intégrer leur code dans la branche develop, ils ouvrent une pull request. Pour favoriser l'échange de connaissances et discuter des approches, nous avons introduit le code review, ce qui signifie que les collègues doivent vérifier et valider le code des autres.
Vérifications
Regarder le code à travers les yeux d'un autre est génial, mais ce n'est pas suffisant. C'est pourquoi des vérifications automatiques sont mises en place.
- Tout d'abord, nous vérifions la construction ARC.
- Beaucoup de tests Junit.
- Nous calculons la couverture de code, puisque nous lançons des tests.
Pour comprendre comment ces vérifications doivent être lancées, examinons le processus de développement chez Avito.
Schématiquement, on peut le représenter ainsi :
- Le développeur écrit du code sur son ordinateur portable. Il peut lancer des vérifications d'intégration directement ici — soit par hook de commit, soit en exécutant simplement des vérifications en arrière-plan.
- Après que le développeur ait poussé le code, il ouvre une pull request. Pour que son code soit intégré dans la branche develop, il doit passer le code review et obtenir un nombre suffisant de validations. Il est possible d'activer les vérifications et les builds ici : tant que tous les builds ne sont pas réussis, la pull request ne peut pas être fusionnée.
- Une fois la pull request fusionnée et le code intégré dans develop, on peut choisir un moment opportun : par exemple, la nuit, lorsque tous les serveurs sont disponibles, et exécuter autant de vérifications que possible.
Lancer des vérifications sur son ordinateur portable n'a plu à personne. Lorsqu'un développeur a terminé une fonctionnalité, il veut la pousser rapidement et ouvrir une pull request. Si, à ce moment-là, des vérifications longues sont lancées, cela est non seulement désagréable, mais cela ralentit aussi le développement : tant que l'ordinateur portable effectue des vérifications, il est impossible de travailler normalement.
Lancer des vérifications la nuit nous a beaucoup plu, car il y a beaucoup de temps et de serveurs, on peut en profiter. Mais, malheureusement, une fois que le code de la fonctionnalité a été intégré dans develop, le développeur a déjà beaucoup moins de motivation pour corriger les erreurs que le CI a détectées. Je me surprenais parfois à penser, en consultant le rapport du matin sur toutes les erreurs trouvées, que je ferais les corrections plus tard, car il y a une super nouvelle tâche dans Jira que j'ai envie de commencer dès que possible.
Si les vérifications bloquent la pull request, il y a suffisamment de motivation, car tant que les builds ne sont pas au vert, le code ne pourra pas être intégré dans develop, et donc la tâche ne sera pas terminée.
En fin de compte, nous avons choisi une stratégie : la nuit, nous exécutons autant de vérifications que possible, et les plus critiques, et surtout les plus rapides, sont lancées sur le pull request. Mais nous ne nous arrêtons pas là — nous optimisons également la vitesse des vérifications afin de les transférer du mode nocturne aux vérifications sur pull request.
À ce moment-là, toutes nos compilations passaient assez rapidement, donc nous avons simplement ajouté un bloqueur à la compilation du pull request : ARK, tests Junit et calcul de la couverture de code. Nous avons activé cela, réfléchi — et avons renoncé à la couverture de code, car nous avons estimé que nous n'en avions pas besoin.
Nous avons mis deux jours pour configurer le CI de base (ici et par la suite, l'évaluation temporelle est approximative, nécessaire pour le contexte).
Après cela, nous avons commencé à réfléchir : vérifions-nous correctement ? Est-ce que nous lançons les builds sur le pull request de manière adéquate ?
Nous lancions la compilation sur le dernier commit de la branche d'où était ouvert le pull request. Mais les vérifications de ce commit ne montrent que le code que le développeur a écrit fonctionne. Elles ne prouvent pas qu'il n'a rien cassé. En réalité, il faut vérifier l'état de la branche develop après l'intégration de la fonctionnalité.
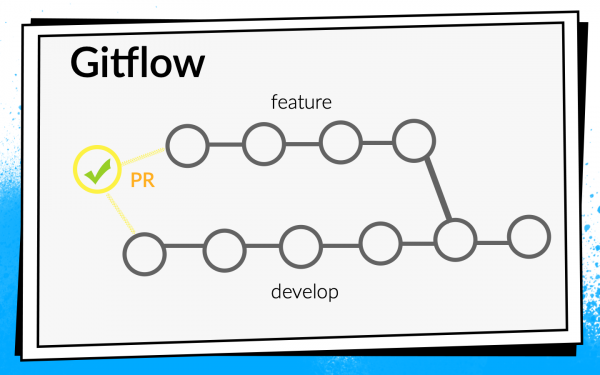
Pour cela, nous avons écrit un simple script bash. premerge.sh :
#!/usr/bin/env bash

set -e

git fetch origin develop

git merge origin/develop
Ici, nous récupérons simplement tous les changements les plus récents de develop et les fusionnons dans la branche actuelle. Nous avons ajouté le script premerge.sh comme première étape de tous les builds et avons commencé à vérifier exactement ce que nous voulions, c'est-à-dire l'intégration.
Pour localiser les problèmes, trouver des solutions et rédiger ce script, nous avons mis trois jours.
L'application évoluait, de plus en plus de tâches apparaissaient, l'équipe grandissait, et premerge.sh a parfois commencé à nous poser problème. Des modifications conflictuelles pénétraient dans develop, ce qui cassait la compilation.
Voici un exemple de comment cela se produit :
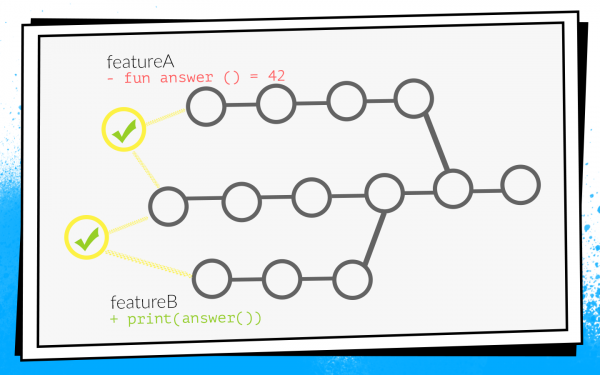
Deux développeurs commencent en même temps à travailler sur les fonctionnalités A et B. Le développeur de la fonctionnalité A découvre dans le projet une fonction inutilisée answer() et, bon scout, la supprime. En même temps, le développeur de la fonctionnalité B dans sa branche ajoute un nouvel appel à cette fonction.
Les développeurs terminent leur travail et ouvrent en même temps leur pull request. Les builds se lancent, premerge.sh vérifie les deux pull requests par rapport à l'état frais de develop — tous les tests sont verts. Ensuite, le pull request de la fonctionnalité A est fusionné, le pull request de la fonctionnalité B est fusionné… Boom ! Develop casse, car le code de develop contient un appel à une fonction inexistante.
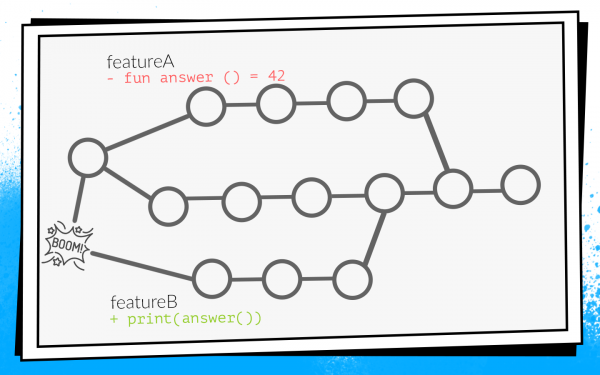
Quand develop ne compile pas, cela désastre local. Toute l'équipe ne peut rien recueillir et soumettre pour test.
Il se trouve que je m'occupais le plus souvent de tâches d'infrastructure : analytique, réseau, bases de données. C'est-à-dire que c'était moi qui écrivais les fonctions et classes utilisées par d'autres développeurs. En conséquence, je me suis souvent retrouvé dans ce genre de situations. J'avais même une image qui traînait un moment.
Comme cela ne nous convenait pas, nous avons commencé à réfléchir à des options pour prévenir cela.
Comment ne pas casser develop
Première option : recompiler toutes les pull requests lors de la mise à jour de develop. Si dans notre exemple la pull request avec la fonctionnalité A arrive en premier dans develop, la pull request de la fonctionnalité B sera recompilée, et ainsi, les vérifications échoueront à cause d'une erreur de compilation.
Pour comprendre combien de temps cela prendra, regardons un exemple avec deux PR. Ouvrons deux PR : deux builds, deux lancements de vérifications. Après que la première PR soit intégrée dans develop, la seconde doit être recompilée. Au total, pour deux PR, il faut trois lancements de vérifications : 2 + 1 = 3.
En principe, c'est normal. Mais nous avons regardé les statistiques et la situation typique dans notre équipe était d'avoir 10 PR ouvertes, ce qui signifie que le nombre de vérifications est la somme d'une progression : 10 + 9 +… + 1 = 55. Donc, pour accepter 10 PR, il faut recompiler 55 fois. Et cela dans une situation idéale, où toutes les vérifications passent du premier coup, où personne n'ouvre de pull request supplémentaire pendant le traitement de cette dizaine.
Imaginez-vous en tant que développeur, à qui il faut appuyer sur le bouton « merge » en premier, parce que si c'est le voisin qui le fait, il faudra attendre que toutes les compilations passent à nouveau... Non, ça ne va pas, cela ralentira sérieusement le développement.
Deuxième méthode possible : compiler les pull requests après la révision du code. C'est-à-dire que vous ouvrez la pull request, recueillez le nombre nécessaire d'approbations de la part des collègues, corrigez ce qui doit être corrigé, après cela vous lancez les builds. S'ils réussissent, la pull request est fusionnée avec develop. Dans ce cas, il n'y a pas de redémarrages supplémentaires, mais cela ralentit considérablement le retour d'information. En tant que développeur, lorsque j'ouvre une pull request, je veux immédiatement voir si elle se compile. Par exemple, si un test échoue, il faut le réparer rapidement. Dans le cas d'une compilation différée, le retour d'information est ralenti, ce qui ralentit toute la production. Cela ne nous convenait pas non plus.
Au final, seule la troisième option reste — réinventer la roue. Tout notre code, tous nos fichiers sources sont stockés dans un dépôt sur le serveur Bitbucket. Par conséquent, nous avons dû développer un plugin pour Bitbucket.
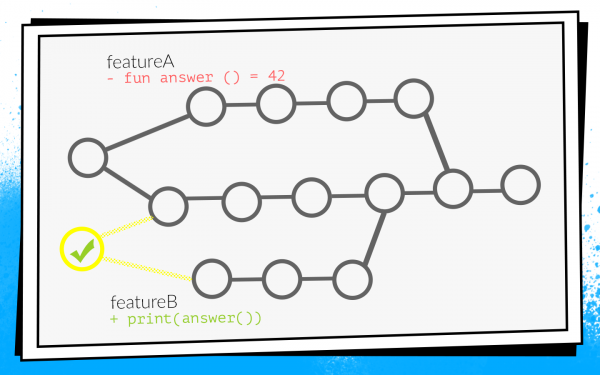
Ce plugin redéfinit le mécanisme de fusion des pull requests. Au départ, le processus est standard : un PR est ouvert, toutes les builds sont lancées, et une revue de code est effectuée. Mais après que la revue de code soit terminée et que le développeur décide de cliquer sur « merge », le plugin vérifie sur quel état de develop les tests ont été exécutés. Si develop a été mis à jour après les builds, le plugin n’autorisera pas la fusion de ce pull request dans la branche principale. Il relancera simplement les builds par rapport au dernier develop.
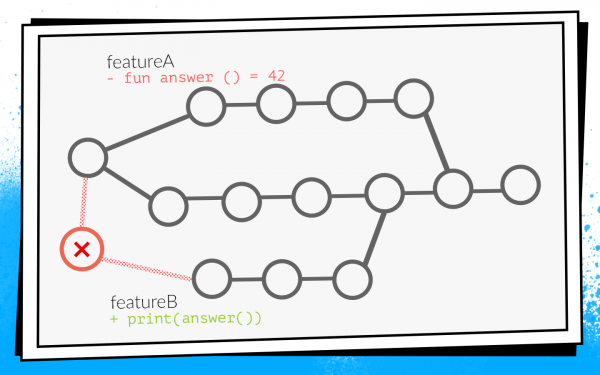
Dans notre exemple avec les modifications conflictuelles, de telles builds échoueront en raison d'une erreur de compilation. Par conséquent, le développeur de la fonctionnalité B devra corriger le code, relancer les tests, et alors le plugin appliquera automatiquement le pull request.
Avant l'implémentation de ce plugin, nous avions en moyenne 2,7 lancements de tests par pull request. Avec le plugin, cela est passé à 3,6 lancements. Cela nous convenait.
Il convient de noter que ce plugin a un inconvénient : il relance la build uniquement une fois. Il existe donc une petite fenêtre pendant laquelle des modifications conflictuelles peuvent pénétrer dans develop. Mais la probabilité de cela est faible, et nous avons accepté ce compromis entre le nombre de lancements et la probabilité de rupture. Cela n’est arrivé qu'une seule fois en deux ans, donc probablement ce n'était pas pour rien.
L'écriture de la première version du plugin pour Bitbucket nous a pris deux semaines.
Nouveaux tests
Entre-temps, notre équipe continuait de croître. De nouveaux tests étaient ajoutés.
Nous avons pensé : pourquoi corriger des erreurs si nous pouvons les prévenir ? C'est pourquoi nous avons implémenté une analyse de code statique. Nous avons commencé avec lint, qui fait partie de l'Android SDK. Mais à l'époque, il ne savait pas du tout travailler avec du code Kotlin, et 75 % de notre application était déjà écrite en Kotlin. Donc, lint a été complété par des vérifications intégrées d'Android Studio.
Pour cela, nous avons dû beaucoup nous creuser la tête : prendre Android Studio, l'emballer dans un Docker et l'exécuter sur CI avec un moniteur virtuel, afin qu'elle pense qu'elle était lancée sur un véritable ordinateur portable. Mais cela fonctionnait.
En même temps, nous avons commencé à écrire beaucoup de tests d'instrumentation et avons implémenté des tests de capture d'écranC'est le moment où une capture d'écran de référence est générée pour une petite vue distincte, et le test consiste à prendre une capture d'écran de cette vue et à la comparer pixel par pixel avec la référence. S'il y a une divergence, cela signifie que le design a été perturbé quelque part ou que quelque chose ne va pas dans les styles.
Mais les tests d'instrumentation et les tests de capture d'écran doivent être exécutés sur des appareils : sur des émulateurs ou sur des appareils réels. Étant donné qu'il y a beaucoup de tests et qu'ils sont souvent exécutés, il faut toute une ferme. Créer sa propre ferme est trop coûteux en termes de ressources, c'est pourquoi nous avons trouvé une solution prête à l'emploi : Firebase Test Lab.
Firebase Test Lab
A été choisi parce que Firebase est un produit de Google, donc il doit être fiable et il est peu probable qu'il disparaisse un jour. Les prix sont abordables : 5 $ par heure d'utilisation d'un appareil réel, 1 $ par heure pour un émulateur.
L'implémentation de Firebase Test Lab dans notre CI a pris environ trois semaines.
Mais l'équipe continuait de grandir, et Firebase a malheureusement commencé à nous poser problème. À ce moment-là, il n'y avait aucun SLA. Parfois, Firebase nous faisait attendre jusqu'à ce que le nombre requis d'appareils pour les tests soit disponible, au lieu de commencer immédiatement, comme nous le souhaitions. L'attente dans la file pouvait prendre jusqu'à une demi-heure, ce qui est très long. Les tests d'instrumentation étaient exécutés à chaque PR, et ces retards ralentissaient vraiment le développement, puis est venu le compte pour le mois avec un montant élevé. En résumé, il a été décidé d'abandonner Firebase et de développer en interne, puisque l'équipe avait suffisamment grandi.
Docker + Python + bash
Nous avons pris Docker, y avons intégré des émulateurs, et écrit un petit programme en Python qui à tout moment déclenche le nombre nécessaire d'émulateurs dans la version voulue et les arrête quand il le faut. Et, bien sûr, quelques scripts bash — que serait-on sans eux ?
La création de notre propre environnement de test a demandé cinq semaines.
En conséquence, chaque pull request avait une liste de vérifications étendue et bloquante pour la fusion :
- Compilation ARK ;
- Tests Junit ;
- Lint ;
- Vérifications Android Studio ;
- Tests d'instrumentation ;
- Tests de capture d'écran.
Cela a permis d'éviter de nombreuses pannes possibles. Techniquement, tout fonctionnait, mais les développeurs se plaignaient d'attendre trop longtemps les résultats.
Trop longtemps, c'est combien ? Nous avons extrait des données de Bitbucket et TeamCity dans le système d'analyse et nous avons constaté que le temps d'attente moyen est de 45 minutes. Donc, un développeur, en ouvrant une pull request, attend en moyenne les résultats des builds pendant 45 minutes. À mon avis, c'est beaucoup trop, et il est inacceptable de travailler de cette manière.
Bien sûr, nous avons décidé d'accélérer tous nos builds.
Nous nous réorganisons
En voyant que les builds restaient souvent en attente, nous avons d'abord acheté du matériel supplémentaire — le développement extensif est le plus simple. Les builds ne sont plus à l'arrêt, mais le temps d'attente a diminué seulement légèrement, car certaines vérifications prenaient encore beaucoup de temps.
Nous éliminons les vérifications trop longues
Notre intégration continue peut attraper ce type d'erreurs et de problèmes.
- Ça ne compile pas. CI peut détecter une erreur de compilation lorsque, à cause de changements conflictuels, quelque chose ne compile pas. Comme je l'ai déjà mentionné, à ce moment-là, personne ne peut rien compiler, le développement s'arrête, et tout le monde devient nerveux.
- Bug de comportement. Par exemple, lorsque l'application compile, mais se plante en appuyant sur un bouton, ou que le bouton ne fonctionne tout simplement pas. C'est problématique, car ce genre de bug peut atteindre l'utilisateur.
- Bug de mise en page. Par exemple, le bouton fonctionne, mais a décalé de 10 pixels vers la gauche.
- Augmentation de la dette technique.
En regardant cette liste, nous avons réalisé que seuls les deux premiers points étaient critiques. Nous voulons détecter ces problèmes en priorité. Les bugs de mise en page sont identifiés lors de l'étape de design-review et peuvent être facilement corrigés à ce moment-là. Travailler sur la dette technique demande un processus et une planification distincts, c'est pourquoi nous avons décidé de ne pas le vérifier sur pull request.
En nous basant sur cette classification, nous avons passé en revue toute la liste de vérifications. Nous avons rayé Lint et avons déplacé son lancement à la nuit : juste pour qu'il produise un rapport sur le nombre de problèmes dans le projet. Nous avons convenu de travailler séparément sur la dette technique, et nous avons complètement abandonné les vérifications d'Android Studio. Android Studio dans Docker pour exécuter les inspections semble intéressant, mais cela entraîne beaucoup de désagréments en matière de maintenance. Toute mise à jour des versions d'Android Studio est une lutte contre des bugs inexplicables. Il était tout aussi difficile de maintenir des tests de capture d'écran, car la bibliothèque n'était pas très stable, avec des faux positifs. Nous avons retiré les tests de capture d'écran de la liste de vérifications.
Finalement, il nous reste :
- Compilation ARK ;
- Tests Junit ;
- Des tests d'instrumentation.
Cache Gradle distant
Sans lourdes vérifications, tout est devenu meilleur. Mais il n'y a pas de limite à la perfection !
Notre application était déjà divisée en environ 150 modules gradle. En général, dans ce cas, le cache Gradle distant fonctionne bien, et nous avons décidé de l'essayer.
Le cache distant Gradle est un service qui peut mettre en cache des artefacts de construction pour des tâches spécifiques dans des modules distincts. Gradle, au lieu de compiler réellement le code, interroge via HTTP le cache distant et demande si quelqu'un a déjà exécuté cette tâche. Si oui, il télécharge simplement le résultat.
Lancer le cache distant Gradle est facile, car Gradle fournit une image Docker. Nous avons réussi à le faire en trois heures.
Il suffit de lancer Docker et d'ajouter une ligne dans le projet. Mais bien que cela puisse être fait rapidement, pour que tout fonctionne bien, cela demande beaucoup de temps.
Ci-dessous, le graphique des échecs de cache.
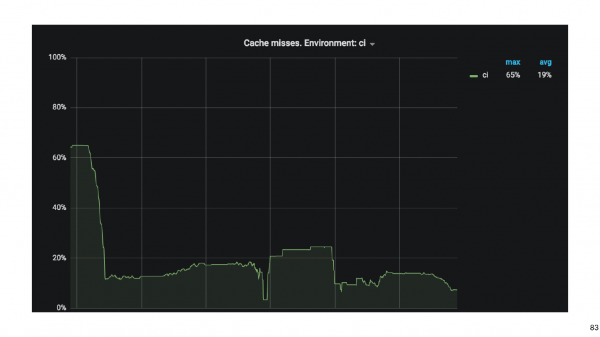
Au tout début, le pourcentage de ratés de cache était d'environ 65. Après trois semaines, nous avons réussi à le réduire à 20%. Il s'est avéré que les tâches que l'application Android crée ont des dépendances transitives étranges, ce qui faisait échouer Gradle.
En activant le cache, nous avons considérablement accéléré la construction. Mais en plus de la construction, des tests d'instrumentation sont également exécutés, et ils prennent du temps. Il est possible que tous les tests ne doivent pas être exécutés pour chaque pull request. Pour le découvrir, nous utilisons l'analyse d'impact.
Analyse d'impact
Pour chaque pull request, nous rassemblons le git diff et trouvons les modules Gradle modifiés.
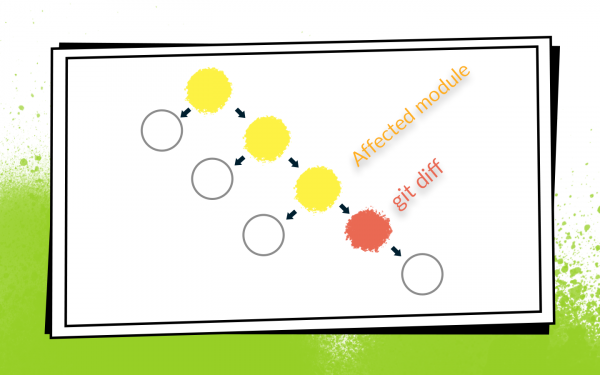
Il est judicieux d'exécuter uniquement les tests d'instrumentation qui vérifient les modules modifiés et tous les modules qui en dépendent. Il n'est pas utile d'exécuter des tests pour les modules voisins : le code n'a pas changé et rien ne peut être cassé.
Avec les tests d'instrumentation, ce n'est pas si simple, car ils doivent se trouver dans le module supérieur Application. Nous avons appliqué une heuristique d'analyse de bytecode pour comprendre à quel module chaque test appartient.
La modernisation des tests d'instrumentation pour qu'ils vérifient uniquement les modules impliqués a pris environ huit semaines.
Les mesures pour accélérer les vérifications ont fonctionné avec succès. Nous avons réduit la durée de 45 minutes à environ 15 minutes. Un quart d'heure d'attente pour un build est désormais acceptable.
Mais maintenant, les développeurs commencent à se plaindre qu'ils ne comprennent pas quels builds sont lancés, où voir les logs, pourquoi le build est rouge, quel test a échoué, etc.
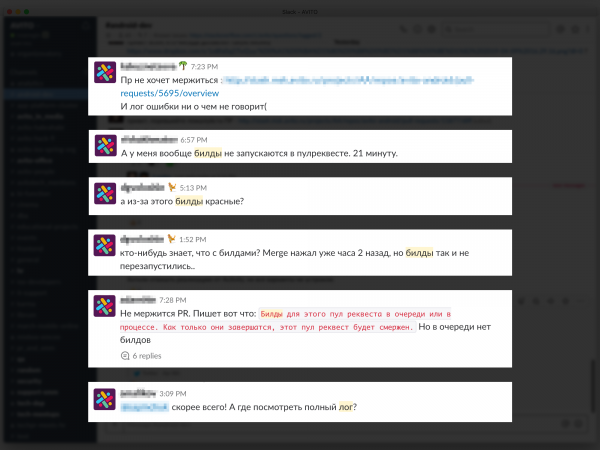
Les problèmes de rétroaction ralentissent le développement, c'est pourquoi nous avons essayé de fournir des informations aussi claires et détaillées que possible sur chaque PR et build. Nous avons commencé par des commentaires dans Bitbucket sur les PR indiquant quel build a échoué et pourquoi, et avons envoyé des messages ciblés dans Slack. Par la suite, nous avons créé un tableau de bord pour la page PR avec la liste de tous les builds actuellement en cours d'exécution et leur état : en attente, en cours, échoué ou terminé. On peut cliquer sur un build pour accéder à son log.
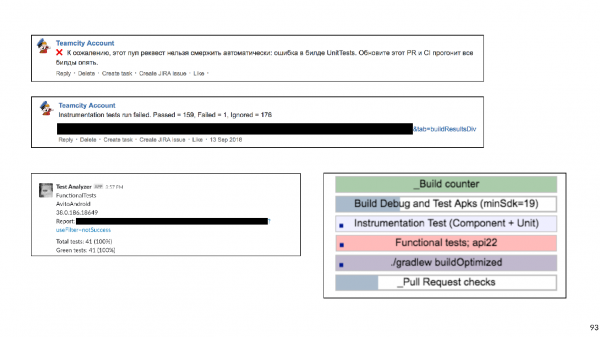
Six semaines ont été consacrées à une rétroaction détaillée.
Plans
Passons à l'histoire la plus récente. En résolvant la question de la rétroaction, nous avons atteint un nouveau niveau — nous avons décidé de construire notre ferme d'émulateurs. Lorsqu'il y a beaucoup de tests et d'émulateurs, il devient difficile de les gérer. Au final, tous nos émulateurs ont déménagé dans un cluster k8s avec une gestion dynamique des ressources.
De plus, il y a d'autres projets en cours.
- Renvoyer Lint (et d'autres analyses statiques). Nous travaillons déjà dans ce sens.
- Exécuter tous les tests end-to-end sur toutes les versions du SDK avec l'option de blocage sur PR. Ainsi, nous avons retracé l'évolution de l'intégration continue chez Avito. Maintenant, je voudrais donner quelques conseils du point de vue d'un expert.
Conseils
Si je ne pouvais donner qu'un seul conseil, ce serait celui-ci :
Veuillez faire attention aux scripts shell !
Bash est un outil très flexible et puissant, il est très facile et rapide d'écrire des scripts avec. Mais on peut tomber dans le piège, et nous y sommes malheureusement tombés.
Tout a commencé par des scripts simples qui étaient exécutés sur nos machines de build :
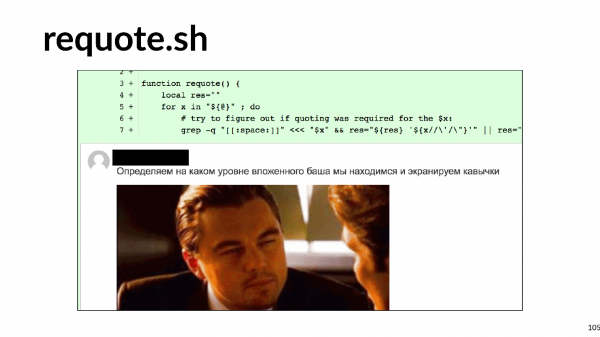
Mais, comme on le sait, tout évolue et se complique avec le temps — lançons un script depuis un autre, transmettions-y certains paramètres — au final, il a fallu écrire une fonction qui détermine à quel niveau de profondeur bash nous sommes pour mettre les bonnes guillemets afin que tout cela fonctionne.
#!/usr/bin/env bash
./gradlew assembleDebug
Vous pouvez imaginer la charge de travail nécessaire pour développer de tels scripts. Je vous conseille de ne pas tomber dans ce piège.
Par quoi peut-on remplacer ?
Tout langage de script. Écrire en
- Python ou Kotlin Script est plus pratique, car c'est de la programmation, pas du scripting. Ou décrire toute la logique des builds sous forme de
- tâches gradle personnalisées pour votre projet. Nous avons décidé de choisir la deuxième option et supprimons progressivement tous les scripts bash en écrivant de nombreuses tâches gradle personnalisées.
Conseil n°2 : garder l'infrastructure sous forme de code.
Conseil n° 2 : conserver l'infrastructure dans le code.
C'est pratique lorsque la configuration de l'intégration continue n'est pas stockée dans l'interface utilisateur de Jenkins ou TeamCity, etc., mais sous forme de fichiers texte directement dans le dépôt du projet. Cela permet de le versionner. Il ne sera pas difficile de revenir en arrière ou de construire le code sur une autre branche.
Les scripts peuvent être stockés dans le projet. Mais que faire avec l'environnement ?
Conseil n°3 : Docker peut aider avec l'environnement.
Il aidera certainement les développeurs Android, malheureusement pas encore pour iOS.
Voici un exemple de fichier docker simple qui contient JDK et Android SDK :
FROM openjdk:8

ENV SDK_URL="https://dl.google.com/android/repository/sdk-tools-linux-3859397.zip"
    ANDROID_HOME="/usr/local/android-sdk"
    ANDROID_VERSION=26
    ANDROID_BUILD_TOOLS_VERSION=26.0.2

# Télécharger Android SDK
RUN mkdir "$ANDROID_HOME" .android
    && cd "$ANDROID_HOME"
    && curl -o sdk.zip $SDK_URL
    && unzip sdk.zip
    && rm sdk.zip
    && yes | $ANDROID_HOME/tools/bin/sdkmanager --licenses

# Installer Android Build Tool et bibliothèques
RUN $ANDROID_HOME/tools/bin/sdkmanager --update
RUN $ANDROID_HOME/tools/bin/sdkmanager "build-tools;${ANDROID_BUILD_TOOLS_VERSION}"
    "platforms;android-${ANDROID_VERSION}"
    "platform-tools"

RUN mkdir /application
WORKDIR /application
Après avoir écrit ce fichier docker (je vous le dis en secret, vous n'avez pas besoin de l'écrire, vous pouvez en télécharger un prêt sur GitHub) et en construisant l'image, vous obtenez une machine virtuelle sur laquelle vous pouvez compiler l'application et exécuter des tests Junit.
Deux principaux arguments pour lesquels cela a du sens : scalabilité et reproductibilité. Avec Docker, vous pouvez rapidement créer une dizaine d'agents de build, qui auront exactement le même environnement que le précédent. Cela facilite grandement la vie des ingénieurs CI. Inclure android-sdk dans Docker est assez simple, avec les émulateurs c'est un peu plus compliqué : il faut faire un petit effort (ou encore télécharger un prêt sur GitHub).
Conseil n°4 : n'oubliez pas que les vérifications ne sont pas faites pour le plaisir, mais pour les gens.
Il est très important pour les développeurs d'avoir un retour rapide et, surtout, compréhensible : ce qui s'est mal passé, quel test a échoué, où consulter le build log.
Conseil n°5 : soyez pragmatiques dans le développement de l'intégration continue.
Comprenez clairement quels types d'erreurs vous souhaitez prévenir, combien de ressources et de temps vous êtes prêts à investir. Les vérifications trop longues peuvent par exemple être déplacées la nuit. Et abandonnez celles qui détectent des erreurs peu importantes.
Conseil n°6 : utilisez des outils prêts à l'emploi.
Il existe maintenant de nombreuses entreprises qui proposent une CI cloud.
C'est une bonne solution pour les petites équipes. Pas besoin de gérer quoi que ce soit, il suffit de payer un peu d'argent, de rassembler votre application et même de lancer des tests d'instrumentation.
Conseil n°7 : dans une grande équipe, les solutions in-house sont plus avantageuses.
Mais tôt ou tard, avec la croissance de l'équipe, les solutions in-house deviendront plus rentables. Il y a un point à considérer avec ces solutions. En économie, il y a la loi des rendements décroissants : dans tout projet, chaque amélioration supplémentaire devient de plus en plus difficile et nécessite de plus en plus d'investissements.
L'économie décrit toute notre vie, y compris l'intégration continue. J'ai construit un graphique des efforts requis à chaque étape du développement de notre intégration continue.
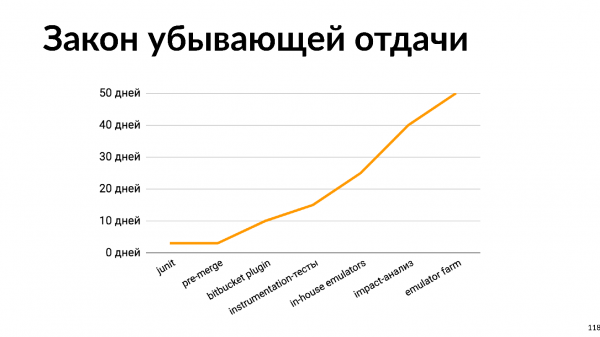
On peut constater que toute amélioration devient de plus en plus difficile. En regardant ce graphique, on peut comprendre qu'il est nécessaire de développer l'intégration continue en cohérence avec la croissance de la taille de l'équipe. Pour une équipe de deux personnes, passer 50 jours à développer une ferme interne d'émulateurs n'est pas une bonne idée. Mais en même temps, pour une grande équipe, ne pas s'occuper de l'intégration continue est également une mauvaise idée, car cela nécessitera encore plus de temps pour résoudre les problèmes d'intégration, réparer la communication, etc.
Nous avons commencé par dire que l'automatisation est nécessaire, car les gens sont chers, ils font des erreurs et sont paresseux. Mais l'automatisation est également réalisée par des gens. Par conséquent, ces mêmes problèmes s'appliquent aussi à l'automatisation.
- Automatiser coûte cher. Rappelez-vous du graphique des efforts.
- Lors de l'automatisation, les gens se trompent.
- Il est parfois très tentant de ne pas automatiser, car tout fonctionne déjà. Pourquoi améliorer encore quelque chose, pourquoi toute cette intégration continue ?
Mais j'ai des statistiques : 20 % des builds présentent des erreurs. Et cela ne se produit pas parce que nos développeurs écrivent mal le code. C'est parce que les développeurs sont convaincus que si jamais ils commettent une erreur, elle ne parviendra pas à develop, elle sera détectée par des contrôles automatisés. Par conséquent, les développeurs peuvent consacrer plus de temps à écrire du code et à faire des choses intéressantes, plutôt qu'à tester localement.
Pratiquez l'intégration continue. Mais avec modération.
Au fait, Nikolai Nesterov ne fait pas seulement de superbes présentations lui-même, mais il fait également partie du comité de programme et aide les autres à préparer des présentations enrichissantes pour vous. Vous pouvez évaluer la richesse et l'utilité du programme de la prochaine conférence en fonction des thèmes de . Pour plus de détails, rendez-vous les 22 et 23 avril à l'Infosphère.
Source : habr.com
