

Dans cet article, nous aimerions partager une manière intéressante de gérer la configuration d'un système distribué.
La configuration est directement représentée dans le langage Scala de manière sûre en termes de type. Une mise en œuvre d'exemple est décrite en détail. Divers aspects de la proposition sont discutés, y compris l'influence sur l'ensemble du processus de développement.
()
Introduction
Construire des systèmes distribués robustes nécessite l'utilisation d'une configuration correcte et cohérente sur tous les nœuds. Une solution typique consiste à utiliser une description de déploiement textuelle (terraform, ansible ou quelque chose de similaire) et des fichiers de configuration générés automatiquement (souvent dédiés à chaque nœud rôle). Nous souhaitons également utiliser les mêmes protocoles des mêmes versions sur chaque nœud communicant (sinon, nous rencontrerons des problèmes d'incompatibilité). Dans le monde JVM, cela signifie qu'au moins la bibliothèque de messagerie doit être de la même version sur tous les nœuds communicants.
Qu'en est-il des tests du système ? Bien sûr, nous devrions avoir des tests unitaires pour tous les composants avant de passer aux tests d'intégration. Pour pouvoir extrapoler les résultats des tests sur l'exécution, nous devons nous assurer que les versions de toutes les bibliothèques restent identiques dans les environnements d'exécution et de test.
Lors de l'exécution de tests d'intégration, il est souvent beaucoup plus facile d'avoir le même classpath sur tous les nœuds. Nous devons simplement nous assurer que le même classpath est utilisé lors du déploiement. (Il est possible d'utiliser différents classpaths sur différents nœuds, mais il est plus difficile de représenter cette configuration et de la déployer correctement.) Ainsi, pour simplifier les choses, nous ne considérerons que des classpaths identiques sur tous les nœuds.
La configuration a tendance à évoluer avec le logiciel. Nous utilisons généralement des versions pour identifier les différentes
étapes de l'évolution du logiciel. Il semble raisonnable de couvrir la configuration sous gestion de version et d'identifier différentes configurations avec des étiquettes. S'il n'y a qu'une seule configuration en production, nous pouvons utiliser une seule version comme identifiant. Parfois, nous pouvons avoir plusieurs environnements de production. Et pour chaque environnement, nous pourrions avoir une branche de configuration distincte. Ainsi, les configurations peuvent être étiquetées avec une branche et une version pour identifier de manière unique différentes configurations. Chaque étiquette de branche et version correspond à une seule combinaison de nœuds distribués, ports, ressources externes, versions de bibliothèques dans chaque nœud. Ici, nous ne couvrirons qu'une seule branche et identifierons les configurations par une version décimale à trois composantes (1.2.3), de la même manière que d'autres artefacts.
Dans les environnements modernes, les fichiers de configuration ne sont plus modifiés manuellement. Typiquement, nous générons
des fichiers de configuration au moment du déploiement et ensuite. On pourrait donc se demander pourquoi nous utilisons encore un format texte pour les fichiers de configuration ? Une option viable est de placer la configuration à l'intérieur d'une unité de compilation et de bénéficier de la validation de configuration à la compilation.
Dans cet article, nous allons examiner l'idée de conserver la configuration dans l'artefact compilé.
Configuration compilable
Dans cette section, nous discuterons d'un exemple de configuration statique. Deux services simples — un service d'écho et le client du service d'écho sont configurés et mis en œuvre. Ensuite, deux systèmes distribués différents avec les deux services sont instanciés. L'un est pour une configuration à nœud unique et l'autre pour une configuration à deux nœuds.
Un système distribué typique se compose de quelques nœuds. Les nœuds pourraient être identifiés en utilisant un type :
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
ou juste
case class NodeId(hostName: String)ou même
object Singleton
type NodeId = Singleton.type
Ces nœuds exercent divers rôles, exécutent certains services et doivent être capables de communiquer avec les autres nœuds par le biais de connexions TCP/HTTP.
Pour une connexion TCP, un numéro de port est au moins requis. Nous voulons également nous assurer que le client et le serveur parlent le même protocole. Afin de modéliser une connexion entre les nœuds, déclarons la classe suivante :
classe TcpEndPoint[Protocol](noeud: NodeId, port: Port[Protocol])où Port est juste un Int dans la plage autorisée :
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]types affinés
Voir bibliothèque. En résumé, cela permet d'ajouter des contraintes de temps de compilation à d'autres types. Dans ce cas Int n'est autorisé qu'à avoir des valeurs sur 16 bits pouvant représenter des numéros de port. Il n'est pas nécessaire d'utiliser cette bibliothèque pour cette approche de configuration. Cela semble juste très approprié.
Pour HTTP (REST), nous pourrions également avoir besoin d'un chemin du service :
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
classe PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
type fantôme
Pour identifier le protocole lors de la compilation, nous utilisons la fonctionnalité Scala de déclaration d'argument de type Protocole qui n'est pas utilisée dans la classe. C'est un type fantôme fantôme. À l'exécution, nous avons rarement besoin d'une instance d'identifiant de protocole, c'est pourquoi nous ne la stockons pas. Lors de la compilation, ce type fantôme offre une sécurité de type supplémentaire. Nous ne pouvons pas passer un port avec un protocole incorrect.
Un des protocoles les plus utilisés est l'API REST avec sérialisation Json :
trait scellé JsonHttpRestProtocol[RequestMessage, ResponseMessage]où RequestMessage est le type de base des messages que le client peut envoyer au serveur et ResponseMessage est le message de réponse du serveur. Bien sûr, nous pouvons créer d'autres descriptions de protocole qui spécifient le protocole de communication avec la précision désirée.
Pour les besoins de cet article, nous utiliserons une version simplifiée du protocole :
trait scellé SimpleHttpGetRest[RequestMessage, ResponseMessage]Dans ce protocole, le message de demande est ajouté à l'url et le message de réponse est retourné sous forme de chaîne simple.
Une configuration de service pourrait être décrite par le nom du service, une collection de ports et certaines dépendances. Il existe quelques façons possibles de représenter tous ces éléments en Scala (par exemple, HList, types de données algébriques). Pour les besoins de cet article, nous utiliserons le Cake Pattern et représenterons des pièces combinables (modules) comme des traits. (Le Cake Pattern n'est pas une exigence pour cette approche de configuration compilable. C'est juste une mise en œuvre possible de l'idée.)
Les dépendances pourraient être représentées en utilisant le Cake Pattern comme points de terminaison d'autres nœuds :
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Le service Echo nécessite seulement un port configuré. Et nous déclarons que ce port prend en charge le protocole echo. Notez que nous n'avons pas besoin de spécifier un port particulier à ce moment, car le trait permet des déclarations de méthodes abstraites. Si nous utilisons des méthodes abstraites, le compilateur exigera une implémentation dans une instance de configuration. Ici, nous avons fourni l'implémentation (8081) et elle sera utilisée comme valeur par défaut si nous l'omettons dans une configuration concrète.
Nous pouvons déclarer une dépendance dans la configuration du client du service echo :
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
La dépendance a le même type que le echoService. En particulier, elle exige le même protocole. Par conséquent, nous pouvons être sûrs que si nous connectons ces deux dépendances, elles fonctionneront correctement.
Implémentation des services
Un service a besoin d'une fonction pour démarrer et se fermer proprement. (La capacité de fermer un service est essentielle pour les tests.) Encore une fois, il existe quelques options pour spécifier une telle fonction pour une configuration donnée (par exemple, nous pourrions utiliser des classes de types). Pour cet article, nous utiliserons encore une fois le Cake Pattern. Nous pouvons représenter un service en utilisant cats.Resource qui fournit déjà un encapsulage et un relâchement des ressources. Pour acquérir une ressource, nous devons fournir une configuration et un contexte d'exécution. Ainsi, la fonction de démarrage du service pourrait ressembler à :
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
où
Configuration— type de configuration requise par ce démarrage de serviceAddressResolver— un objet d'exécution qui a la capacité d'obtenir de vraies adresses d'autres nœuds (continuez à lire pour plus de détails).
les autres types proviennent de cats:
F[_]— type d'effet (dans le cas le plus simpleF[A]pourrait être simplement() => A. Dans cet article, nous utiliseronscats.IO.)Reader[A,B]— est plus ou moins un synonyme d'une fonctionA => Bcats.Resource— a des moyens d'acquérir et de libérerTimer— permet de dormir/mesurer le tempsContextShift— analogue deExecutionContextApplicative— enveloppe de fonctions dans l'effet (presque un monade) (nous pourrions éventuellement le remplacer par autre chose)
En utilisant cette interface, nous pouvons implémenter quelques services. Par exemple, un service qui ne fait rien :
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Voir pour d'autres implémentations de services — ,
and .)
Un nœud est un seul objet qui exécute quelques services (le démarrage d'une chaîne de ressources est facilité par le Cake Pattern) :
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Notez que dans le nœud, nous spécifions le type exact de configuration requis par ce nœud. Le compilateur ne nous laissera pas construire l'objet (Cake) avec un type insuffisant, car chaque trait de service déclare une contrainte sur le Configuration type. De plus, nous ne pourrons pas démarrer le nœud sans fournir une configuration complète.
Résolution d'adresse du nœud
Pour établir une connexion, nous avons besoin d'une adresse hôte réelle pour chaque nœud. Cela peut être connu plus tard que d'autres parties de la configuration. Par conséquent, nous avons besoin d'une façon de fournir un mappage entre l'identifiant du nœud et son adresse réelle. Ce mappage est une fonction :
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Il existe plusieurs façons d'implémenter une telle fonction.
- Si nous connaissons les adresses réelles avant le déploiement, pendant l'instanciation des hôtes de nœud, alors nous pouvons générer du code Scala avec les adresses réelles et exécuter la construction par la suite (ce qui effectue des vérifications à la compilation, puis lance la suite de tests d'intégration). Dans ce cas, notre fonction de mappage est connue statiquement et peut être simplifiée à quelque chose comme une
Map[NodeId, NodeAddress]. - Parfois, nous n'obtenons les adresses réelles qu'à un stade ultérieur lorsque le nœud est réellement démarré, ou nous n'avons pas les adresses des nœuds qui n'ont pas encore été démarrés. Dans ce cas, nous pourrions avoir un service de découverte qui est démarré avant tous les autres nœuds et chaque nœud pourrait annoncer son adresse dans ce service et s'abonner à des dépendances.
- Si nous pouvons modifier
/etc/hosts, nous pouvons utiliser des noms d'hôte prédéfinis (commemy-project-main-nodeandecho-backend) et simplement associer ce nom avec l'adresse IP au moment du déploiement.
Dans cet article, nous ne couvrons pas ces cas plus en détail. En fait, dans notre exemple simplifié, tous les nœuds auront la même adresse IP — 127.0.0.1.
Dans cet article, nous considérerons deux agencements de systèmes distribués :
- Agencement à nœud unique, où tous les services sont placés sur le même nœud.
- Agencement à deux nœuds, où le service et le client se trouvent sur des nœuds différents.
La configuration pour un est la suivante :
Configuration d'un nœud unique
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifiant du nœud unique
  \/\/ configuration du serveur
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Spécification du port de service en toute sécurité de type. *\/
  override def portNumber: PortNumber = 8088

  \/\/ configuration du client

  \/** Nous utiliserons le service fourni par le même hôte. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ configuration du contrôleur de cycle de vie
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0,5 seconde supplémentaire pour que 10 requêtes soient effectuées, pas 9.
}
Ici, nous créons une configuration unique qui étend à la fois la configuration du serveur et celle du client. Nous configurons également un contrôleur de cycle de vie qui terminera normalement le client et le serveur après la durée de vie le passage de l'intervalle.
Le même ensemble d'implémentations de services et de configurations peut être utilisé pour créer la disposition d'un système avec deux nœuds distincts. Nous devons simplement créer avec les services appropriés :
Configuration de deux nœuds
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! spécification de dépendance
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0,5 seconde supplémentaire pour que 10 requêtes soient effectuées, pas 9.

    def testMessage: String = "dolly"
  }
Voyez comment nous spécifions la dépendance. Nous mentionnons le service fourni par l'autre nœud comme une dépendance du nœud actuel. Le type de dépendance est vérifié car il contient un type fantôme qui décrit le protocole. Et à l'exécution, nous aurons le bon identifiant de nœud. C'est l'un des aspects importants de l'approche de configuration proposée. Cela nous donne la possibilité de définir le port une seule fois et de nous assurer que nous référencions le bon port.
Implémentation de deux nœuds
Pour cette configuration, nous utilisons exactement les mêmes implémentations de services. Pas de modifications du tout. Cependant, nous créons deux implémentations de nœud différentes qui contiennent un ensemble différent de services :
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Le premier nœud implémente le serveur et il a seulement besoin de la configuration côté serveur. Le deuxième nœud implémente le client et nécessite une autre partie de la configuration. Les deux nœuds nécessitent une spécification de durée de vie. Pour les besoins de cet article, le nœud de service aura une durée de vie infinie qui pourrait être terminée en utilisant SIGTERM, tandis que le client echo se terminera après la durée finie configurée. Voir le pour plus de détails.
Processus de développement global
Voyons comment cette approche modifie notre façon de travailler avec la configuration.
La configuration en tant que code sera compilée et produira un artefact. Il semble raisonnable de séparer l'artefact de configuration d'autres artefacts de code. Souvent, nous pouvons avoir une multitude de configurations sur la même base de code. Et bien sûr, nous pouvons avoir plusieurs versions de différentes branches de configuration. Dans une configuration, nous pouvons sélectionner des versions particulières de bibliothèques et cela restera constant chaque fois que nous déployons cette configuration.
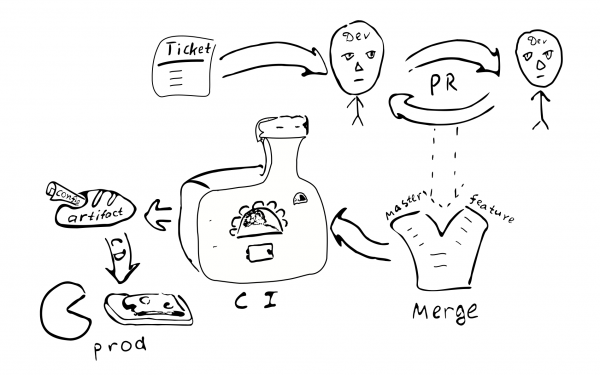
Un changement de configuration devient un changement de code. Il doit donc être couvert par le même processus d'assurance qualité :
Ticket -> PR -> examen -> fusion -> intégration continue -> déploiement continu
Les conséquences de cette approche sont les suivantes :
- La configuration est cohérente pour une instance particulière du système. Il semble qu'il n'y ait pas de moyen d'avoir une connexion incorrecte entre les nœuds.
- Il n'est pas facile de changer la configuration d'un seul nœud. Il semble déraisonnable de se connecter et de modifier des fichiers texte. Ainsi, la dérive de configuration devient moins possible.
- Les petites modifications de configuration ne sont pas faciles à réaliser.
- La plupart des modifications de configuration suivront le même processus de développement et passeront par un examen.
Avons-nous besoin d'un dépôt séparé pour la configuration de production ? La configuration de production peut contenir des informations sensibles que nous souhaitons garder hors de portée de nombreuses personnes. Il pourrait donc être judicieux de conserver un dépôt séparé avec un accès restreint qui contiendra la configuration de production. Nous pouvons diviser la configuration en deux parties : celle qui contient la plupart des paramètres ouverts de production et celle qui contient la partie secrète de la configuration. Cela permettrait d'accorder l'accès à la majorité des paramètres à la plupart des développeurs tout en restreignant l'accès à des choses vraiment sensibles. Il est facile d'accomplir cela en utilisant des traits intermédiaires avec des valeurs par défaut pour les paramètres.
Variations
Voyons les avantages et les inconvénients de l'approche proposée par rapport aux autres techniques de gestion de configuration.
Tout d'abord, nous allons énumérer quelques alternatives aux différents aspects de la façon proposée de traiter la configuration :
- Fichier texte sur la machine cible.
- Stockage centralisé de clés-valeurs (comme
etcd/zookeeper). - Composants de sous-processus qui pourraient être reconfigurés/redémarrés sans redémarrer le processus.
- Configuration en dehors de l'artéfact et du contrôle de version.
Le fichier texte offre une certaine flexibilité en termes de correctifs ad hoc. Un administrateur système peut se connecter au nœud cible, effectuer une modification et simplement redémarrer le service. Cela peut ne pas être aussi bon pour des systèmes plus vastes. Aucune trace n'est laissée de la modification. Le changement n'est pas revu par une autre paire d'yeux. Il peut être difficile de découvrir ce qui a causé le changement. Il n'a pas été testé. Du point de vue d'un système distribué, un administrateur peut simplement oublier de mettre à jour la configuration dans l'un des autres nœuds.
(Au fait, si finalement il y a un besoin de commencer à utiliser des fichiers de configuration texte, il nous suffira d'ajouter un analyseur + un validateur qui pourrait produire le même Configuration type et ce serait suffisant pour commencer à utiliser des configurations texte. Cela montre également que la complexité de la configuration à compilation est un peu plus petite que la complexité des configurations basées sur du texte, car dans la version basée sur du texte, nous avons besoin de code supplémentaire.)
Le stockage centralisé de clés-valeurs est un bon mécanisme pour la distribution des méta-paramètres d'application. Ici, nous devons réfléchir à ce que nous considérons comme des valeurs de configuration et ce qui n'est que des données. Étant donné une fonction C => A => B nous appelons généralement des valeurs rarement changées C «configuration», tandis que les données fréquemment changées A ne sont que des données. La configuration doit être fournie à la fonction avant les données. A. Étant donné cette idée, nous pouvons dire que c'est la fréquence attendue des changements qui pourrait être utilisée pour distinguer les données de configuration des simples données. De plus, les données proviennent généralement d'une seule source (utilisateur) et la configuration provient d'une source différente (administrateur). Traiter des paramètres qui peuvent être modifiés après l'initialisation du processus entraîne une augmentation de la complexité de l'application. Pour de tels paramètres, nous devrons gérer leur mécanisme de livraison, leur analyse et leur validation, ainsi que la gestion des valeurs incorrectes. Par conséquent, afin de réduire la complexité du programme, il vaut mieux réduire le nombre de paramètres susceptibles de changer en cours d'exécution (ou même les éliminer complètement).
D'un point de vue de ce post, nous devons faire une distinction entre les paramètres statiques et dynamiques. Si la logique de service nécessite un changement rare de certains paramètres à l'exécution, nous pouvons les appeler paramètres dynamiques. Sinon, ce sont des paramètres statiques qui peuvent être configurés selon l'approche proposée. D'autres approches pourraient être nécessaires pour la reconfiguration dynamique. Par exemple, certaines parties du système pourraient être redémarrées avec les nouveaux paramètres de configuration d'une manière similaire au redémarrage de processus séparés d'un système distribué.
(À mon humble avis, il vaut mieux éviter la reconfiguration à l'exécution car cela augmente la complexité du système.
Il pourrait être plus simple de compter uniquement sur le support du système d'exploitation pour redémarrer les processus. Toutefois, cela pourrait ne pas toujours être possible.)
Un aspect important de l'utilisation de la configuration statique qui fait parfois réfléchir les gens à la configuration dynamique (sans d'autres raisons) est le temps d'arrêt du service pendant la mise à jour de la configuration. En effet, si nous devons apporter des modifications à la configuration statique, nous devons redémarrer le système pour que les nouvelles valeurs prennent effet. Les exigences en matière de temps d'arrêt varient selon les systèmes, donc cela ne peut pas être si critique. Si c'est critique, alors nous devons planifier à l'avance pour tout redémarrage du système. Par exemple, nous pourrions mettre en œuvre . Dans ce scénario, chaque fois que nous devons redémarrer le système, nous démarrons une nouvelle instance du système en parallèle, puis nous passons l'ELB à cette instance, tout en laissant l'ancien système terminer la gestion des connexions existantes.
Qu'en est-il de garder la configuration à l'intérieur d'un artefact versionné ou à l'extérieur ? Garder la configuration à l'intérieur d'un artefact signifie dans la plupart des cas que cette configuration a passé le même processus d'assurance qualité que les autres artefacts. Ainsi, on peut être certain que la configuration est de bonne qualité et digne de confiance. En revanche, une configuration dans un fichier séparé signifie qu'il n'y a aucune trace de qui et pourquoi des modifications ont été apportées à ce fichier. Est-ce important ? Nous croyons que pour la plupart des systèmes de production, il est préférable d'avoir une configuration stable et de haute qualité.
La version de l'artefact permet de savoir quand il a été créé, quelles valeurs il contient, quelles fonctionnalités sont activées/désactivées, qui était responsable de chaque modification de la configuration. Cela peut demander un certain effort pour garder la configuration à l'intérieur d'un artefact et c'est un choix de conception à faire.
Avantages et inconvénients
Ici, nous souhaitons souligner certains avantages et discuter de certains inconvénients de l'approche proposée.
Avantages
Caractéristiques de la configuration compilable d'un système distribué complet :
- Vérification statique de la configuration. Cela donne un niveau de confiance élevé, que la configuration est correcte compte tenu des contraintes de type.
- Langage riche de configuration. En général, d'autres approches de configuration sont limitées à au maximum la substitution de variables.
En utilisant Scala, on peut utiliser une vaste gamme de fonctionnalités du langage pour améliorer la configuration. Par exemple, nous pouvons utiliser des traits pour fournir des valeurs par défaut, des objets pour définir différents portées, nous pouvons nous référer àvals définis uniquement une fois dans la portée extérieure (DRY). Il est possible d'utiliser des séquences littérales ou des instances de certaines classes (Seq,Carte, etc.). - DSL. Scala a un bon support pour les écrivains de DSL. On peut utiliser ces caractéristiques pour établir un langage de configuration qui est plus pratique et convivial pour l'utilisateur final, de sorte que la configuration finale soit au moins lisible par les utilisateurs du domaine.
- Intégrité et cohérence à travers les nœuds. Un des avantages d'avoir la configuration pour l'ensemble du système distribué au même endroit est que toutes les valeurs sont définies strictement une fois et puis réutilisées dans tous les endroits où nous en avons besoin. De plus, les déclarations de ports typées garantissent que dans toutes les configurations correctes possibles, les nœuds du système parleront le même langage. Il y a des dépendances explicites entre les nœuds, ce qui rend difficile d'oublier de fournir certains services.
- Haute qualité des changements. L'approche générale consistant à faire passer les changements de configuration par le processus normal de PR établit des normes élevées de qualité également dans la configuration.
- Modifications de configuration simultanées. Chaque fois que nous effectuons des modifications dans la configuration, le déploiement automatique garantit que tous les nœuds sont mis à jour.
- Simplification de l’application. L’application n’a pas besoin de parser et de valider la configuration et de gérer les valeurs de configuration incorrectes. Cela simplifie l’application dans son ensemble. (Certaines complexités augmentent dans la configuration elle-même, mais c’est un choix conscient en faveur de la sécurité.) Il est assez simple de revenir à une configuration ordinaire — il suffit d’ajouter les éléments manquants. Il est plus facile de commencer avec une configuration compilée et de reporter la mise en œuvre d'éléments supplémentaires à un moment ultérieur.
- Configuration versionnée. Étant donné que les modifications de configuration suivent le même processus de développement, nous obtenons un artefact avec une version unique. Cela nous permet de revenir à une configuration antérieure si nécessaire. Nous pouvons même déployer une configuration qui a été utilisée il y a un an et elle fonctionnera exactement de la même manière. Une configuration stable améliore la prévisibilité et la fiabilité du système distribué. La configuration est fixée au moment de la compilation et ne peut pas être facilement manipulée sur un système de production.
- Modularité. Le cadre proposé est modulaire et les modules peuvent être combinés de différentes manières pour
supporter différentes configurations (installations / mises en page). En particulier, il est possible d'avoir une installation à nœud unique à petite échelle et un paramétrage multi-nœuds à grande échelle. Il est raisonnable d’avoir plusieurs mises en production. - Tests. Pour des besoins de test, on peut implémenter un service simulé et l’utiliser comme dépendance de manière typée. Différents environnements de test avec diverses parties remplacées par des simulations pourraient être maintenus simultanément.
- Tests d’intégration. Il est parfois difficile d’exécuter des tests d’intégration dans des systèmes distribués. En utilisant l’approche décrite pour une configuration de système distribué complètement typée, nous pouvons exécuter toutes les parties distribuées sur un seul serveur de manière contrôlable. Il est facile d’émuler la situation
lorsqu’un des services devient indisponible.
Inconvénients
L’approche de configuration compilée est différente de la configuration « normale » et elle pourrait ne pas convenir à tous les besoins. Voici quelques-uns des inconvénients de la configuration compilée :
- Configuration statique. Elle pourrait ne pas convenir à toutes les applications. Dans certains cas, il est nécessaire de corriger rapidement la configuration en production en contournant toutes les mesures de sécurité. Cette approche rend cela plus difficile. La compilation et le redéploiement sont nécessaires après avoir effectué une modification de la configuration. C'est à la fois une fonctionnalité et un fardeau.
- Génération de configuration. Lorsque la configuration est générée par un outil d’automatisation, cette approche nécessite une compilation subséquente (qui pourrait échouer en retour). Cela pourrait nécessiter un effort supplémentaire pour intégrer cette étape supplémentaire dans le système de construction.
- Instruments. Il existe de nombreux outils aujourd'hui qui reposent sur des configurations basées sur du texte. Certains d'entre eux
ne seront pas applicables lorsque la configuration est compilée. - Un changement de mentalité est nécessaire. Les développeurs et les DevOps sont familiers avec les fichiers de configuration texte. L’idée de compiler la configuration pourrait leur sembler étrange.
- Avant d’introduire une configuration compilable, un processus de développement logiciel de haute qualité est requis.
Il existe certaines limitations de l’exemple implémenté :
- Si nous fournissons une configuration supplémentaire qui n'est pas demandée par l'implémentation du nœud, le compilateur ne pourra pas nous aider à détecter l'implémentation absente. Cela pourrait être résolu en utilisant
HListou des ADTs (classes de cas) pour la configuration du nœud au lieu de traits et du Cake Pattern. - Nous devons fournir un certain code standard dans le fichier de configuration : (
package,importer,objetdéclarations ;
surcharge de defpour les paramètres qui ont des valeurs par défaut). Cela pourrait être en partie abordé en utilisant un DSL. - Dans ce post, nous ne couvrons pas la reconfiguration dynamique des clusters de nœuds similaires.
Conclusion
Dans cet article, nous avons discuté de l'idée de représenter la configuration directement dans le code source de manière sûre en termes de type. Cette approche pourrait être utilisée dans de nombreuses applications comme remplacement des configurations basées sur XML et d'autres formats texte. Bien que notre exemple ait été implémenté en Scala, il pourrait également être traduit dans d'autres langages compilables (comme Kotlin, C#, Swift, etc.). On pourrait essayer cette approche dans un nouveau projet et, si elle ne convient pas, revenir à la méthode traditionnelle.
Bien sûr, la configuration compilable nécessite un processus de développement de haute qualité. En retour, elle promet de fournir une configuration robuste tout aussi de haute qualité.
Cette approche pourrait être étendue de diverses manières :
- On pourrait utiliser des macros pour effectuer des validations de configuration et échouer à la compilation en cas de défaillances de contraintes de logique métier.
- Un DSL pourrait être mis en œuvre pour représenter la configuration de manière conviviale pour l'utilisateur du domaine.
- Gestion dynamique des ressources avec ajustements automatiques de configuration. Par exemple, lorsque nous ajustons le nombre de nœuds de cluster, nous pourrions vouloir (1) que les nœuds obtiennent une configuration légèrement modifiée ; (2) que le gestionnaire de cluster reçoive des informations sur les nouveaux nœuds.
Merci
Je voudrais remercier Andrey Saksonov, Pavel Popov, Anton Nehaev pour leurs retours inspirants sur le brouillon de cet article qui m'ont aidé à le rendre plus clair.
Source : habr.com
