

Je voudrais parler d'un mécanisme intéressant pour gérer la configuration d'un système distribué. La configuration est définie directement dans un langage compilé (Scala) en utilisant des types sûrs. Dans cet article, nous allons examiner un exemple de cette configuration et discuter des différents aspects de l'intégration d'une configuration compilée dans le processus de développement global.
()
Introduction
Construire un système distribué fiable implique que toutes les nœuds utilisent une configuration correcte, synchronisée avec les autres nœuds. Des technologies DevOps (comme Terraform, Ansible ou quelque chose de similaire) sont généralement utilisées pour générer automatiquement des fichiers de configuration (souvent spécifiques à chaque nœud). Nous voulons également être sûrs que tous les nœuds interagissant utilisent des protocoles identiques (y compris la même version). Sinon, notre système distribué sera sujet à des incompatibilités. Dans le monde de la JVM, une des conséquences de cette exigence est la nécessité d'utiliser la même version de la bibliothèque contenant les messages du protocole partout.
Qu'en est-il des tests du système distribué ? Bien sûr, nous supposons que des tests unitaires sont prévus pour tous les composants avant de passer aux tests d'intégration. (Pour que nous puissions extrapoler les résultats des tests dans l'exécution, nous devons également assurer un ensemble identique de bibliothèques pendant la phase de test et en exécution.)
Lorsqu'il s'agit de tests d'intégration, il est souvent plus simple d'utiliser le même classpath sur tous les nœuds. Nous devons simplement nous assurer que le même classpath est utilisé également en exécution. (Bien qu'il soit tout à fait possible d'exécuter différents nœuds avec des classpaths différents, cela complique toute la configuration et rend le déploiement et les tests d'intégration plus difficiles.) Dans cet article, nous partons du principe que tous les nœuds utiliseront le même classpath.
La configuration évolue avec l'application. Pour identifier les différentes étapes de l'évolution des programmes, nous utilisons des versions. Il semble logique d'identifier également les différentes versions des configurations. Et nous pouvons placer la configuration elle-même dans un système de contrôle de version. S'il n'existe qu'une seule configuration en production, nous pouvons simplement utiliser un numéro de version. Si plusieurs instances de production sont utilisées, nous devrons disposer de plusieurs
branches de configuration et d'une étiquette supplémentaire en plus de la version (par exemple, le nom de la branche). Ainsi, nous pourrons identifier de manière précise la configuration exacte. Chaque identifiant de configuration correspond de manière unique à une combinaison définie de nœuds distribués, de ports, de ressources externes et de versions de bibliothèques. Dans cet article, nous supposerons qu'il n'y a qu'une seule branche, et que nous pouvons identifier la configuration de manière normale en utilisant trois chiffres, séparés par des points (1.2.3).
Dans les environnements modernes, les fichiers de configuration sont rarement créés manuellement. Ils sont le plus souvent générés lors du déploiement et ne sont plus modifiés par la suite (pour que ). Une question légitime se pose alors : pourquoi utilisons-nous encore un format textuel pour stocker la configuration ? Une alternative tout à fait viable est la possibilité d'utiliser du code ordinaire pour la configuration et de bénéficier des vérifications lors de la compilation.
Dans cet article, nous allons justement explorer l'idée de représenter la configuration à l'intérieur d'un artefact compilé.
Configuration compilée
Cette section présente un exemple de configuration statique compilée. Deux services simples sont réalisés : un service d'écho et un client du service d'écho. Sur la base de ces deux services, deux variantes du système sont construites. Dans une variante, les deux services se trouvent sur le même nœud, dans l'autre variante, ils se trouvent sur des nœuds différents.
Une système distribué contient généralement plusieurs nœuds. Les nœuds peuvent être identifiés par des valeurs d'un certain type NodeId:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
ou
case class NodeId(hostName: String)ou même
object Singleton
type NodeId = Singleton.type
Les nœuds jouent différents rôles, des services y sont exécutés et des connexions TCP/HTTP peuvent être établies entre eux.
Pour décrire la connexion TCP, nous avons besoin d'au moins un numéro de port. Nous souhaitons également refléter le protocole supporté sur ce port, afin de garantir que le client et le serveur utilisent le même protocole. Nous allons décrire la connexion à l'aide de la classe suivante :
classe TcpEndPoint[Protocol](noeud: NodeId, port: Port[Protocol])où Port — simplement un nombre entier Int avec la spécification d'une plage de valeurs autorisées :
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Types précisés
Voir la bibliothèque et . En résumé, la bibliothèque permet d'ajouter des contraintes vérifiées à la compilation. Dans ce cas, les valeurs acceptables pour le numéro de port sont des entiers de 16 bits. Pour la configuration compilée, l'utilisation de la bibliothèque refined n'est pas obligatoire, mais elle permet d'améliorer les capacités du compilateur pour vérifier la configuration.
Pour les protocoles HTTP (REST), nous pourrions également avoir besoin du chemin vers le service en plus du numéro de port :
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
classe PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Types fantômes
Pour identifier le protocole au moment de la compilation, nous utilisons un paramètre de type qui n'est pas utilisé à l'intérieur de la classe. Cette solution est liée au fait qu'à l'exécution, nous n'utilisons pas l'instance du protocole, mais nous souhaitons que le compilateur vérifie la compatibilité des protocoles. Grâce à la spécification du protocole, nous ne pourrons pas transmettre un service inapproprié comme dépendance.
L'un des protocoles courants est l'API REST avec sérialisation Json :
trait scellé JsonHttpRestProtocol[RequestMessage, ResponseMessage]où RequestMessage — type de requête, ResponseMessage — type de réponse.
Bien sûr, d'autres descriptions de protocoles peuvent être utilisées, tant qu'elles assurent le niveau de précision requis.
Pour les besoins de cet article, nous utiliserons une version simplifiée du protocole :
trait scellé SimpleHttpGetRest[RequestMessage, ResponseMessage]Ici, la requête est une chaîne ajoutée à l'url, et la réponse est une chaîne renvoyée dans le corps de la réponse HTTP.
La configuration du service est décrite par le nom du service, les ports et les dépendances. Ces éléments peuvent être représentés en Scala de plusieurs manières (par exemple, HList- des types algébriques de données). Pour les besoins de cet article, nous allons utiliser le Cake Pattern et représenter les modules à l'aide de trait’s. (Le Cake Pattern n'est pas un élément obligatoire de l'approche décrite. C'est simplement l'une des implémentations possibles.)
Les dépendances entre les services peuvent être représentées sous forme de méthodes retournant les ports EndPointd'autres nœuds :
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Pour créer un service d'écho, il suffit d'un numéro de port et d'indiquer que ce port prend en charge le protocole d'écho. Nous aurions pu ne pas préciser de port spécifique, car les traits permettent de déclarer des méthodes sans implémentation (méthodes abstraites). Dans ce cas, lors de la création d'une configuration spécifique, le compilateur exigerait que nous fournissions une implémentation de la méthode abstraite ainsi qu'un numéro de port. Comme nous avons implémenté la méthode, lors de la création d'une configuration précise, nous n'avons pas besoin d'indiquer un autre port. La valeur par défaut sera utilisée.
Dans la configuration du client, nous déclarons une dépendance au service d'écho :
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
La dépendance a le même type que le service exporté echoService. En particulier, dans le client d'écho, nous exigeons le même protocole. Ainsi, lors de la connexion de deux services, nous pouvons être sûrs que tout fonctionnera correctement.
Implémentation des services
Pour démarrer et arrêter le service, une fonction est nécessaire. (La possibilité d'arrêter le service est cruciale pour les tests.) Encore une fois, il existe plusieurs moyens d'implémenter une telle fonction (par exemple, nous pourrions utiliser des classes de types basées sur le type de configuration). Pour les besoins de ce post, nous utiliserons le modèle Cake. Nous allons représenter le service à l'aide de la classe cats.Resource, car cette classe dispose déjà de moyens pour garantir la libération sécurisée des ressources en cas de problème. Pour obtenir la ressource, nous devons fournir la configuration et le contexte d'exécution prêt. La fonction de démarrage du service pourrait être comme suit :
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
où
Configuration— type de configuration pour ce serviceAddressResolver— objet d'exécution qui permet de connaître les adresses des autres nœuds (voir ci-après)
et autres types de la bibliothèque cats:
F[_]— type d'effet (dans le cas le plus simpleF[A]peut simplement être une fonction() => A. Dans ce post, nous allons utilisercats.IO.)Reader[A,B]— un synonyme d'une fonctionA => Bcats.Resource— ressource qui peut être obtenue et libéréeTimer— un minuteur (permet de dormir un certain temps et de mesurer des intervalles de temps)ContextShift— analogiqueExecutionContextApplicative— classe de type d'effet permettant de combiner des effets individuels (presque une monade). Dans des applications plus complexes, il semble préférable d'utiliserMonade/EffetConcurrent.
En utilisant cette signature de fonction, nous pouvons implémenter plusieurs services. Par exemple, un service qui ne fait rien :
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Voir , dans lequel d'autres services sont implémentés — ,
et .)
Le nœud est un objet capable de démarrer plusieurs services (le lancement de la chaîne de ressources est assuré par le modèle Cake) :
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Notez que nous indiquons le type exact de configuration requis pour ce nœud. Si nous oublions de spécifier l'un des types de configuration nécessaires pour un service particulier, il y aura une erreur de compilation. De plus, nous ne pourrons pas démarrer le nœud si nous ne fournissons pas un objet ayant le type approprié avec toutes les données nécessaires.
Résolution des noms de nœuds
Pour se connecter à un nœud distant, un véritable IP est requis. Il est tout à fait possible que l'adresse devienne connue plus tard que les autres parties de la configuration. C'est pourquoi nous avons besoin d'une fonction qui mappe l'identifiant du nœud à l'adresse :
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Nous pouvons proposer plusieurs moyens d'implémenter cette fonction :
- Si les adresses deviennent connues avant le déploiement, nous pouvons générer du code Scala avec
les adresses et ensuite lancer la construction. Cela entraînera la compilation et l'exécution des tests.
Dans ce cas, la fonction sera connue statiquement et pourra être représentée dans le code sous forme de mappageMap[NodeId, NodeAddress]. - Dans certains cas, l'adresse valide devient connue uniquement après le lancement du nœud.
Dans ce cas, nous pouvons mettre en œuvre un « service de découverte » qui se lance avant les autres nœuds et tous les nœuds s'enregistrent dans ce service et demandent les adresses des autres nœuds. - Si nous pouvons modifier
/etc/hosts, nous pouvons alors utiliser des noms d'hôtes prédéfinis (commemy-project-main-nodeetecho-backend) et simplement lier ces noms
aux adresses IP lors du déploiement.
Dans ce post, nous ne traiterons pas plus en détail ces cas. Pour notre
exemple simplifié, tous les nœuds auront la même adresse IP — 127.0.0.1.
Nous examinerons ensuite deux variantes de système distribué :
- Déployer tous les services sur un seul nœud.
- Et déployer le service d'écho et le client d'écho sur des nœuds différents.
Configuration pour :
Configuration pour un seul nœud
object SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifiant du nœud unique
  \/\/ configuration du serveur
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Spécification du port de service en toute sécurité de type. *\/
  override def portNumber: PortNumber = 8088

  \/\/ configuration du client

  \/** Nous utiliserons le service fourni par le même hôte. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ configuration du contrôleur de cycle de vie
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0,5 seconde supplémentaire pour que 10 requêtes soient effectuées, pas 9.
}
L'objet implémente la configuration à la fois du client et du serveur. Une configuration de durée de vie est également utilisée pour arrêter le programme après un certain intervalle la durée de vie . (Ctrl-C fonctionne également et libère correctement toutes les ressources.)
Le même ensemble de traits de configuration et d’implémentations peut être utilisé pour créer un système composé de :
Configuration pour deux nœuds
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! spécification de dépendance
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ 0,5 seconde supplémentaire pour que 10 requêtes soient effectuées, pas 9.

    def testMessage: String = "dolly"
  }
Important ! Faites attention à la façon dont les services sont liés. Nous indiquons le service, implémenté par un nœud, comme l'implémentation de la méthode dépendante d'un autre nœud. Le type de dépendance est vérifié par le compilateur, car il contient le type de protocole. Lors de l’exécution, la dépendance contiendra un identifiant valide du nœud cible. Grâce à ce schéma, nous indiquons le numéro de port une seule fois et garantrissons toujours de référencer le bon port.
Implémentation de deux nœuds du système
Pour cette configuration, nous utilisons les mêmes implémentations de services sans modifications. La seule différence est que nous avons maintenant deux objets, chacun implémentant différents ensembles de services :
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Le premier nœud implémente le serveur et nécessite uniquement une configuration serveur. Le deuxième nœud implémente le client et utilise une autre partie de la configuration. De plus, les deux nœuds nécessitent une gestion du cycle de vie. Le nœud serveur fonctionne indéfiniment jusqu'à ce qu'il soit arrêté SIGTERMet le nœud client se termine après un certain temps. Voir .
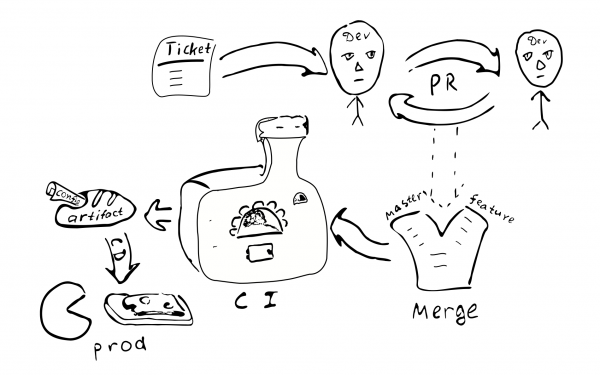
Le processus de développement global
Voyons comment cette approche de configuration affecte le processus de développement global.
La configuration sera compilée avec le reste du code et un artefact (.jar) sera généré. Il semble raisonnable de placer la configuration dans un artefact distinct. Cela est dû au fait que nous pouvons avoir de nombreuses configurations basées sur le même code. Encore une fois, il est possible de générer des artefacts correspondant à différentes branches de configuration. Avec la configuration, les dépendances de versions spécifiques des bibliothèques sont également conservées et ces versions sont conservées indéfiniment, quel que soit le moment où nous décidons de déployer cette version de la configuration.
Tout changement de configuration se traduit par un changement de code. Par conséquent, chaque tel
changement sera couvert par le processus habituel d’assurance qualité :
Ticket dans le bug tracker -> PR -> revue -> fusion avec les branches correspondantes ->
intégration -> déploiement
Principales conséquences de l'introduction de la configuration compilable :
La configuration sera synchronisée sur tous les nœuds du système distribué. Étant donné que tous les nœuds reçoivent la même configuration d'une source unique.
Il est problématique de modifier la configuration uniquement sur un des nœuds. Par conséquent, le « dérèglement de configuration » (configuration drift) est peu probable.
Il devient plus difficile de faire de petits changements dans la configuration.
La plupart des changements de configuration se feront dans le cadre du processus de développement général et seront soumis à un examen.
Un référentiel séparé est-il nécessaire pour stocker la configuration de production ? Cette configuration peut contenir des mots de passe et d'autres informations secrètes, auxquelles nous aimerions restreindre l'accès. Étant donné cela, il semble donc judicieux de stocker la configuration finale dans un référentiel séparé. On peut diviser la configuration en deux parties : l'une contenant des paramètres de configuration publics et l'autre contenant des paramètres d'accès restreint. Cela permettra à la plupart des développeurs d'accéder aux paramètres publics. Une telle séparation n'est pas difficile à atteindre en utilisant des traits intermédiaires contenant des valeurs par défaut.
Variations possibles
Essayons de comparer la configuration compilée avec certaines alternatives courantes :
- Un fichier texte sur la machine cible.
- Un stockage centralisé de paires clé-valeur (
etcd/zookeeper). - Composants du processus qui peuvent être reconfigurés/redémarrés sans redémarrer le processus.
- Stockage de la configuration en dehors de l'artéfact et du contrôle de version.
Les fichiers texte offrent une flexibilité significative en termes de petits changements. Un administrateur système peut se connecter à un nœud distant, effectuer des modifications dans les fichiers appropriés et redémarrer le service. Pour les grands systèmes, cependant, cette flexibilité peut être indésirable. Les modifications effectuées ne laissent pas de traces dans d'autres systèmes. Personne ne procède à une révision des modifications. Il est difficile de savoir qui a effectué les changements et pour quelle raison. Les modifications ne sont pas testées. Si le système est distribué, l'administrateur peut oublier d'apporter la modification correspondante sur d'autres nœuds.
(Il convient également de noter que l'utilisation d'une configuration compilée ne ferme pas la possibilité d'utiliser des fichiers texte à l'avenir. Il suffit d'ajouter un parseur et un validateur qui produisent le même type Configuration, et il est possible d'utiliser des fichiers texte. Il en découle directement que la complexité du système avec une configuration compilée est légèrement inférieure à celle d'un système utilisant des fichiers texte, car des fichiers texte nécessitent du code supplémentaire.)
Un stockage centralisé clé-valeur est un bon mécanisme pour la répartition des méta-paramètres d'une application distribuée. Nous devons définir ce que sont les paramètres de configuration et ce que sont simplement des données. Supposons que nous ayons une fonction C => A => B, où les paramètres C changent rarement, tandis que les données A — changent souvent. Dans ce cas, nous pouvons dire que C — ce sont des paramètres de configuration, et A — ce sont des données. Il semble que les paramètres de configuration diffèrent des données en ce sens qu'ils changent généralement moins souvent que les données. De plus, les données proviennent généralement d'une seule source (de l'utilisateur), tandis que les paramètres de configuration proviennent d'une autre (de l'administrateur système).
Si les paramètres à changement rare doivent être mis à jour sans redémarrer le programme, cela peut souvent conduire à une complexité accrue du programme, car nous devrons trouver un moyen de transmettre les paramètres, de les stocker, les analyser et les valider, ainsi que de traiter les valeurs incorrectes. Par conséquent, pour réduire la complexité du programme, il est judicieux de diminuer le nombre de paramètres qui peuvent changer lors de l'exécution du programme (ou de ne pas prendre en charge de tels paramètres du tout).
Dans le cadre de ce post, nous allons distinguer les paramètres statiques et dynamiques. Si la logique de fonctionnement du service nécessite des modifications des paramètres au cours de l'exécution du programme, nous qualifierons ces paramètres de dynamiques. Dans le cas contraire, les paramètres sont statiques et peuvent être configurés à l'aide d'une configuration compilable. Pour la reconfiguration dynamique, un mécanisme de redémarrage de certaines parties du programme avec de nouveaux paramètres peut être nécessaire, similaire à la façon dont les processus du système d'exploitation sont redémarrés. (À notre avis, il est préférable d'éviter la reconfiguration en temps réel, car cela augmente la complexité du système. Si possible, il vaut mieux utiliser les capacités standard de l'OS pour redémarrer les processus.)
Un des aspects importants de l'utilisation de la configuration statique, qui pousse les gens à considérer la reconfiguration dynamique, est le temps nécessaire au système pour redémarrer après la mise à jour de la configuration (downtime). En effet, si nous devons apporter des modifications à la configuration statique, nous devrons redémarrer le système pour que les nouvelles valeurs prennent effet. Le problème du downtime a une gravité variable selon les systèmes. Dans certains cas, il est possible de planifier le redémarrage à un moment où la charge est minimale. Dans le cas où un service continu est requis, il peut être mis en œuvre . Dans ce cas, lorsque nous devons redémarrer le système, nous lançons une instance parallèle de ce système, basculons l'équilibreur de charge vers elle, et attendons que les anciennes connexions se terminent. Une fois que toutes les anciennes connexions sont terminées, nous arrêtons l'ancienne instance du système.
Examinons maintenant la question du stockage de la configuration à l'intérieur ou à l'extérieur de l'artefact. Si nous stockons la configuration à l'intérieur de l'artefact, nous avons au moins eu la possibilité, lors de la construction de l'artefact, de vérifier la validité de la configuration. Dans le cas où la configuration est en dehors de l'artefact contrôlé, il est difficile de suivre qui a apporté des modifications à ce fichier et pourquoi. À quel point cela est-il important ? À notre avis, pour de nombreux systèmes de production, il est crucial d'avoir une configuration stable et de haute qualité.
La version de l'artefact permet de déterminer quand il a été créé, quelles valeurs il contient, quelles fonctionnalités sont activées/désactivées, et qui est responsable de toute modification de la configuration. Bien sûr, le stockage de la configuration à l'intérieur de l'artefact exige des efforts, il est donc important de prendre une décision consciente.
Pour et contre
J'aimerais me concentrer sur les avantages et les inconvénients de la technologie proposée.
Avantages
Voici une liste des principales fonctionnalités de la configuration compilée du système distribué :
- Vérification statique de la configuration. Cela permet de s'assurer que
la configuration est correcte. - Un langage de configuration riche. En général, d'autres méthodes de configuration sont limitées à un maximum de substitutions de variables textuelles. Avec Scala, un large éventail de possibilités du langage est disponible pour améliorer la configuration. Par exemple, nous pouvons utiliser
des traits pour les valeurs par défaut, regrouper les paramètres avec des objets, et faire référence à des val déclarés une seule fois (DRY) dans la portée englobante. Il est également possible d'instancier directement n'importe quelle classe dans la configuration (Seq,Carte, classes personnalisées). - DSL. Scala offre plusieurs caractéristiques linguistiques facilitant la création de DSL. On peut tirer parti de ces caractéristiques pour mettre en place un langage de configuration plus accessible pour le groupe cible d'utilisateurs, rendant ainsi la configuration lisible par les spécialistes du domaine. Les experts peuvent, par exemple, participer au processus de révision de la configuration.
- Intégrité et synchronisation entre les nœuds. Un des avantages de stocker la configuration de tout système distribué en un seul endroit est que toutes les valeurs sont déclarées une seule fois, puis réutilisées partout où elles sont nécessaires. L'utilisation de types fantômes pour déclarer des ports garantit que dans toutes les configurations correctes du système, les nœuds utilisent des protocoles compatibles. La présence de dépendances obligatoires explicites entre les nœuds garantit que tous les services seront interconnectés.
- Haute qualité des modifications. Modifier la configuration via un processus de développement commun permet d'atteindre des normes de qualité élevées pour la configuration.
- Mise à jour simultanée de la configuration. Le déploiement automatique du système après modification de la configuration garantit que tous les nœuds seront mis à jour.
- Simplification de l'application. L'application ne nécessite pas d'analyse, de vérification de configuration ni de gestion des valeurs incorrectes, ce qui réduit la complexité de l'application. (Une certaine complexité de la configuration, observée dans notre exemple, n'est pas un attribut de la configuration compilée, mais simplement une décision consciente motivée par le désir d'assurer une plus grande sécurité des types.) Il est assez facile de revenir à une configuration normale — il suffit de mettre en œuvre les parties manquantes. Ainsi, par exemple, on peut commencer avec une configuration compilée, en reportant la mise en œuvre des parties superflues à un moment où cela sera vraiment nécessaire.
- Configuration versionnée. Comme les modifications de la configuration suivent le même chemin que toute autre modification, nous obtenons un artefact avec une version unique. Cela nous permet, par exemple, de revenir à une version antérieure de la configuration si nécessaire. Nous pouvons même utiliser une configuration vieille d'un an et le système fonctionnera exactement de la même manière. Une configuration stable améliore la prévisibilité et la fiabilité d'un système distribué. Étant donné que la configuration est figée au moment de la compilation, il est assez difficile de la falsifier en production.
- Modularité. Le cadre proposé est modulaire, et les modules peuvent être combinés de différentes manières pour créer divers systèmes. En particulier, il est possible de configurer un système pour fonctionner sur un seul nœud dans une variante, et sur plusieurs nœuds dans une autre. On peut créer plusieurs configurations pour les instances de production du système.
- Tests. En remplaçant certains services par des objets mock, il est possible d'obtenir plusieurs versions du système, pratiques pour les tests.
- Tests d'intégration. La disponibilité d'une configuration unifiée de l'ensemble du système distribué permet de lancer tous les composants dans un environnement contrôlé lors des tests d'intégration. Il est facile d'émuler, par exemple, une situation où certains nœuds deviennent inaccessibles.
Inconvénients et limitations
La configuration compilée diffère des autres approches de configuration et peut ne pas convenir à certaines applications. Voici quelques inconvénients :
- Configuration statique. Parfois, il est nécessaire de corriger rapidement la configuration en production, en contournant tous les mécanismes de protection. Dans le cadre de cette approche, cela peut être plus complexe. Au moins, la compilation et le déploiement automatique seront de toute façon nécessaires. C'est à la fois une fonctionnalité utile de l'approche et un inconvénient dans certains cas.
- Génération de configuration. Si le fichier de configuration est généré par un outil automatisé, des efforts supplémentaires peuvent être nécessaires pour intégrer le script de compilation.
- Outils. Actuellement, les utilitaires et méthodes destinés à travailler avec la configuration sont basés sur des fichiers texte. Tous ces utilitaires/méthodes ne seront pas disponibles en cas de configuration compilée.
- Changement de perspective requis. Les développeurs et DevOps sont habitués aux fichiers texte. L'idée même de compiler des configurations peut être quelque peu inattendue et inhabituelle, et provoquer du rejet.
- Un processus de développement de haute qualité est nécessaire. Pour profiter confortablement de la configuration compilée, une automatisation complète du processus de compilation et de déploiement de l'application (CI/CD) est essentielle. Sinon, cela sera assez inconfortable.
Examinons également quelques limitations de l'exemple donné, qui ne sont pas liées à l'idée de configuration compilée :
- Si nous fournissons des informations de configuration superflues, qui ne sont pas utilisées par le nœud, alors le compilateur ne nous aidera pas à détecter l'absence d'implémentation. Ce problème peut être résolu en abandonnant le Cake Pattern et en utilisant des types plus stricts, par exemple,
HListou des types algébriques (classes de cas) pour représenter la configuration. - Le fichier de configuration contient des chaînes qui ne se rapportent pas directement à la configuration : (
package,importer, déclarations d'objets;surcharge de def‘s pour les paramètres avec des valeurs par défaut). Cela peut être en partie évité en mettant en œuvre son propre DSL. De plus, d'autres types de configuration (comme XML) imposent également certaines restrictions sur la structure du fichier. - Dans cet article, nous ne discutons pas de la reconfiguration dynamique d'un cluster de nœuds similaires.
Conclusion
Dans cet article, nous avons exploré l'idée de représenter la configuration dans le code source en utilisant les capacités avancées du système de types de Scala. Cette approche peut être appliquée dans diverses applications en tant que remplacement des méthodes traditionnelles de configuration basées sur des fichiers XML ou texte. Bien que notre exemple soit réalisé en Scala, les mêmes idées peuvent être transférées à d'autres langages compilés (tels que Kotlin, C#, Swift, ...). Cette approche peut être testée dans l'un des prochains projets, et si elle ne convient pas, on peut revenir à des fichiers texte en ajoutant les détails manquants.
Naturellement, une configuration compilée nécessite un processus de développement de haute qualité. En contrepartie, elle garantit une haute qualité et une fiabilité des configurations.
L'approche discutée peut être étendue :
- On peut utiliser des macros pour effectuer des vérifications lors de la compilation.
- On peut mettre en œuvre un DSL pour représenter la configuration d'une manière accessible aux utilisateurs finaux.
- On peut réaliser une gestion dynamique des ressources avec un ajustement automatique de la configuration. Par exemple, lorsque le nombre de nœuds dans le cluster change, il est nécessaire que (1) chaque nœud reçoive une configuration légèrement différente ; (2) le gestionnaire de cluster obtienne des informations sur les nouveaux nœuds.
Remerciements
Je tiens à remercier Andrei Saksonov, Pavel Popov et Anton Nekhaev pour leurs critiques constructives sur le brouillon de l'article.
Source : habr.com
