

Bonjour à tous, nous partageons avec vous la deuxième partie de la publication « Systèmes de fichiers virtuels sous Linux : pourquoi sont-ils nécessaires et comment fonctionnent-ils ? » Vous pouvez lire la première partie . Rappelons que cette série de publications est dédiée au lancement d'un nouveau semestre pour le cours , qui commence très bientôt.
Comment surveiller le VFS avec les outils eBPF et bcc
La manière la plus simple de comprendre comment le noyau gère les fichiers sysfs – c'est d'observer cela en pratique, et la façon la plus simple de suivre ARM64 est d'utiliser eBPF. eBPF (abréviation de Berkeley Packet Filter) consiste en une machine virtuelle, s'exécutant dans le , que les utilisateurs privilégiés peuvent interroger (query) depuis la ligne de commande. Les sources du noyau informent le lecteur de ce que le noyau peut faire ; l'exécution des outils eBPF dans un système chargé montre ce que le noyau fait réellement.
Heureusement, commencer à utiliser eBPF est assez facile grâce aux outils , qui sont disponibles en tant que paquets dans la distribution générale et largement documentés . Les outils bcc sont des scripts en Python avec de petites insertions de code en C, ce qui signifie que quiconque connaît les deux langages peut facilement les modifier. Dans bcc/tools il y a 80 scripts Python, ce qui laisse entendre qu'un développeur ou un administrateur système pourra probablement trouver quelque chose de adapté à son problème.
Pour obtenir au moins une idée générale du travail que font les VFS dans un système en fonctionnement, essayez vfscount ou vfsstat. Cela montrera, par exemple, que des dizaines d'appels vfs_open() et ses « amis » se produisent littéralement chaque seconde.
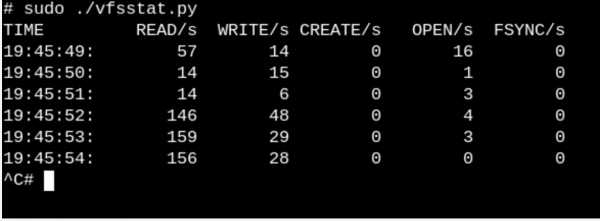
vfsstat.py– est un script en Python, avec des insertions de code en C, qui compte simplement les appels de fonctions VFS.
Prenons un exemple plus trivial et voyons ce qui se passe quand nous insérons une clé USB dans l'ordinateur et que le système la détecte.
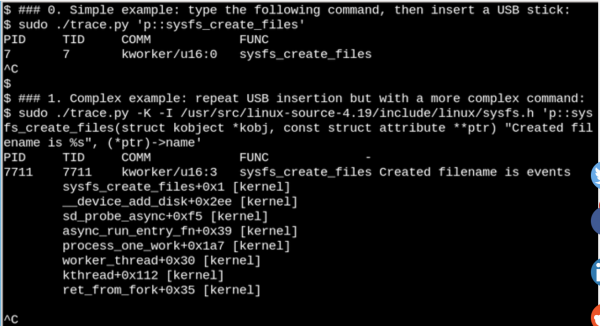
Avec eBPF, nous pouvons observer ce qui se passe dans
/sys, lors de l'insertion d'une clé USB. Voici un exemple simple et un exemple complexe.
Dans l'exemple montré ci-dessus, bcc l'outil affiche un message lorsque la commande sysfs_create_files(). Nous voyons qu'elle a été lancée par sysfs_create_files() kworker dans un flux en réponse à l'insertion de la clé, mais quel fichier a été créé ? Le deuxième exemple montre toute la puissance d'eBPF. Ici flux en réponse à l'insertion de la clé USB, mais quel fichier a été créé dans ce cas ? Le deuxième exemple montre toute la puissance d'eBPF. Ici trace.py affiche la trace de retour du noyau (kernel backtrace) (option -K) et le nom du fichier qui a été créé sysfs_create_files(). L'insertion dans les déclarations uniques est un code en C, incluant une chaîne de format facilement reconnaissable, fournie par un script Python qui lance LLVM compilateur just-in-time. Cette chaîne est compilée et exécutée dans une machine virtuelle à l'intérieur du noyau. La signature complète de la fonction sysfs_create_files() doit être reproduite dans la seconde commande pour que la chaîne de format puisse faire référence à un des paramètres. Les erreurs dans ce fragment de code C entraînent des erreurs reconnaissables du compilateur C. Par exemple, si le paramètre -l est manquant, vous verrez « Failed to compile BPF text. » Les développeurs qui sont familiers avec C et Python trouveront les outils bcc faciles à étendre et à modifier.
Lorsque la clé USB est insérée, la trace de retour du noyau montrera que le PID 7711 est le flux dans un flux en réponse à l'insertion de la clé, mais quel fichier a été créé ? Le deuxième exemple montre toute la puissance d'eBPF. Ici, qui a créé le fichier « events » dans sysfs. En conséquence, l'appel avec sysfs_remove_files() montrera que le retrait du périphérique a entraîné la suppression du fichier events, ce qui correspond au concept général de comptage des références. Ainsi, l'examen de sysfs_create_link() avec eBPF lors de l'insertion de la clé USB montrera qu'au moins 48 liens symboliques ont été créés.
Quelle est donc la signification du fichier events ? L'utilisation de pour rechercher , montre qu'il appelle disk_add_events(), et soit "media_change", ou bien "eject_request" peuvent être enregistrés dans le fichier des événements. Ici, la couche de blocs du noyau informe l'espace utilisateur de l'apparition et du retrait du « disque ». Notez à quel point cette méthode d'investigation est informative, par rapport aux tentatives de comprendre comment tout fonctionne uniquement à partir des sources.
Les systèmes de fichiers racine en lecture seule rendent possibles les dispositifs intégrés
Bien sûr, personne ne éteint le serveur ou son ordinateur en tirant la prise de la prise. Mais pourquoi ? C'est parce que les systèmes de fichiers montés sur des dispositifs de stockage physiques peuvent avoir des écritures en attente, et les structures de données enregistrant leur état peuvent ne pas se synchroniser avec les enregistrements dans le stockage. Lorsque cela se produit, les propriétaires du système doivent attendre le prochain démarrage pour exécuter l'outil fsck filesystem-recovery et, dans le pire des cas, perdre des données.
Néanmoins, nous savons tous que de nombreux appareils IoT, ainsi que des routeurs, thermostats et automobiles, fonctionnent désormais sous Linux. Beaucoup de ces appareils n'ont pratiquement pas d'interface utilisateur, et il n'y a aucun moyen de les éteindre « proprement ». Imaginez démarrer une voiture avec une batterie déchargée, lorsque l'alimentation de l'appareil de contrôle est en permanence instable. Comment se fait-il que le système démarre sans un long fsck, lorsque le moteur commence enfin à fonctionner ? La réponse est simple. Les appareils embarqués s'appuient sur un système de fichiers racine (abrégé ro-rootfs (système de fichiers racine en lecture seule)).
ro-rootfs offrent de nombreux avantages moins évidents que ne le sont l'authenticité. L'un des avantages est que les logiciels malveillants ne peuvent pas écrire dans /usr ou /lib, si aucun processus Linux ne peut y écrire. Un autre avantage est qu'un système de fichiers largement immuable est crucial pour le support sur le terrain des appareils distants, car le personnel de support utilise des systèmes locaux qui sont nominalement identiques aux systèmes sur place. Peut-être que l'avantage le plus important (mais aussi le plus sournois) est que le ro-rootfs oblige les développeurs à décider quels objets système seront immuables, dès la phase de conception du système. Travailler avec le ro-rootfs peut être gênant et douloureux, comme c'est souvent le cas avec les variables const dans les langages de programmation, mais leurs avantages compensent facilement les frais supplémentaires.
Création rootfs en lecture seule demande quelques efforts supplémentaires de la part des développeurs de systèmes embarqués, et c'est ici qu'intervient le VFS. Linux exige que les fichiers dans /var soient accessibles en écriture, et de plus, de nombreuses applications populaires qui exécutent des systèmes embarqués tenteront de créer des fichiers de configuration dot-files dans $HOME. L'une des solutions pour les fichiers de configuration dans le répertoire personnel consiste généralement à les générer à l'avance et à les assembler dans rootfs. Pour /var une approche possible consiste à le monter dans une partition distincte, accessible en écriture, tandis que lui-même / monté en lecture seule. Une autre alternative populaire consiste à utiliser des montages liés ou superposés (bind or overlay mounts).
Montages liés et superposés, utilisés par les conteneurs.
Exécution de la commande. man mount est le meilleur moyen de connaître les montages liés et superposés, qui permettent aux développeurs et aux administrateurs système de créer un système de fichiers à un chemin, puis de le rendre disponible aux applications à un autre. Pour les systèmes embarqués, cela signifie la possibilité de stocker des fichiers dans /var une clé USB accessible en lecture seule, mais le montage superposé ou lié à partir de tmpfs dans /var au démarrage permettra aux applications d'y écrire des notes (scrawl). Lors du prochain démarrage, les modifications dans /var seront perdues. Le montage superposé crée une union entre tmpfs et le système de fichiers sous-jacent, permettant des modifications apparentes des fichiers existants dans ro-tootf tandis que le montage lié peut rendre de nouveaux dossiers vides visibles comme étant accessibles en écriture dans tmpfs les chemins. Alors que ro-rootfs overlayfs est le type de système de fichiers correct ( proper) le montage lié est réalisé dansl'espace de noms VFS. .
les conteneurs Linux systemd-nspawn mountsnoop. L'appel à partir de bcc.
de system-nspawn lance le conteneur au moment où mountsnoop.py Voyons ce que cela donne :.
durant le « démarrage » du conteneur, il montre que l'environnement d'exécution du conteneur dépend fortement du montage lié (Seule le début d'une longue sortie est affiché).
Lancement L'appel fournit des fichiers sélectionnés dans
Ici pour exécuter un conteneur, en utilisant l'outil procfs de l'hôte dans le conteneur sous forme de chemins dans son et sysfs . En plus du rootfsdrapeau MS_BIND, qui définit le montage lié, d'autres drapeaux dans le système monté déterminent la relation entre les changements dans l'espace de noms de l'hôte et du conteneur. Par exemple, le montage lié peut soit laisser passer les changements dans dans le conteneur, soit les cacher, en fonction de l'appel. le drapeau qui établit le montage lié, certains autres drapeaux dans le système monté définissent la relation entre les modifications dans l'espace de noms hôte et le conteneur. Par exemple, le montage lié peut soit ignorer les modifications dans /proc et /sys le conteneur, soit les masquer en fonction de l'appel.
Conclusion
Comprendre le fonctionnement interne de Linux peut sembler une tâche impossible, car le noyau lui-même contient une quantité gigantesque de code, sans parler des applications de l'espace utilisateur de Linux et des interfaces d'appels système dans les bibliothèques C telles que glibc. L'un des moyens de progresser est de lire le code source d'un sous-système du noyau en se concentrant sur la compréhension des appels système et des en-têtes adressés à l'espace utilisateur, ainsi que sur les principales interfaces internes du noyau, comme la table file_operations. Les opérations sur les fichiers assurent le principe selon lequel « tout est fichier », donc leur gestion est particulièrement agréable. Les fichiers source du noyau en C se trouvent dans le répertoire supérieur fs/ qui représentent l'implémentation des systèmes de fichiers virtuels, qui forment une couche d'abstraction permettant une large et relativement simple compatibilité des systèmes de fichiers et des appareils de stockage populaires. Le montage par liaison et l'utilisation de namespaces sous Linux, c'est la magie du VFS qui rend possible la création de conteneurs et de systèmes de fichiers racines en lecture seule. Couplé à l'étude du code source, l'outil du noyau eBPF et son interface bcc
facilitent l'exploration du noyau plus que jamais.
Amis, dites-nous si cet article vous a été utile ? Peut-être avez-vous des commentaires ou des remarques ? Et ceux qui sont intéressés par le cours « Administrateur Linux », nous vous invitons à notre , qui se déroulera le 18 avril.
Source : habr.com
