

SciPy (se prononce « sight pie ») est un ensemble de procédures mathématiques appliquées basé sur l'extension Numpy de Python. Avec SciPy, une session interactive Python se transforme en un environnement complet pour le traitement de données et le prototypage de systèmes complexes similaire à MATLAB, IDL, Octave, R-Lab et SciLab. Aujourd'hui, je vais brièvement expliquer comment appliquer certains des algorithmes d'optimisation connus dans le module scipy.optimize. Des informations plus détaillées et pertinentes sur l'utilisation des fonctions peuvent toujours être obtenues avec la commande help() ou avec Shift+Tab.
Introduction
Afin d'épargner à moi-même et à mes lecteurs la recherche et la lecture des sources d'origine, les liens vers les descriptions des méthodes renverront principalement à Wikipédia. En général, ces informations suffisent pour comprendre les méthodes dans leurs grandes lignes et les conditions de leur application. Pour saisir la substance des méthodes mathématiques, nous suivrons les liens vers des publications plus autorisées, que vous pouvez trouver à la fin de chaque article ou dans votre moteur de recherche préféré.
Le module scipy.optimize comprend la mise en œuvre des procédures suivantes :
- Minimisation conditionnelle et non conditionnelle de fonctions scalaires de plusieurs variables (minim) à l'aide de divers algorithmes (simplexe de Nelder-Mead, BFGS, gradients conjugués de Newton, et )
- Optimisation globale (par exemple : , )
- Minimisation des résidus (least_squares) et algorithmes d'ajustement de courbes par MCO non linéaire (curve_fit)
- Minimisation de fonctions scalaires à une variable (minim_scalar) et recherche de racines (root_scalar)
- Résolveurs multi-dimensionnels de systèmes d'équations (root) utilisant divers algorithmes (hybride de Powell, ou des méthodes à grande échelle, telles que ).
Dans cet article, nous n'examinerons que le premier point de cette liste.
Minimisation non conditionnelle de fonctions scalaires de plusieurs variables
La fonction minim du module scipy.optimize fournit une interface générale pour résoudre des problèmes de minimisation conditionnelle et non conditionnelle de fonctions scalaires de plusieurs variables. Pour démontrer son fonctionnement, nous aurons besoin d'une fonction appropriée de plusieurs variables que nous allons minimiser de différentes manières.
Pour ces objectifs, la fonction de Rosenbrock de N variables convient parfaitement, qui a la forme :

Bien que la fonction de Rosenbrock et ses matrices de Jacobi et de Hessienne (première et deuxième dérivées respectivement) soient déjà définies dans le paquet scipy.optimize, définissons-la nous-mêmes.
import numpy as np

def rosen(x):
    """La fonction de Rosenbrock"""
    return np.sum(100.0*(x[1:]-x[:-1]**2.0)**2.0 + (1-x[:-1])**2.0, axis=0)
Pour la clarté, traçons en 3D les valeurs de la fonction de Rosenbrock en fonction de deux variables.
Code pour le tracé
from mpl_toolkits.mplot3d import Axes3D
import matplotlib.pyplot as plt
from matplotlib import cm
from matplotlib.ticker import LinearLocator, FormatStrFormatter

# Configurer le graphique 3D
fig = plt.figure(figsize=[15, 10])
ax = fig.gca(projection='3d')

# Définir l'angle de vue
ax.view_init(45, 30)

# Créer des données pour le graphique
X = np.arange(-2, 2, 0.1)
Y = np.arange(-1, 3, 0.1)
X, Y = np.meshgrid(X, Y)
Z = rosen(np.array([X,Y]))

# Dessiner la surface
surf = ax.plot_surface(X, Y, Z, cmap=cm.coolwarm)
plt.show()
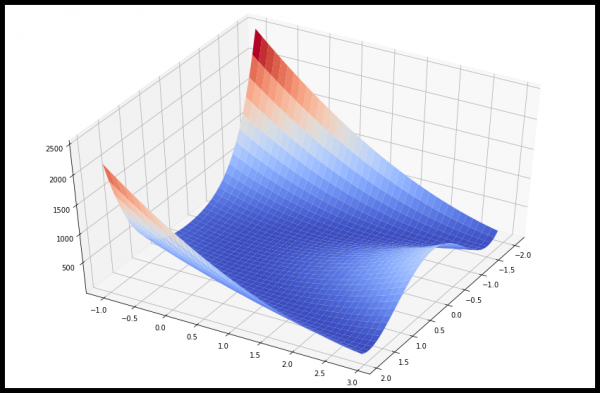
Sachant d'avance que le minimum est 0 lorsque  , examinons des exemples de la façon de déterminer la valeur minimale de la fonction de Rosenbrock à l'aide de différentes procédures de scipy.optimize.
Méthode du simplexe de Nelder-Mead
Supposons qu'un point initial x0 existe dans l'espace à 5 dimensions. Trouvons le point le plus proche de celui-ci qui minimise la fonction de Rosenbrock en utilisant l'algorithme (l'algorithme est spécifié comme valeur du paramètre method):
from scipy.optimize import minimize
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='nelder-mead',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
L'optimisation s'est terminée avec succès.
Valeur actuelle de la fonction : 0.000000
Itérations : 339
Évaluations de la fonction : 571
[1. 1. 1. 1. 1.]La méthode du simplexe est la manière la plus simple de minimiser une fonction clairement définie et assez lisse. Elle ne nécessite pas le calcul des dérivées de la fonction, il suffit de spécifier ses valeurs. La méthode de Nelder-Mead est un bon choix pour des problèmes d'optimisation simples. Cependant, comme elle n'utilise pas d'estimations de gradient, elle peut nécessiter plus de temps pour trouver le minimum.
Méthode de Powell
Un autre algorithme d'optimisation qui ne calcule que les valeurs de la fonction est . Pour l'utiliser, il faut définir method = 'powell' dans la fonction minim.
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='powell',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
L'optimisation s'est terminée avec succès.
Valeur actuelle de la fonction : 0.000000
Itérations : 19
Évaluations de la fonction : 1622
[1. 1. 1. 1. 1.]Algorithme de Broyden-Fletcher-Goldfarb-Shanno (BFGS)
Pour obtenir une convergence plus rapide vers la solution, la procédure utilise le gradient de la fonction objectif. Le gradient peut être défini en tant que fonction ou calculé à l'aide de différences de premier ordre. Dans tous les cas, la méthode BFGS nécessite généralement moins d'appels de fonction que la méthode du simplex.
Calculons la dérivée de la fonction de Rosenbrock sous forme analytique :


Cette expression est valable pour les dérivées de toutes les variables, sauf la première et la dernière, qui sont définies comme suit :


Regardons la fonction Python qui calcule ce gradient :
def rosen_der(x):
    xm = x[1: -1]
    xm_m1 = x[: -2]
    xm_p1 = x[2:]
    der = np.zeros_like(x)
    der[1: -1] = 200 * (xm - xm_m1 ** 2) - 400 * (xm_p1 - xm ** 2) * xm - 2 * (1 - xm)
    der[0] = -400 * x[0] * (x[1] - x[0] ** 2) - 2 * (1 - x[0])
    der[-1] = 200 * (x[-1] - x[-2] ** 2)
    return der
La fonction de calcul du gradient est spécifiée en tant que valeur du paramètre jac de la fonction minim, comme indiqué ci-dessous.
res = minimize(rosen, x0, method='BFGS', jac=rosen_der, options={'disp': True})
print(res.x)
L'optimisation a été terminée avec succès.
Valeur actuelle de la fonction : 0.000000
Itérations : 25
Évaluations de fonction : 30
Évaluations de gradient : 30
[1.00000004 1.0000001 1.00000021 1.00000044 1.00000092]L'algorithme des gradients conjugués (de Newton)
L'algorithme est une méthode modifiée de Newton.
La méthode de Newton est basée sur l'approximation de la fonction dans une région locale par un polynôme de deuxième degré :

où  est la matrice des deuxième dérivées (matrice Hessienne, hessien).
Si le hessien est défini positivement, alors le minimum local de cette fonction peut être trouvé en égalant le gradient nul de la forme quadratique à zéro. En conséquence, nous obtenons l'expression :

Le hessien inversé est calculé à l'aide de la méthode des gradients conjugués. Un exemple d'utilisation de cette méthode pour minimiser la fonction de Rosenbrock est donné ci-dessous. Pour utiliser la méthode Newton-CG, il est nécessaire de spécifier une fonction qui calcule le hessien.
Le hessien de la fonction de Rosenbrock sous forme analytique est :


où  et
 , définit la matrice
 .
Les autres éléments non nuls de la matrice sont :


Par exemple, dans un espace de dimension cinq N = 5, la matrice Hessienne pour la fonction de Rosenbrock a un aspect de bande :

Le code qui calcule ce hessien ainsi que le code pour minimiser la fonction de Rosenbrock à l'aide de la méthode des gradients conjugués (de Newton) :
def rosen_hess(x):
    x = np.asarray(x)
    H = np.diag(-400*x[:-1],1) - np.diag(400*x[:-1],-1)
    diagonal = np.zeros_like(x)
    diagonal[0] = 1200*x[0]**2-400*x[1]+2
    diagonal[-1] = 200
    diagonal[1:-1] = 202 + 1200*x[1:-1]**2 - 400*x[2:]
    H = H + np.diag(diagonal)
    return H

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hess=rosen_hess,
               options={'xtol': 1e-8, 'disp': True})
print(res.x)
L'optimisation s'est terminée avec succès.
Valeur actuelle de la fonction : 0.000000
Itérations : 24
Évaluations de la fonction : 33
Évaluations du gradient : 56
Évaluations de la hessienne : 24
[1. 1. 1. 0.99999999 0.99999999]Exemple de définition de la fonction de produit de la hessienne et d'un vecteur arbitraire
Dans les problèmes réels, le calcul et le stockage de l'ensemble de la matrice de Hessienne peuvent nécessiter des ressources significatives en temps et en mémoire. Néanmoins, il n'est en fait pas nécessaire de spécifier la matrice de Hessienne elle-même, car la procédure de minimisation n'a besoin que du vecteur égal au produit de la Hessienne avec un autre vecteur arbitraire. Ainsi, d'un point de vue computationnel, il est beaucoup plus judicieux de définir directement une fonction qui renvoie le résultat du produit de la Hessienne avec un vecteur arbitraire.
Considérons la fonction hess, qui prend le vecteur de minimisation comme premier argument et un vecteur arbitraire comme deuxième argument (avec d'autres arguments de la fonction minimisée). Dans notre cas, calculer le produit de la Hessienne de la fonction de Rosenbrock avec un vecteur arbitraire n'est pas très compliqué. Si p — un vecteur arbitraire, alors le produit  est donné par :

La fonction calculant le produit de la Hessienne et d'un vecteur arbitraire est transmise comme valeur de l'argument hessp à la fonction minimize :
def rosen_hess_p(x, p):
    x = np.asarray(x)
    Hp = np.zeros_like(x)
    Hp[0] = (1200*x[0]**2 - 400*x[1] + 2)*p[0] - 400*x[0]*p[1]
    Hp[1:-1] = -400*x[:-2]*p[:-2]+(202+1200*x[1:-1]**2-400*x[2:])*p[1:-1]
    -400*x[1:-1]*p[2:]
    Hp[-1] = -400*x[-2]*p[-2] + 200*p[-1]
    return Hp

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'xtol': 1e-8, 'disp': True})
L'optimisation s'est terminée avec succès.
         Valeur actuelle de la fonction : 0.000000
         Itérations : 24
         Évaluations de la fonction : 33
         Évaluations du gradient : 56
         Évaluations de la hessienne : 66
L'algorithme de zone de confiance (trust region) pour les gradients conjugués (Newton)
Une mauvaise condition de la matrice de Hessienne et des directions de recherche incorrectes peuvent faire que l'algorithme des gradients conjugués de Newton peut être inefficace. Dans de tels cas, on préfère (trust-region) pour les gradients conjugués de Newton.
Exemple de définition de la matrice de Hessen :
res = minimize(rosen, x0, method='trust-ncg',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
print(res.x)
L'optimisation a été terminée avec succès.
Valeur actuelle de la fonction : 0.000000
Itérations : 20
Évaluations de la fonction : 21
Évaluations du gradient : 20
Évaluations de la hessienne : 19
[1. 1. 1. 1. 1.]Exemple avec la fonction produit de la hessienne et d'un vecteur arbitraire :
res = minimize(rosen, x0, method='trust-ncg',
                jac=rosen_der, hessp=rosen_hess_p,
                options={'gtol': 1e-8, 'disp': True})
print(res.x)
L'optimisation a été terminée avec succès.
Valeur actuelle de la fonction : 0.000000
Itérations : 20
Évaluations de la fonction : 21
Évaluations du gradient : 20
Évaluations de la hessienne : 0
[1. 1. 1. 1. 1.]Méthodes de type Krylov
Tout comme la méthode trust-ncg, les méthodes de type Krylov sont bien adaptées à la résolution de problèmes à grande échelle, car elles n'utilisent que des produits matriciels et vectoriels. Leur principe repose sur la résolution d'un problème dans une zone de confiance, limitée par un sous-espace Krylov tronqué. Pour les problèmes indéfinis, il est préférable d'utiliser cette méthode, car elle nécessite moins d'itérations non linéaires grâce à un moindre nombre de produits matriciels et vectoriels par sous-problème, par rapport à la méthode trust-ncg. De plus, la solution du sous-problème quadratique est trouvée plus précisément que par la méthode trust-ncg.
Exemple de définition de la matrice de Hessen :
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})

L'optimisation a été terminée avec succès.
         Valeur actuelle de la fonction : 0.000000
         Itérations : 19
         Évaluations de la fonction : 20
         Évaluations du gradient : 20
         Évaluations de la hessienne : 18

print(res.x)

    [1. 1. 1. 1. 1.]
Exemple avec la fonction produit de la hessienne et d'un vecteur arbitraire :
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'gtol': 1e-8, 'disp': True})

L'optimisation a été terminée avec succès.
         Valeur actuelle de la fonction : 0.000000
         Itérations : 19
         Évaluations de la fonction : 20
         Évaluations du gradient : 20
         Évaluations de la hessienne : 0

print(res.x)

    [1. 1. 1. 1. 1.]
Algorithme de résolution approchée dans la zone de confiance
Tous les méthodes (Newton-CG, trust-ncg et trust-krylov) sont bien adaptées à la résolution de problèmes à grande échelle (avec des milliers de variables). Cela est dû au fait que l'algorithme sous-jacent de gradient conjugué implique la recherche approximative de la matrice inverse de la hessienne. La solution est trouvée de manière itérative, sans décomposition explicite de la hessienne. Comme il suffit de définir la fonction pour le produit de la hessienne et d'un vecteur quelconque, cet algorithme est particulièrement efficace pour travailler avec des matrices clairsemées (diagonales en bande). Cela permet de réduire la consommation de mémoire et d'économiser considérablement du temps.
Dans les problèmes de taille moyenne, les coûts de stockage et de factorisation du hessien ne sont pas déterminants. Cela signifie qu'il est possible d'obtenir une solution en moins d'itérations, en résolvant presque précisément les sous-problèmes de la région de confiance. Pour cela, certaines équations non linéaires sont résolues de manière itérative pour chaque sous-problème quadratique. Cette solution nécessite généralement 3 ou 4 décompositions de Cholesky de la matrice Hessienne. En conséquence, la méthode converge en moins d'itérations et nécessite moins d'évaluations de la fonction objectif que d'autres méthodes de région de confiance implémentées. Cet algorithme implique uniquement la définition de la matrice Hessienne complète et ne prend pas en charge l'utilisation de la fonction de produit du hessien et d'un vecteur arbitraire.
Exemple de minimisation de la fonction de Rosenbrock :
res = minimize(rosen, x0, method='trust-exact',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
res.x
L'optimisation s'est terminée avec succès.
Valeur actuelle de la fonction : 0.000000
Itérations : 13
Évaluations de la fonction : 14
Évaluations du gradient : 13
Évaluations du Hessien : 14
array([1., 1., 1., 1., 1.])Nous allons nous arrêter là pour le moment. Dans le prochain article, j'essaierai de partager les aspects les plus intéressants de la minimisation conditionnelle, de l'application de la minimisation à la résolution de problèmes d'approximation, de la minimisation de fonctions à une variable, des minimisateurs arbitraires, et de la recherche de racines de systèmes d'équations à l'aide du paquet scipy.optimize.
Source :
Source : habr.com
