

Ding! Il est 3 heures du matin, vous êtes en train de faire un merveilleux rêve, et tout à coup – un appel. Cette semaine, c'est votre tour, et il semble que quelque chose se soit produit. Le système automatisé vous appelle pour comprendre ce qui se passe. C'est un moment crucial dans la gestion des systèmes informatiques modernes, mais voyons comment rendre les notifications plus conviviales pour les humains.
Découvrez la philosophie de la surveillance qui a émergé au cours de mes décennies de services dans différentes équipes de monitoring. Elle a été largement influencée par la véritable bible de Rob Evaschuk. (Ma philosophie des notifications), incluse dans le livre sur , et le livre de John Oltsvow (Remarques sur le réglage des notifications).
, et – merci pour votre aide à la rédaction de cet article.
Qu'est-ce que le CASE?
J'ai décidé de créer un acronyme élégant, comme celui de ou Je l'appelle méthode CASE.Elle décrit quatre points auxquels il faut faire attention lors de l'utilisation d'une surveillance automatisée :
- (orientation contextuelle)
- (valeur pratique)
- (accent sur les symptômes)
- (évaluation)
Si vous utilisez le CASE, vous adoptez une attitude saine envers les notifications et ne réveillez pas les gens la nuit. Il est essentiel de réévaluer régulièrement la surveillance en termes d'utilité et d'efficacité. Lorsqu'une personne reçoit une notification, elle sera mieux armée mentalement et aura plus de confiance.
Pour mieux s'en souvenir, imaginez que vous avez besoin d'un CASE [c'est-à-dire un cas, une raison — note du traducteur], pour justifier chaque alerte. :sunglasses:
Et pourquoi tout ça?
Pour de nombreuses raisons. Et le CASE ne pourra pas les éliminer toutes. Mais avec lui, vous vous réveillerez la nuit avec des notifications de meilleure qualité. Cette méthode couvre différents processus organisationnels qui contribueront également à cet objectif.
La beauté des méthodes RED et USE est qu'elles nous permettent non seulement de savoir comment travailler, mais aussi de communiquer dans le même langage. J'espère qu'avec la méthode CASE, il sera plus facile de discuter des notifications qui protègent nos systèmes sans déranger nos collègues.
L'essentiel est de créer dans l'organisation une culture où les notifications sont accueillies avec un certain détachement. Les notifications peuvent être émises à bon escient, mais il n'est pas garanti qu'elles conservent leur valeur par la suite. Pourquoi avons-nous configuré cette notification ? Quand ses critères ont-ils été révisés pour la dernière fois ? Avec un CASE, on peut trouver des réponses à ces questions.
Contextuel — ancrage dans le contexte
3 heures du matin — ce n'est pas le meilleur moment pour lire des messages remplis de mots compliqués. Pour réagir efficacement, il faut de l'information. Idéalement, cela doit être des informations sur un problème spécifique où le contexte est immédiatement clair, et il faut configurer les notifications de manière à ce que cela soit possible. C'est « observation » et « orientation » issus du . Cette configuration mérite qu'on y consacre du temps, car perturber une personne constamment coûte encore plus cher. Respectons-nous mutuellement.
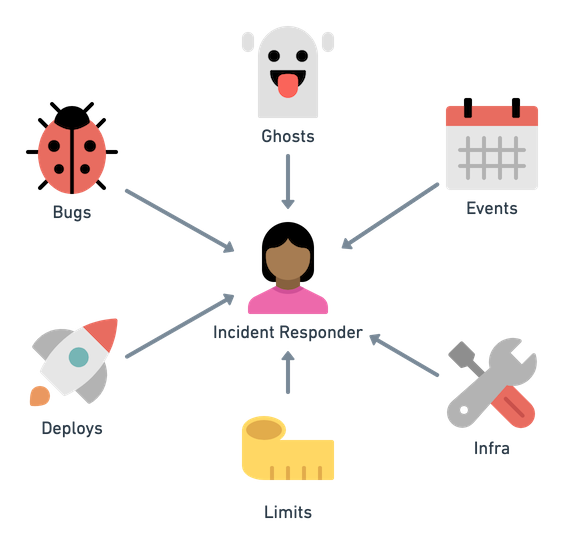
Il y a de nombreuses sources de problèmes. Surtout des fantômes.
Comment aider le responsable ? En premier lieu, le responsable voit la notification, donc toutes ses hypothèses sont basées sur cela. Ensuite, il consulte les instructions et les tableaux de bord, mais y a-t-il toujours des données spécifiques liées à cette notification, et non simplement des informations générales ? Olspo conseille de « réfléchir à la manière d'interpréter la notification ou d'y réagir » (diapositive 29). Une bonne notification est orientée vers le responsable, et non simplement réglée sur un seuil.
Voici donc des idées pour améliorer le contexte des notifications :
- Montrez à l'utilisateur quelque chose d'utile et créé spécifiquement, plutôt que de simples instructions ou un tableau de bord ordinaire. Autrefois, nous utilisions des tableaux de bord pour l'investigation, adaptés à des notifications spécifiques. Cela aide si le problème est connu, mais en d'autres cas, cela pourrait être déroutant. Il faut trouver un équilibre.
- Racontez l'historique de la notification : est-elle nouvelle ? S'active-t-elle fréquemment ? Est-elle saisonnière ?
- Montrez les changements récents dans l'état du système. Quelque chose a-t-il changé récemment ? (Par exemple, déploiement ou activation/désactivation de fonctionnalités.)
- Montrez les relations et donnez des informations pour un modèle mental : les dépendances du système doivent être clairement visibles, de préférence avec indication de la fonctionnalité.
- Mettez rapidement l'utilisateur en contact avec l'équipe : voit-il les incidents en cours ou peut-il savoir qui d'autre dans l'entreprise a reçu la notification ? Le programme activé?
Idéalement, le programme de gestion des incidents fournit des conseils pour améliorer le contexte des notifications lors de l'enquête sur les incidents. Il y a toujours du travail à faire !
Actionnable — valeur pratique
Le surveillant doit-il faire quelque chose en réponse à la notification ? Si aucune action n'est nécessaire ou s'il n'est pas clair quoi faire, pourquoi avoir réveillé ? Il faut éviter les notifications qui dérangent les surveillants sans nécessiter d'actions.
Que faire alors ? Que faut-il ?
Auparavant, lorsque les systèmes étaient simples et les équipes petites, nous configurions la surveillance juste pour être au courant des événements. Une notification indiquant qu'une charge a augmenté fournira du contexte si ensuite le service rencontre des pannes. À grande échelle, ce type de notification ne fait qu'embrouiller, car nos systèmes fonctionnent toujours dans un état de dégradation de gravité variable. Cela conduit rapidement à et, bien sûr, à une perte de sensibilité. Ainsi, le surveillant ignore ou filtre même de telles notifications et ne réagit pas toujours comme il le faudrait. Ne tombez pas dans ce piège ! Ne configurez pas toutes les notifications pour ensuite les envoyer par e-mail dans un dossier oublié de Dieu.
Voici à quoi ressemble une notification avec une valeur pratique :
- La notification nécessite une action, plutôt que de simplement transmettre des nouvelles.
- Cette action est difficile ou risquée à automatiser. Si l'action peut être automatisée, alors allez-y et automatisez-la, arrêtez de déranger les gens !
- La notification contient des recommandations urgentes sous forme de (SLA) ou (RTO). Cela permet au surveillant d'activer le programme de gestion des incidents dans l'organisation.
Je tiens à préciser : je ne dis pas que les notifications doivent arriver uniquement pour les SLO (objectifs de niveau de service) les plus critiques pour l'API. La surveillance des SLO est constamment décomposée et séparée et nécessite une approche uniforme pour tous les services. Il est évident que vous suivrez les SLO les plus importants pour les clients qui vous rémunèrent. Mais les SLO d'infrastructure, comme les bases de données, doivent également être surveillés. Bientôt, vous devrez vous occuper des clients internes et les soutenir. Et cela sans fin.
Basé sur les symptômes — accent sur les symptômes
Que vous le vouliez ou non, vous travaillez dans un système distribué (Kavadj). En conséquence, vous utilisez différentes tactiques pour isoler les services et les protéger des pannes (Treynor et al.) 3. Et bien qu'une collecte de déchets prolongée ou une requête de base de données en attente puissent indiquer des problèmes, il n'est pas nécessaire de s'emporter pour les résoudre si cela n'affecte pas les utilisateurs dans un proche avenir.
Ce sont des signaux importants, et ils peuvent avoir une valeur pratique, mais s'ils ne nuisent pas aux utilisateurs, ce n'est pas si urgent qu'il faille en détourner le surveillant. Les notifications basées sur des raisons sont des instantanés de nos modèles mentaux sur les pannes systémiques. Il vaut mieux suivre des symptômes importants que d'essayer de lister toutes les causes possibles d'une défaillance.
Pour que les notifications aient une valeur pratique, concentrez-vous sur , qui sont importants pour les utilisateurs. Evashchuk appelle cela « la surveillance pour les utilisateurs ». N'oubliez pas que cette philosophie doit être appliquée dans toute l'organisation. Si un service rencontre des problèmes urgents quelque part dans l'infrastructure, l'équipe appropriée s'en occupera. La protection des systèmes contre de telles pannes est une question complètement différente (Treynor et al., section sur les stratégies de minimisation des dépendances critiques).
Les symptômes ne sont pas si changeants
Richard Cook rappelle que dans les systèmes complexes, il existe de nombreuses lacunes, défauts et problèmes.Essayer de lister toutes les causes possibles est un travail de Sisyphe. Vous tentez de décrire des problèmes, mais ils changent tout le temps. Cindy Shridharan estime que « les systèmes ne doivent pas nécessairement être dans un état parfait à chaque seconde » et qu'il vaut mieux adopter une approche plus humaine ( (« Observation des systèmes distribués »), 7).
Évitez les notifications basées sur l'incident
Généralement, pour résoudre des incidents, des notifications pour les causes sont configurées. Et ces notifications limitées sur les faits créent un faux sentiment de sécurité, car le système trouve chaque fois de nouvelles façons de tomber en panne.
Ne vous laissez pas berner par les notifications sur les causes. Pensez plutôt :
- Pourquoi la notification basée sur les symptômes n'a-t-elle pas remarqué le problème ?
- Serait-il utile d'améliorer le contexte pour l'utilisateur ?
- Comment améliorer les outils de surveillance pour poser un diagnostic plus rapidement, au lieu de cumuler des alertes sur ce qui s'est passé ?
Les outils de surveillance pour le diagnostic ne vous aideront que si vous les considérez comme un moyen de passer des symptômes à la solution. Sans ce retour d'information, vous serez submergé par des alertes tardives et des graphiques sur des défaillances passées – et aucun mot sur l'avenir. C'est une excellente occasion pour l'organisation de passer de la défense à l'attaque. Les développeurs et les chefs de produit auront des attentes identiques et des objectifs clairs. Le cas – CASE (:wink:) – pour chaque notification est évident.
Les notifications fondées sur des causes sont tolérables en quantité modérée.
Parfois, notre système ne nous laisse guère le choix concernant les notifications basées sur des causes. D'autres fois, les intervenants savent parfaitement qu'un symptôme conduira inévitablement à une défaillance, ce qui lui confère une valeur pratique. Peut-être n'êtes-vous tout simplement pas sûr de ce qui se passe, et vous configurez des notifications par précaution. Espérons que cette action sera temporaire, en attendant que nous modifions le système pour aborder la question de la baisse de performance.
N'oubliez pas les autres composants de CASE lorsque vous traitez de telles situations. Le fait que ce soit temporaire ne signifie pas qu'il faille arrêter de réfléchir.
Evaluated — évaluation
Tout changement dans le système (nouveau code, nouvelle infrastructure, tout ce qui est nouveau) élargit l'éventail des défaillances (Cook, 3). Cette notification fonctionne-t-elle toujours comme prévu ? Des modèles mentaux clairs et actuels des systèmes et une expérience de réaction à certaines notifications en soutien sont des caractéristiques clés . Les défauts dans les systèmes évoluent constamment, et nous devons nous tenir à jour.
Il est nécessaire d'évaluer constamment la qualité de chaque notification afin qu'elles fonctionnent comme prévu. Chers dirigeants ! Vos équipes trouveront cela beaucoup plus facile si vous les aidez à établir ce processus ! Voici quelques idées d'évaluation :
- Windows VPS pour le travail à distance , ou d'autres méthodes de test des notifications. L'équipe peut le faire elle-même, sans avoir besoin d'un lourd système de gestion des incidents !
- Activez la collecte de données sur toutes les notifications liées aux incidents dans le programme de gestion des incidents. Notez celles qui sont utiles, nuisibles, inappropriées, incompréhensibles, etc. Utilisez-les comme retour d'expérience.
- Les notifications appropriées se déclenchent rarement et sont soigneusement vérifiées. Assurez-vous que tous les liens fonctionnent et renvoient au bon contexte, etc.
- Si une notification ne se déclenche jamais ou se déclenche trop souvent, il y a un problème. Réparez-la ou supprimez-la. Méfiez-vous de l'inactivité ou de l'activité excessive !
- Configurez des horodatages avec une date d'expiration pour les notifications. Si la date d'expiration est dépassée, évaluez la notification selon la méthode CASE et mettez à jour l'horodatage. Vérifiez régulièrement la date d'expiration, comme pour la nourriture.
- Simplifiez le processus d'amélioration des notifications. Utilisez la surveillance sous forme de code et stockez les notifications dans un dépôt Git. Les demandes de tirage aident à impliquer l'équipe, et vous aurez un historique des notifications passées. Vous n'aurez plus peur de modifier les notifications ou de demander l'autorisation à ceux qui en sont responsables.
- Établissez des retours d'expérience pour les notifications, même si ce n'est que , pour que les équipes de garde puissent signaler les notifications comme inutiles ou intrusives. Intégrez un lien ou un appel à l'action dans la notification elle-même et examinez régulièrement les retours.
- Mettez en place une règle au sein de l'équipe : laissez les équipes de garde travailler à simplifier le service lorsque le travail est léger. Qu'après vous, tout soit un peu mieux que ce que c'était avant.
Conclusion
Je pense que la méthode CASE aide les développeurs et les organisations à discuter de la configuration et de l'envoi des notifications automatiques. Un développeur peut commencer à évaluer les notifications selon la méthode CASE, puis toute l'organisation peut se joindre à lui, avec d'autres développeurs, la direction et les programmes de gestion des incidents, pour maintenir les notifications en bon état. Aucun outil particulier ou processus complexe n'est nécessaire.
L'ensemble de l'industrie doit réfléchir au facteur humain pendant le service sans compromettre un service client de premier ordre. Tous ces outils et pratiques peuvent et doivent être améliorés. J'espère que la méthode CASE aidera dans ce sens.
Profitez des notifications améliorées !
Source : habr.com
