

Bonjour, je suis Sergey Ylantsev, je développe dans Yandex.Cloud. Auparavant, j'ai dirigé le développement du répartiteur L7 du portail Yandex — mes collègues plaisantent en disant que peu importe ce que je fais, cela se transforme en répartiteur. Je vais expliquer aux lecteurs de Habr comment gérer la charge sur une plateforme cloud, quel outil idéal nous envisionnons pour atteindre cet objectif et comment nous progressons vers la création de cet outil.
Pour commencer, introduisons quelques termes :
- VIP (IP Virtuelle) — adresse IP du répartiteur
- Serveur, backend, instance — machine virtuelle avec une application en cours d'exécution
- RIP (IP Réelle) — adresse IP du serveur
- Healthcheck — vérification de la disponibilité du serveur
- Zone de disponibilité, Availability Zone, AZ — infrastructure isolée dans un centre de données
- Région — regroupement de différentes AZ
Les répartiteurs de charge résolvent trois tâches principales : ils effectuent la répartition de charge, améliorent la résilience du service et facilitent son évolutivité. La résilience est assurée par une gestion automatique du trafic : le répartiteur surveille l'état de l'application et exclut de la répartition de charge les instances qui n'ont pas réussi le healthcheck. L'évolutivité est garantie par une distribution équilibrée de la charge entre les instances ainsi que par la mise à jour dynamique de la liste des instances. Si la répartition de charge est insuffisamment équilibrée, certaines instances subiront une charge dépassant leur capacité opérationnelle, rendant le service moins fiable.
Les répartiteurs de charge sont souvent classés selon le niveau de protocole du modèle OSI sur lequel ils fonctionnent. Le répartiteur Cloud fonctionne au niveau TCP, correspondant au quatrième niveau, L4.
Passons à la présentation de l'architecture du répartiteur Cloud. Nous allons augmenter progressivement le niveau de détail. Nous classons les composants du répartiteur en trois catégories. La classe config plane gère l'interaction avec l'utilisateur et détient l'état cible du système. La classe control plane contient l'état actuel du système et gère les systèmes de la classe data plane, qui sont responsables de la livraison du trafic des clients vers vos instances.
Data plane
Le trafic passe par des appareils coûteux appelés routeurs frontières. Pour améliorer la résilience, plusieurs de ces appareils fonctionnent simultanément dans un même centre de données. Ensuite, le trafic est dirigé vers des équilibrateurs de charge, qui annoncent une adresse IP anycast à tous les AZ via BGP pour les clients.
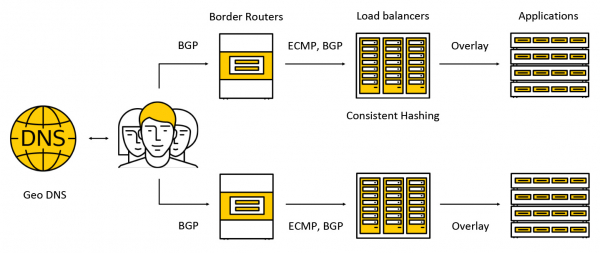
Le trafic est transmis via ECMP — une stratégie de routage permettant l'existence de plusieurs chemins également efficaces vers la destination (dans notre cas, la destination sera une adresse IP). Ainsi, les paquets peuvent être envoyés par n'importe lequel de ces chemins. De plus, nous supportons l'opération dans plusieurs zones de disponibilité selon le schéma suivant : nous annonçons l'adresse dans chaque zone, et le trafic est dirigé vers la plus proche sans sortir de cette zone. Nous examinerons plus en détail ce qui arrive au trafic plus loin dans le post.
Config plane
Le composant clé du config plane est l'API à travers laquelle les opérations principales sur les équilibrateurs de charge sont effectuées : création, suppression, modification de la composition des instances, récupération des résultats des vérifications de santé, etc. D'une part, il s'agit d'une API REST, et d'autre part, nous utilisons très souvent dans le Cloud le framework gRPC, donc nous 'traduisons' REST en gRPC et utilisons ensuite uniquement gRPC. Chaque requête entraîne la création d'une série de tâches asynchrones idempotentes, qui sont exécutées sur un pool partagé de workers de Yandex.Cloud. Les tâches sont écrites de manière à pouvoir être suspendues à tout moment et redémarrées. Cela assure la scalabilité, la répétabilité et la journalisation des opérations.
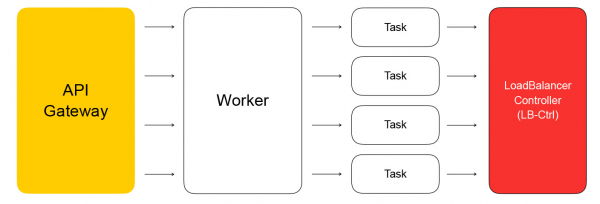
En fin de compte, la tâche de l'API fera une requête au contrôleur de service des équilibrateurs de charge, écrit en Go. Il peut ajouter et supprimer des équilibrateurs, modifier la composition des backends et les paramètres.
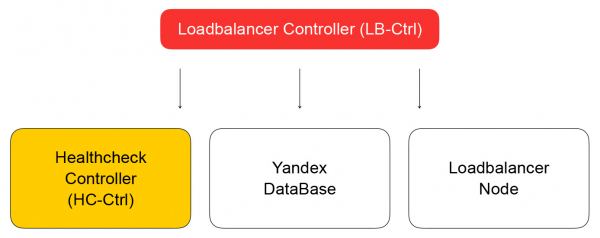
Le service conserve son état dans Yandex Database — une base de données managée distribué, que vous pourrez bientôt utiliser également. Dans Yandex.Cloud, comme nous l'avons déjà , la notion de dog food est en vigueur : si nous utilisons nos propres services, nos clients les utiliseront également avec plaisir. Yandex Database est un exemple d'implémentation de cette notion. Nous stockons toutes nos données dans YDB, et nous n'avons pas à nous soucier de la maintenance et de la scalabilité de la base : ces problèmes sont résolus pour nous, nous utilisons la base comme un service.
Revenons au contrôleur de load balancing. Sa tâche consiste à conserver des informations sur le load balancer, à transmettre la tâche de vérification de la readiness de la machine virtuelle au contrôleur de healthcheck.
Contrôleur de healthcheck
Il reçoit des demandes de modification des règles de vérification, les conserve dans YDB, répartit les tâches entre les nœuds de healthcheck et agrège les résultats qui sont ensuite enregistrés dans la base de données et envoyés au contrôleur de load balancer. Ce dernier envoie également une demande de modification de la composition du cluster dans le data plane vers le nœud de load balancer, dont je parlerai ci-dessous.
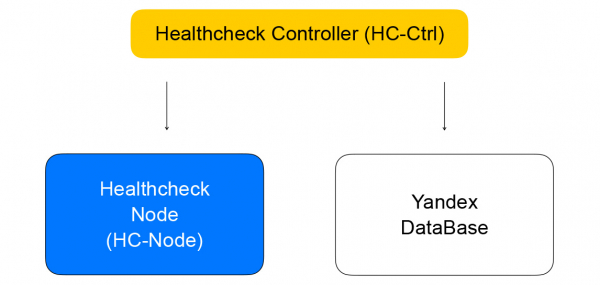
Parlons plus en détail des healthchecks. Ils peuvent être classés en plusieurs catégories. Les vérifications ont différents critères de succès. Les vérifications TCP doivent établir une connexion avec succès dans un temps défini. Les vérifications HTTP nécessitent à la fois une connexion réussie et une réponse avec le code d'état 200.
Les vérifications diffèrent également par leur classe d'action — elles peuvent être actives ou passives. Les vérifications passives surveillent simplement ce qui se passe avec le trafic sans prendre d'actions spécifiques. Cela fonctionne moins bien au niveau L4, car cela dépend de la logique des protocoles de niveau supérieur : au niveau L4, aucune information n'est fournie sur le temps que l'opération a duré, ni sur la qualité de la terminaison de la connexion. Les vérifications actives exigent que le load balancer envoie des requêtes à chaque instance du serveur.
La plupart des load balancers effectuent des vérifications de « vivacité » de manière autonome. Dans notre Cloud, nous avons décidé de séparer ces parties du système pour améliorer la scalabilité. Cette approche nous permettra d'augmenter le nombre de load balancers tout en maintenant le nombre de requêtes de healthcheck vers le service. Les vérifications sont effectuées par des nœuds de healthcheck séparés, où les cibles de vérification sont shardées et répliquées. Il est impossible d'effectuer des vérifications depuis un seul hôte, car il pourrait tomber en panne. Sinon, nous ne pourrions pas obtenir l'état des instances qu'il a vérifiées. Nous effectuons des vérifications de n'importe quelle instance à partir d'au moins trois nœuds de healthcheck. Les cibles de vérification sont shardées entre les nœuds à l'aide d'algorithmes de hachage cohérent.
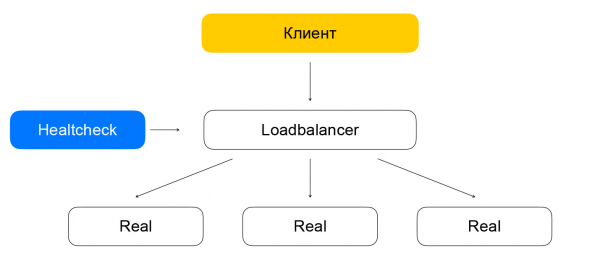
La séparation de la répartition de charge et du healthcheck peut provoquer des problèmes. Si le healthcheck node effectue des requêtes vers une instance, en contournant le répartiteur (qui ne gère actuellement pas le trafic), une situation étrange se produit : la ressource semble être vivante, mais le trafic n'y parviendra pas. Nous résolvons ce problème comme suit : nous faisons en sorte que le trafic de healthcheck passe par les répartiteurs. En d'autres termes, le schéma de circulation des paquets avec le trafic des clients et des healthchecks diffère de manière minimale : dans les deux cas, les paquets atteindront les répartiteurs, qui les livreront aux ressources cibles.
La différence est que les clients envoient des requêtes à un VIP, tandis que les healthchecks s'adressent à chaque RIP distinct. Ici, un problème intéressant se pose : nous offrons à nos utilisateurs la possibilité de créer des ressources dans des réseaux IP gris. Imaginons qu'il y ait deux propriétaires de clouds différents qui ont caché leurs services derrière des répartiteurs. Chacun d'eux possède des ressources dans le sous-réseau 10.0.0.1/24, avec les mêmes adresses. Il faut avoir un moyen de les différencier, et pour cela, il est nécessaire de plonger dans l'architecture du réseau virtuel de Yandex.Cloud. Pour plus de détails, il vaut mieux se référer à , ce qui est important pour nous, c'est que le réseau est multicouche et contient des tunnels qui peuvent être différenciés par l'id du sous-réseau.
Les nodes de healthcheck s'adressent aux répartiteurs à l'aide d'adresses supposées IPv6. Une adresse quasi est une adresse IPv6 qui renferme une adresse IPv4 et l'id du sous-réseau de l'utilisateur. Le trafic arrive sur le répartiteur, qui extrait l'adresse IPv4 de la ressource, remplace l'IPv6 par l'IPv4 et envoie le paquet dans le réseau de l'utilisateur.
Le trafic de retour fonctionne de la même manière : le répartiteur voit que la destination est un réseau gris des healthcheckers et convertit l'IPv4 en IPv6.
VPP est le cœur du data plane
Le répartiteur est basé sur la technologie Vector Packet Processing (VPP) — un framework de Cisco pour le traitement des paquets réseau. Dans notre cas, le framework fonctionne au-dessus de la bibliothèque de gestion des dispositifs réseau en user-space — Data Plane Development Kit (DPDK). Cela garantit des performances élevées dans le traitement des paquets : il y a beaucoup moins d'interruptions dans le noyau, et il n'y a pas de commutations de contexte entre le kernel space et le user space.
VPP va encore plus loin en extrayant davantage de performances du système grâce à l'agrégation des paquets en lots. L'augmentation des performances se fait grâce à une utilisation agressive des caches des processeurs modernes. On utilise à la fois des caches de données (les paquets sont traités par 'vecteurs', les données étant proches les unes des autres) et des caches d'instructions : dans VPP, le traitement des paquets suit un graphique, où les nœuds contiennent des fonctions qui effectuent une tâche spécifique.
Par exemple, le traitement des paquets IP dans VPP se déroule comme suit : d'abord, le nœud d'analyse effectue le parsing des en-têtes des paquets, puis ils sont envoyés à un nœud qui les transmet ensuite selon les tables de routage.
Un peu de hardcore. Les auteurs de VPP ne tolèrent aucun compromis dans l'utilisation des caches des processeurs, donc le code typique de traitement des vecteurs de paquets contient une vectorisation manuelle : il y a une boucle de traitement où l'on traite une situation comme 'nous avons quatre paquets dans la queue', puis — la même chose pour deux, puis — pour un seul. On utilise souvent des instructions de prélecture, chargeant les données dans les caches pour accélérer l'accès lors des itérations suivantes.
n_left_from = frame->n_vectors;
while (n_left_from > 0)
{
    vlib_get_next_frame (vm, node, next_index, to_next, n_left_to_next);
    // ...
    while (n_left_from >= 4 && n_left_to_next >= 2)
    {
        // traitement de plusieurs paquets simultanément
        u32 next0 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        u32 next1 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        // ...
        /* Prélecture de la prochaine itération. */
        {
            vlib_buffer_t *p2, *p3;

            p2 = vlib_get_buffer (vm, from[2]);
            p3 = vlib_get_buffer (vm, from[3]);

            vlib_prefetch_buffer_header (p2, LOAD);
            vlib_prefetch_buffer_header (p3, LOAD);

            CLIB_PREFETCH (p2->data, CLIB_CACHE_LINE_BYTES, STORE);
            CLIB_PREFETCH (p3->data, CLIB_CACHE_LINE_BYTES, STORE);
        }
        // traitement effectif des données
        /* vérifier les enqueues spéculatifs, peut-être changer le cadre suivant actuel */
        vlib_validate_buffer_enqueue_x2 (vm, node, next_index,
                to_next, n_left_to_next,
                bi0, bi1, next0, next1);
    }

    while (n_left_from > 0 && n_left_to_next > 0)
    {
        // traitement des paquets un par un
    }

    // lots traités
    vlib_put_next_frame (vm, node, next_index, n_left_to_next);
}
Ainsi, les Healthchecks se connectent en IPv6 à VPP, qui les convertit en IPv4. Cela est géré par un nœud du graphique que nous appelons NAT algorithmique. Pour le trafic retour (et la conversion de l'IPv6 en IPv4), il y a un nœud similaire de NAT algorithmique.
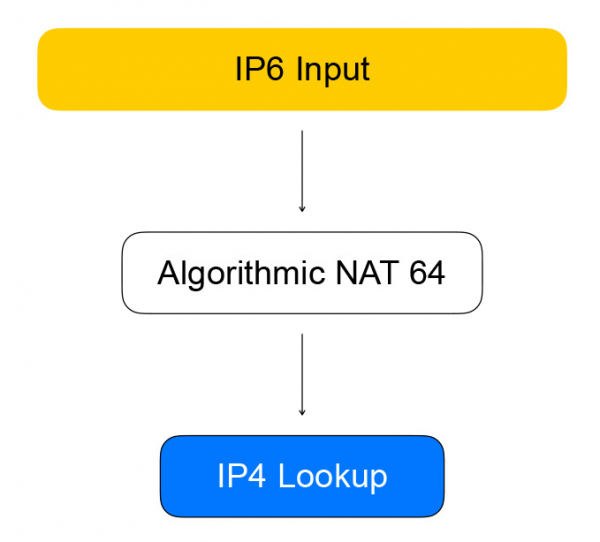
Le trafic direct des clients du répartiteur passe par des nœuds du graphique qui effectuent le processus même de répartition.
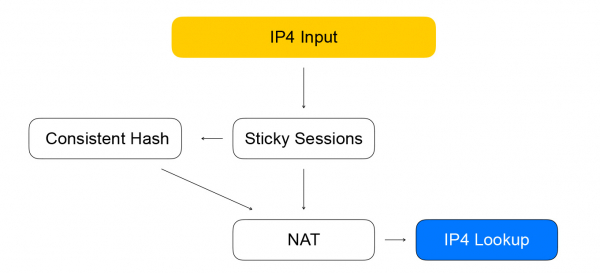
Le premier nœud — sessions persistantes. Il stocke un hachage de pour les sessions établies. Le 5-tuple comprend l'adresse et le port du client à partir desquels l'information est transmise, l'adresse et les ports des ressources disponibles pour la réception du trafic, ainsi que le protocole réseau.
Le hachage du 5-tuple nous aide à effectuer moins de calculs dans le prochain nœud de hachage cohérent, ainsi qu'à mieux gérer les modifications de la liste des ressources derrière le répartiteur de charge. Lorsqu'un paquet arrive au répartiteur de charge pour lequel il n'y a pas de session, il est envoyé au nœud de hachage cohérent. C'est là que se produit l'équilibrage à l'aide du hachage cohérent : nous choisissons une ressource dans la liste des ressources « actives » disponibles. Ensuite, les paquets sont envoyés au nœud NAT, qui effectue le remplacement réel de l'adresse de destination et le recalcul des sommes de contrôle. Comme vous le voyez, nous suivons les règles VPP — similaire à similaire, nous regroupons les calculs semblables pour augmenter l'efficacité des caches processeurs.
Hachage cohérent
Pourquoi avons-nous choisi cela et qu'est-ce que c'est au juste ? Commençons par examiner la tâche précédente — choisir une ressource dans la liste.
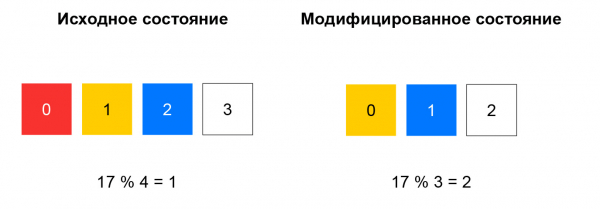
Dans le hachage non cohérent, on calcule le hachage du paquet entrant, et on choisit une ressource dans la liste en prenant le reste de la division de ce hachage par le nombre de ressources. Tant que la liste reste inchangée, ce schéma fonctionne bien : nous envoyons toujours des paquets avec le même 5-tuple à la même instance. Cependant, si, par exemple, une ressource ne répond plus aux vérifications de santé, le choix changera pour une part importante des hachages. Les connexions TCP du client seront interrompues : un paquet qui précédemment arrivait à l'instance A peut commencer à arriver à l'instance B, qui n'est pas familière avec la session pour ce paquet.
Le hachage cohérent résout ce problème décrit. La manière la plus simple d'expliquer ce concept est la suivante : imaginez que vous avez un anneau sur lequel vous répartissez les ressources par hachage (par exemple, par IP:port). Le choix d'une ressource est un tournant de la roue à un angle déterminé par le hachage du paquet.
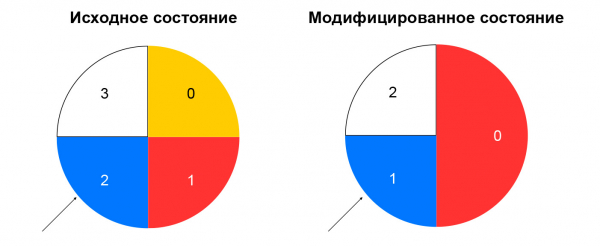
Ainsi, la redistribution du trafic lors du changement de la composition des ressources est minimisée. La suppression d'une ressource n'affectera que la partie de l'anneau de hachage cohérent où se trouvait cette ressource. L'ajout d'une ressource change également la répartition, mais nous avons un nœud de sessions persistantes qui permet de ne pas basculer les sessions établies vers de nouvelles ressources.
Nous avons examiné ce qui se passe avec le trafic direct entre le répartiteur de charge et les ressources. Maintenant, examinons le trafic inverse. Il suit le même schéma que le trafic de vérification — via un NAT algébrique, c'est-à-dire via un NAT inverse 44 pour le trafic client et un NAT 46 pour le trafic des healthchecks. Nous suivons notre propre schéma : nous unifions le trafic des healthchecks et le trafic réel des utilisateurs.
Noeud de répartiteur de charge et composants dans l'assemblage
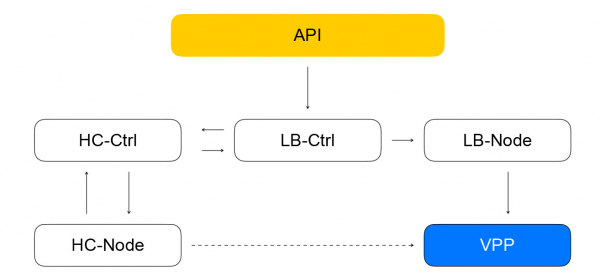
La composition des répartiteurs de charge et des ressources dans le VPP est rapportée par le service local — loadbalancer-node. Il s'abonne au flux d'événements du loadbalancer-controller, sait construire la différence entre l'état actuel du VPP et l'état cible obtenu du contrôleur. Nous obtenons un système fermé : les événements de l'API arrivent au contrôleur du répartiteur de charge, qui donne au contrôleur de healthcheck des tâches pour vérifier la « vitalité » des ressources. Ce dernier, à son tour, attribue des tâches au healthcheck-node et agrège les résultats, avant de les renvoyer au contrôleur des répartiteurs de charge. Loadbalancer-node s'abonne aux événements du contrôleur et change l'état du VPP. Dans un tel système, chaque service ne sait que ce qui est nécessaire sur les services voisins. Le nombre de liens est limité, et nous avons la possibilité d'exploiter et de dimensionner indépendamment différents segments.
Quelles questions avons-nous pu éviter
Tous nos services dans le plan de contrôle sont écrits en Go et se distinguent par de bonnes caractéristiques en matière de mise à l'échelle et de fiabilité. En Go, il existe de nombreuses bibliothèques open source pour la construction de systèmes distribués. Nous utilisons activement GRPC, tous les composants contiennent une implémentation open source de discovery de services — nos services surveillent la disponibilité les uns des autres, peuvent changer leur composition dynamiquement, et nous avons lié cela à l'équilibrage GRPC. Pour les métriques, nous utilisons également une solution open source. Dans le plan de données, nous avons obtenu de bonnes performances et une grande marge de ressources : il s'est avéré très difficile de monter un stand où l'on pouvait vraiment se heurter aux performances du VPP, et non de la carte réseau matérielle.
Problèmes et solutions
Qu'est-ce qui a mal fonctionné ? En Go, la gestion de la mémoire est automatique, mais des fuites de mémoire peuvent tout de même se produire. Le moyen le plus simple de les gérer est de lancer des goroutines et de ne pas oublier de les terminer. En résumé : surveillez la consommation de mémoire des programmes Go. Un bon indicateur est souvent le nombre de goroutines. Dans cette histoire, il y a aussi un avantage : en Go, il est facile d'obtenir des données sur le runtime - sur la consommation de mémoire, le nombre de goroutines en cours d'exécution et de nombreux autres paramètres.
De plus, Go n'est peut-être pas le meilleur choix pour les tests fonctionnels. Ils sont assez verbeux et l'approche standard de « tout lancer dans CI en un seul lot » ne leur convient pas vraiment. En effet, les tests fonctionnels sont plus gourmands en ressources et connaissent de véritables délais d'attente. À cause de cela, les tests peuvent échouer, car le CPU est occupé par les tests unitaires. En conclusion : exécutez, si possible, les tests « lourds » séparément des tests unitaires.
L'architecture événementielle microservices est plus complexe qu'un monolithe : analyser les logs sur des dizaines de machines différentes n'est pas très pratique. Conclusion : si vous faites des microservices, pensez tout de suite au traçage.
Nos plans
Nous lancerons un équilibreur de charge interne, un équilibreur de charge IPv6, ajouterons la prise en charge de scénarios Kubernetes, continuerons à shardiser nos services (actuellement, seuls healthcheck-node et healthcheck-ctrl sont shardisés), ajouterons de nouveaux healthchecks, ainsi que mettrons en œuvre une agrégation intelligente des vérifications. Nous envisageons de rendre nos services encore plus indépendants - afin qu'ils communiquent non pas directement entre eux, mais via une file de messages. Un service compatible SQS a récemment été introduit dans le Cloud. .
La sortie publique de Yandex Load Balancer a eu lieu récemment. Découvrez le service, gérez les équilibreurs de charge de la manière qui vous convient et améliorez la résilience de vos projets !
Source : habr.com
