

Préface ou comment l'idée de la section a émergé
Le début de l'histoire ici : Après que presque toutes les ressources pour optimiser la requête aient été épuisées à l'époque, la question s'est posée : que faire ensuite ? Ainsi est née l'idée de la section.
Détour lyrique :
Justement 'à l'époque', parce que . Merci et Habr !
Alors, comment rendre le client un peu heureux, tout en développant mes compétences ?
Si l'on simplifie au maximumil n'y a en gros que deux façons d'améliorer radicalement la performance de la base de données :
1) Chemin extensif — augmenter les ressources, changer la configuration ;
2) Chemin intensif — optimiser les requêtes
Puisque, je le répète, à l'époque il n'était déjà pas clair ce qu'on pouvait encore changer dans la requête pour accélérer, le choix s'est porté sur la modification du design des tables.
Ainsi, la question principale se pose : qu'allons-nous changer et comment ?
Conditions initiales
Tout d'abord, nous avons un ERD comme ceci (montré de manière conditionnelle et simplifiée) :
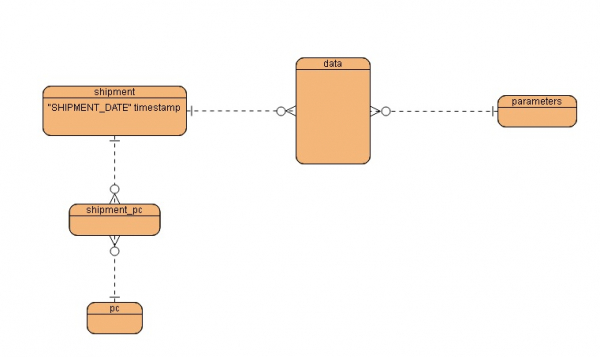
Caractéristiques principales :
- relations 'beaucoup à beaucoup'
- la table a déjà une clé potentielle de section
Requête d'origine :
SELECT
            p."PARAMETER_ID" as  parameter_id,
            pc."PC_NAME" AS pc_name,
            pc."CUSTOMER_PARTNUMBER" AS customer_partnumber,
            w."LASERMARK" AS lasermark,
            w."LOTID" AS lotid,
            w."REPORTED_VALUE" AS reported_value,
            w."LOWER_SPEC_LIMIT" AS lower_spec_limit,
            w."UPPER_SPEC_LIMIT" AS upper_spec_limit,
            p."TYPE_CALCUL" AS type_calcul,
            s."SHIPMENT_NAME" AS shipment_name,
            s."SHIPMENT_DATE" AS shipment_date,
            extract(year from s."SHIPMENT_DATE") AS year,
            extract(month from s."SHIPMENT_DATE") as month,
            s."REPORT_NAME" AS report_name,
            p."SPARAM_NAME" AS SPARAM_name,
            p."CUSTOMERPARAM_NAME" AS customerparam_name
        FROM data w INNER JOIN shipment s ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
             INNER JOIN parameters p ON p."PARAMETER_ID" = w."PARAMETER_ID"
             INNER JOIN shipment_pc sp ON s."SHIPMENT_ID" = sp."SHIPMENT_ID"
             INNER JOIN pc pc ON pc."PC_ID" = sp."PC_ID"
             INNER JOIN ( SELECT w2."LASERMARK" , MAX(s2."SHIPMENT_DATE") AS "SHIPMENT_DATE"
                          FROM shipment s2 INNER JOIN data w2 ON s2."SHIPMENT_ID" = w2."SHIPMENT_ID"
                          GROUP BY w2."LASERMARK"
                         ) md ON md."SHIPMENT_DATE" = s."SHIPMENT_DATE" AND md."LASERMARK" = w."LASERMARK"
        WHERE
             s."SHIPMENT_DATE" >= '2018-07-01' AND s."SHIPMENT_DATE" <= '2018-09-30' ;
Résultats d'exécution sur la base de données de test :
Coût : 502 997.55
Temps d'exécution: 505 secondes.
Que voyons-nous ? Une requête ordinaire, selon une tranche temporelle.
Faisons une hypothèse logique simple : si nous avons un échantillon d'une tranche de temps, cela nous aide-t-il ? Correct — le partitionnement.
Que faut-il partitionner ?
À première vue, le choix est évident — le partitionnement déclaratif de la table « shipment » par la clé « SHIPMENT_DATE » (en allant très loin — au final, cela ne s'est pas passé tout à fait comme prévu en production).
Comment partitionner ?
Cette question n'est pas trop complexe non plus. Heureusement, avec PostgreSQL 10, il y a maintenant un mécanisme humain de partitionnement.
Donc :
- Nous sauvegardons le dump de la table source — pg_dump source_table
- Nous supprimons la table source — drop table source_table
- Nous créons la table parent avec partitionnement par plage — create table source_table
- Nous créons des sections — create table source_table, create index
- Nous importons le dump créé à l'étape 1 — pg_restore
Scripts pour le partitionnement
Pour des raisons de simplicité et de commodité, les étapes 2, 3 et 4 ont été regroupées dans un seul script.
Donc :
Nous sauvegardons le dump de la table source
pg_dump postgres --file=\/dump\/shipment.dmp --format=c --table=shipment --verbose > \/dump\/shipment.log 2>&1Nous supprimons la table source + Nous créons la table parent avec partitionnement par plage + Nous créons des sections
--create_partition_shipment.sql
do language plpgsql $$
declare
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;
current_year varchar ;
current_month varchar ;
begin_year varchar ;
begin_month varchar ;
next_year varchar ;
next_month varchar ;
first_flag boolean ;
i integer ;
begin
  RAISE NOTICE 'CRÉER UNE TABLE TEMPORAIRE POUR SHIPMENT_DATE';
  CREATE TEMP TABLE tmp_shipment_date as select distinct "SHIPMENT_DATE" from shipment order by "SHIPMENT_DATE" ;

  RAISE NOTICE 'SUPPRIMER LA TABLE shipment';
  drop table shipment cascade ;

  CREATE TABLE public.shipment
  (
    "SHIPMENT_ID" integer NOT NULL DEFAULT nextval('shipment_shipment_id_seq'::regclass),
    "SHIPMENT_NAME" character varying(30) COLLATE pg_catalog."default",
    "SHIPMENT_DATE" timestamp without time zone,
    "REPORT_NAME" character varying(40) COLLATE pg_catalog."default"
  )
  PARTITION BY RANGE ("SHIPMENT_DATE")
  WITH (
      OIDS = FALSE
  )
  TABLESPACE pg_default;

  RAISE NOTICE 'CRÉER DES PARTITIONS POUR LA TABLE shipment';

  current_year:='0';
  current_month:='0';

  begin_year := '0' ;
  begin_month := '0'  ;
  next_year := '0' ;
  next_month := '0'  ;

  FOR rec_shipment_date IN SELECT * FROM tmp_shipment_date LOOP

      RAISE NOTICE 'SHIPMENT_DATE=%',rec_shipment_date."SHIPMENT_DATE";

      current_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE");
      current_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE") ;

      IF to_number(current_month,'99') = to_date( begin_year||'.'||begin_month, 'YYYY.MM') AND
         to_date( current_year||'.'||current_month, 'YYYY.MM') < to_date( next_year||'.'||next_month, 'YYYY.MM') AND
         NOT first_flag
      THEN
         CONTINUE ;
      ELSE
       --NEW borders only for second and after time
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;

      END IF;

      partition_name := 'shipment_shipment_date_'||begin_year||'-'||begin_month||'-01-'|| next_year||'-'||next_month||'-01'  ;

     EXECUTE format('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF shipment FOR VALUES FROM ( %L ) TO ( %L )  ' , current_year||'-'||current_month||'-01' , next_year||'-'||next_month||'-01'  ) ;

      index_name := partition_name||'_shipment_id_idx';
      RAISE NOTICE 'NOM D'INDEX =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      --Drop first time flag
      first_flag := false ;

  END LOOP;

end
$$;
Importer le dump
pg_restore -d postgres --data-only --format=c --table=shipment --verbose shipment.dmp > /tmp/data_dump/shipment_restore.log 2>&1Vérifions les résultats de la partition
Que pouvons-nous tirer de tout cela ? Le texte complet du plan d'exécution est long et ennuyeux, il est donc tout à fait possible de se limiter aux chiffres finaux.
Il y avait
Coût : 502 997.55
Temps d'exécution : 505 secondes.
Il est devenu
Coût : 77 872.36
Temps d'exécution : 79 secondes.
Un résultat tout à fait bon. Nous avons réduit le coût et le temps d'exécution. Ainsi, l'utilisation de la partitionnement donne l'effet attendu et, en général, sans surprises.
Rendre le client heureux
Les résultats des tests ont été présentés au client pour examen. Et après avoir pris connaissance, il a émis un verdict quelque peu inattendu : « Excellent, partitionnez la table «data» ».
Oui, mais nous avons étudié une table complètement différente, la table «shipment», la table «data» n'a pas de champ «SHIPMENT_DATE».
Pas de problème, ajoutez, modifiez. L'essentiel est que le client soit satisfait du résultat final, les détails de mise en œuvre ne sont pas si importants.
Nous partitionnons la table principale «data»
En fin de compte, il n'y a pas eu de difficultés particulières. Bien que, l'algorithme de partitionnement ait bien sûr légèrement changé.
Ajout d'une colonne «SHIPMENT_DATA» dans la table «data»
psql -h hôte -U base -d utilisateur
=> ALTER TABLE data ADD COLUMN "SHIPMENT_DATE" timestamp without time zone ;
Nous remplissons les valeurs de la colonne «SHIPMENT_DATA» dans la table «data» avec les valeurs de la colonne homonyme dans la table «shipment»
-----------------------------
--update_data.sql
--mise à jour pour la table "data" modifiée avec les valeurs de "shipment_data" de la table "shipment"
--version 1.0
do language plpgsql $$
declare
rec_shipment_data RECORD ;
shipment_date timestamp without time zone ;
row_count integer ;
total_rows integer ;
begin

  select count(*) into total_rows from shipment ;
  RAISE NOTICE 'Total %',total_rows;
  row_count:= 0 ;

  FOR rec_shipment_data IN SELECT * FROM shipment LOOP

   update data set "SHIPMENT_DATE" = rec_shipment_data."SHIPMENT_DATE" where "SHIPMENT_ID" = rec_shipment_data."SHIPMENT_ID";

   row_count:=  row_count +1 ;
   RAISE NOTICE 'row count = % , from %',row_count,total_rows;
  END LOOP;

end
$$;
Nous sauvegardons le dump de la table «data»
pg_dump postgres --file=\/dump\/data.dmp --format=c --table=data --verbose > \/dump\/data.log 2>&1<\/sourceNous recréons la table «data» partitionnée
--create_partition_data.sql
--créer des partitions pour la table "wafer data" par la colonne "shipment_data" avec une durée d'un mois
--version 1.0
do language plpgsql $$
declare
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;
current_year varchar ;
current_month varchar ;
begin_year varchar ;
begin_month varchar ;
next_year varchar ;
next_month varchar ;
first_flag boolean ;
i integer ;

begin

  RAISE NOTICE 'CRÉER UNE TABLE TEMPORAIRE POUR SHIPMENT_DATE';
  CREATE TEMP TABLE tmp_shipment_date as select distinct "SHIPMENT_DATE" from shipment order by "SHIPMENT_DATE" ;


  RAISE NOTICE 'SUPPRIMER LA TABLE data';
  drop table data cascade ;


  RAISE NOTICE 'CRÉER LA TABLE PARTITIONNÉE data';

  CREATE TABLE public.data
  (
    "RUN_ID" integer,
    "LASERMARK" character varying(20) COLLATE pg_catalog."default" NOT NULL,
    "LOTID" character varying(80) COLLATE pg_catalog."default",
    "SHIPMENT_ID" integer NOT NULL,
    "PARAMETER_ID" integer NOT NULL,
    "INTERNAL_VALUE" character varying(75) COLLATE pg_catalog."default",
    "REPORTED_VALUE" character varying(75) COLLATE pg_catalog."default",
    "LOWER_SPEC_LIMIT" numeric,
    "UPPER_SPEC_LIMIT" numeric ,
    "SHIPMENT_DATE" timestamp without time zone
  )
  PARTITION BY RANGE ("SHIPMENT_DATE")
  WITH (
    OIDS = FALSE
  )
  TABLESPACE pg_default ;


  RAISE NOTICE 'CRÉER DES PARTITIONS POUR LA TABLE data';

  current_year:='0';
  current_month:='0';

  begin_year := '0' ;
  begin_month := '0'  ;
  next_year := '0' ;
  next_month := '0'  ;
  i := 1;

  FOR rec_shipment_date IN SELECT * FROM tmp_shipment_date LOOP

      RAISE NOTICE 'SHIPMENT_DATE=%',rec_shipment_date."SHIPMENT_DATE";

      current_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE");
      current_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE") ;

      --Init borders
      IF   begin_year = '0' THEN
       RAISE NOTICE '***Init borders';
       first_flag := true ; --first time flag
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;

      END IF;

--      RAISE NOTICE 'current_year=% , current_month=% ',current_year,current_month;
--      RAISE NOTICE 'begin_year=% , begin_month=% ',begin_year,begin_month;
--      RAISE NOTICE 'next_year=% , next_month=% ',next_year,next_month;

      -- Vérifier si la date actuelle est dans les limites, PAS pour la première fois

      RAISE NOTICE 'Current data = %',to_char( to_date( current_year||'.'||current_month, 'YYYY.MM'), 'YYYY.MM');
      RAISE NOTICE 'Begin data = %',to_char( to_date( begin_year||'.'||begin_month, 'YYYY.MM'), 'YYYY.MM');
      RAISE NOTICE 'Next data = %',to_char( to_date( next_year||'.'||next_month, 'YYYY.MM'), 'YYYY.MM');

      IF to_date( current_year||'.'||current_month, 'YYYY.MM') >= to_date( begin_year||'.'||begin_month, 'YYYY.MM') AND
         to_date( current_year||'.'||current_month, 'YYYY.MM') < to_date( next_year||'.'||next_month, 'YYYY.MM') AND
         NOT first_flag
      THEN
         RAISE NOTICE '***CONTINUE';
         CONTINUE ;
      ELSE
       --Nouvelles limites uniquement pour la seconde fois et après
       RAISE NOTICE '***NOUVELLES LIMITES';
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;


      END IF;

      IF to_number(current_month,'99') < 10 THEN
        current_month := '0'||current_month ;
      END IF ;

      IF to_number(begin_month,'99') < 10 THEN
        begin_month := '0'||begin_month ;
      END IF ;

      IF to_number(next_month,'99') < 10 THEN
        next_month := '0'||next_month ;
      END IF ;

      RAISE NOTICE 'current_year=% , current_month=% ',current_year,current_month;
      RAISE NOTICE 'begin_year=% , begin_month=% ',begin_year,begin_month;
      RAISE NOTICE 'next_year=% , next_month=% ',next_year,next_month;

      partition_name := 'data_'||begin_year||begin_month||'01_'||next_year||next_month||'01'  ;

      RAISE NOTICE 'PARTITION NUMBER % , TABLE NAME =%',i , partition_name;

      EXECUTE format('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF data FOR VALUES FROM ( %L ) TO ( %L )  ' , begin_year||'-'||begin_month||'-01' , next_year||'-'||next_month||'-01'  ) ;

      index_name := partition_name||'_shipment_id_parameter_id_idx';
      RAISE NOTICE 'INDEX NAME =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID", "PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_lasermark_idx';
      RAISE NOTICE 'INDEX NAME =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("LASERMARK" COLLATE pg_catalog."default") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_id_idx';
      RAISE NOTICE 'INDEX NAME =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_parameter_id_idx';
      RAISE NOTICE 'INDEX NAME =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_date_idx';
      RAISE NOTICE 'INDEX NAME =%',index_name;
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_DATE") TABLESPACE pg_default ' ) ;

      --Supprimer le drapeau de première fois
      first_flag := false ;

  END LOOP;
end
$$;
Nous chargeons le dump créé à l'étape 3.
pg_restore -h hôte -user -d base --data-only --format=c --table=data --verbose data.dmp > data_restore.log 2>&1Créons une section distincte pour les anciennes données
---------------------------------------------------
--create_partition_for_old_dates.sql
--créer des partitions pour conserver les anciennes dates
--version 1.0
do language plpgsql $$
declare
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;

begin

      SELECT min("SHIPMENT_DATE") AS min_date INTO rec_shipment_date from data ;

      RAISE NOTICE 'Ancienne date est %',rec_shipment_date.min_date ;

      partition_name := 'data_old_dates'  ;

      RAISE NOTICE 'NOM DE LA PARTITION EST %',partition_name;

      EXECUTE format('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF data FOR VALUES FROM ( %L ) TO ( %L )  ' , '1900-01-01' ,
              to_char( rec_shipment_date.min_date,'YYYY')||'-'||to_char(rec_shipment_date.min_date,'MM')||'-01'  ) ;

      index_name := partition_name||'_shipment_id_parameter_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID", "PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_lasermark_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("LASERMARK" COLLATE pg_catalog."default") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_parameter_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_date_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_DATE") TABLESPACE pg_default ' ) ;

end
$$;
Résultats finaux :
Il y avait
Coût : 502 997.55
Temps d'exécution: 505 secondes.
Il est devenu
Coût : 68 533.70
Temps d'exécution : 69 secondes
C'est respectable, tout à fait respectable. Et étant donné que nous avons réussi à maîtriser plus ou moins le mécanisme de partitionnement dans PostgreSQL 10 en cours de route — c'est un excellent résultat.
Parenthèse lyrique
Peut-on faire encore mieux ? OUI, ON PEUT !Pour cela, il faut utiliser une VIEW MATÉRIALISÉE.
CREATE MATERIALIZED VIEW LASERMARK_VIEW
CREATE MATERIALIZED VIEW LASERMARK_VIEW
AS
SELECT w."LASERMARK" , MAX(s."SHIPMENT_DATE") AS "SHIPMENT_DATE"
FROM shipment s INNER JOIN data w ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
GROUP BY w."LASERMARK" ;

CREATE INDEX lasermark_vw_shipment_date_ind on lasermark_view USING btree ("SHIPMENT_DATE") TABLESPACE pg_default;
analyze lasermark_view ;
Une fois de plus, nous réécrivons la requête :
Requête avec utilisation de la vue matérialisée
SÉLECTIONNER
            p."PARAMETER_ID" comme parameter_id,
            pc."PC_NAME" comme pc_name,
            pc."CUSTOMER_PARTNUMBER" comme customer_partnumber,
            w."LASERMARK" comme lasermark,
            w."LOTID" comme lotid,
            w."REPORTED_VALUE" comme reported_value,
            w."LOWER_SPEC_LIMIT" comme lower_spec_limit,
            w."UPPER_SPEC_LIMIT" comme upper_spec_limit,
            p."TYPE_CALCUL" comme type_calcul,
            s."SHIPMENT_NAME" comme shipment_name,
            s."SHIPMENT_DATE" comme shipment_date,
            extraire(année de s."SHIPMENT_DATE") comme year,
            extraire(mois de s."SHIPMENT_DATE") comme month,
            s."REPORT_NAME" comme report_name,
            p."STC_NAME" comme STC_name,
            p."CUSTOMERPARAM_NAME" comme customerparam_name
        À PARTIR DE data w INNER JOIN shipment s ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
             INNER JOIN parameters p ON p."PARAMETER_ID" = w."PARAMETER_ID"
             INNER JOIN shipment_pc sp ON s."SHIPMENT_ID" = sp."SHIPMENT_ID"
             INNER JOIN pc pc ON pc."PC_ID" = sp."PC_ID"
             INNER JOIN LASERMARK_VIEW md ON md."SHIPMENT_DATE" = s."SHIPMENT_DATE" ET md."LASERMARK" = w."LASERMARK"
        OÙ
              s."SHIPMENT_DATE" >= '2018-07-01' ET s."SHIPMENT_DATE" <= '2018-09-30';
Et nous avons encore un résultat :
Il y avait
Coût : 502 997.55
Temps d'exécution: 505 secondes
Il est devenu
Coût : 42 481.16
Temps d'exécution : 43 secondes.
Bien sûr, un résultat aussi prometteur peut être trompeur, il faut rafraîchir les idées. Donc, le temps final pour obtenir les données n'aidera pas beaucoup. Mais c'est assez intéressant en tant qu'expérience.
En fait, comme il s'est avéré, encore merci et à Habr !-
Postface
Donc, le client est satisfait. Et doit profiter de la situation.
Nouvelle tâche: Que peut-on imaginer pour approfondir et élargir ?
Et ici je me souviens - les gars, nous n'avons pas de surveillance de nos bases de données PostgreSQL.
Pour être honnête, il y a en fait une certaine surveillance sous la forme de Cloud Watch sur AWS. Mais quelle est l'utilité de cette surveillance pour le DBA ? En gros, aucune.
Si l'occasion se présente de faire quelque chose d'utile et d'intéressant pour soi-même, on ne peut pas laisser passer une telle chance…
CAR
Et c'est ainsi que nous en sommes arrivés au plus intéressant :
3 Décembre 2018.
Prise de décision sur le début des travaux d'exploration des possibilités de surveillance des performances des requêtes PostgreSQL.
Mais c'est déjà une toute autre histoire.
À suivre...
Source : habr.com
