

Nous avons évolué DevOps comme nous le pouvions. Nous étions 8 personnes, et Vasya était le meilleur en Windows. Soudain, Vasya est parti, et j'avais la tâche de lancer un nouveau projet fournissant des développements Windows. Quand j'ai étalé toute la stack de développement Windows sur la table, j'ai réalisé que la situation était douloureuse...
C'est ainsi que commence l'histoire Alexandra Sinchinova sur . Lorsque le spécialiste principal des Windows a quitté l'entreprise, Alexandre s'est demandé quoi faire maintenant. Passer à Linux, bien sûr ! Alexandre expliquera comment il a réussi à créer un précédent et à transférer une partie du développement Windows sur Linux à travers un projet réalisé pour 100 000 utilisateurs finaux.
Comment déployer facilement et sans tracas un projet en RPM, en utilisant TFS, Puppet et Linux .NET core ? Comment gérer la version de la base de données du projet, si les développeurs entendent pour la première fois les mots Postgres et Flyway, et que la date limite est après-demain ? Comment intégrer avec Docker ? Comment motiver les développeurs .NET à renoncer à Windows et à leurs smoothies au profit de Puppet et de Linux ? Comment résoudre les conflits idéologiques, lorsque soutenir Windows en production devient insupportable ? À propos de cela, ainsi que de Web Deploy, des tests, de CI, des pratiques d'utilisation de TFS dans les projets existants, et bien sûr des béquilles cassées et des solutions fonctionnelles, dans la transcription de la présentation d'Alexandre.
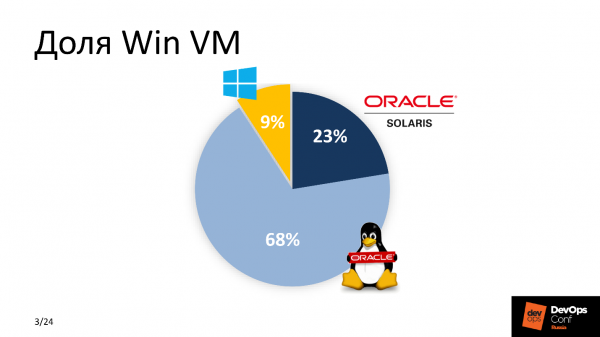
Donc, Vasya est parti, la tâche est maintenant sur moi, les développeurs attendent impatiemment avec des fourches. Quand j'ai finalement réalisé que je ne pouvais pas ramener Vasya, je me suis attelé à la tâche. D'abord, j'ai évalué le pourcentage de VM Windows dans notre parc. Le décompte n'était pas en faveur de Windows.
Comme nous développons activement DevOps, j'ai compris qu'il fallait changer notre approche pour le lancement d'une nouvelle application. La solution était claire : essayer de migrer tout vers Linux. Google m'a aidé – à ce moment-là, .Net avait déjà été porté sous Linux, et j'ai compris que c'était la solution !
Pourquoi .NET core associé à Linux ?
Il y avait plusieurs raisons à cela. Entre 'payer de l'argent' et 'ne pas payer', la plupart des gens choisiront la seconde option – tout comme moi. La licence pour MSDB coûte environ 1 000 $. L'entretien du parc de machines virtuelles Windows s'élève à des centaines de dollars. Pour une grande entreprise, c'est un coût significatif. Donc les économies — la première raison. Ce n'est pas la plus importante, mais c'est l'une des plus significatives.
Les machines virtuelles Windows consomment plus de ressources que leurs homologues Linux – elles sont lourdes. Étant donné l'échelle d'une grande entreprise, nous avons choisi Linux.
Le système s'intègre simplement dans le CI existant.. Nous nous considérons comme des DevOps progressistes, utilisant Bamboo, Jenkins et GitLab CI, donc la plupart de nos opérations se font sur Linux.
La dernière raison est un accompagnement pratique. Nous devions réduire la barrière d'entrée pour les 'accompagnateurs' – les personnes qui comprennent la partie technique, assurent la continuité et gèrent les services de deuxième ligne. Ils étaient déjà familiarisés avec l'écosystème Linux, il leur était donc beaucoup plus facile de comprendre, soutenir et accompagner le nouveau produit que de consacrer des ressources supplémentaires à découvrir des fonctionnalités similaires de logiciels pour la plateforme Windows.
Exigences
La première et principale est la commodité de la nouvelle solution pour les développeurs. Tous ne se sont pas montrés prêts au changement, surtout après avoir entendu le mot Linux. Les développeurs veulent leur Visual Studio préféré, TFS avec des tests automatisés sur les builds et des smoothies. Peu importe comment cela arrive en production pour eux. C'est pourquoi nous avons décidé de ne pas changer le processus habituel et de laisser tout inchangé pour le développement Windows.
Le nouveau projet doit s'intégrer dans le CI existant.. Les rails étaient déjà en place et tout le travail devait être effectué en tenant compte des paramètres du système de gestion de configuration, des standards de livraison acceptés et des systèmes de monitoring.
La simplicité de maintenance et d'exploitation, comme condition pour un faible seuil d'entrée pour tous les nouveaux participants des différents départements et du service de support.
La date limite était hier..
L'équipe de développement Win.
Avec quoi travaillait alors l'équipe Windows ?
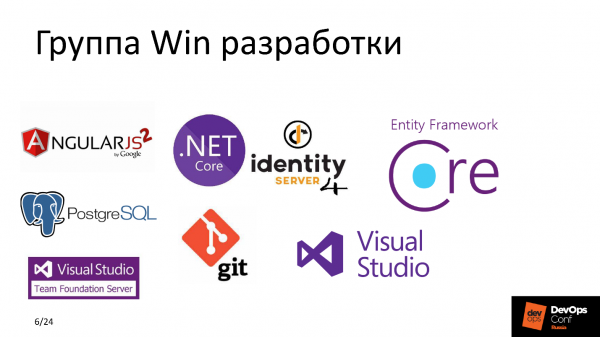
Maintenant, je peux dire avec confiance que IdentityServer4 c'est une excellente alternative gratuite à ADFS avec des capacités similaires, ou que Entity Framework Core est un paradis pour les développeurs, où il n'est pas nécessaire de se soucier d'écrire des scripts SQL, mais de décrire les requêtes dans la base de données en termes de POO. Mais à cette époque, lors de la discussion du plan d'action, je considérais cette pile comme une écriture cunéiforme sumérienne, ne reconnaissant que PostgreSQL et Git.
À ce moment-là, nous utilisions activement Puppet comme système de gestion de configuration. Dans la plupart de nos projets, nous appliquions GitLab CI, Elastic, nous équilibrions des services à forte charge à l'aide de HAProxy, nous surveillions tout grâce à Zabbix, lié à Grafana et Prometheus, Jaeger, et tout cela tournait sur du matériel HP c ESXi. sur VMwareTout le monde connaît – la classe du genre.
Examinons et essayons de comprendre ce qui s'est passé avant que nous ne commencions toutes ces interventions.
Ce qui s'est passé
TFS est un système assez puissant qui non seulement livre le code du développeur au serveur de production final, mais qui dispose également d'un ensemble pour une intégration très flexible avec divers services pour assurer l'intégration continue au niveau multiplateforme.
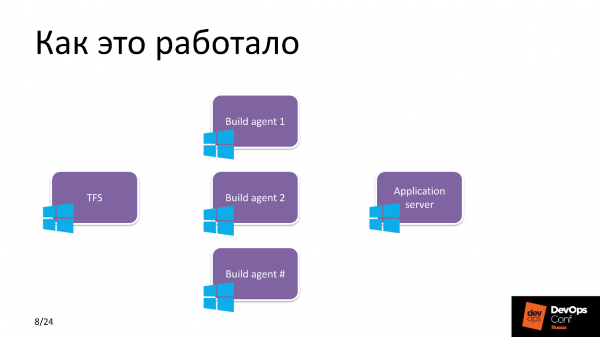
Auparavant, il y avait de nombreuses fenêtres. TFS utilisait plusieurs agents de build, sur lesquels de nombreux projets étaient construits. Chaque agent avait 3-4 travailleurs pour paralléliser les tâches et optimiser le processus. Ensuite, selon les plans de publication, TFS livrait le Build fraîchement cuit sur un serveur Windows.
Vers quoi nous visions
Pour la livraison et le développement, nous utilisons TFS, et nous exécutons l'application sur un serveur d'applications Linux, avec un peu de magie entre les deux. Cette boîte magique est l'essence du travail à venir. Avant de la décomposer, je vais faire une pause et dire quelques mots sur l'application.
Projet
L'application fournit des fonctionnalités pour gérer des cartes prépayées.
Client
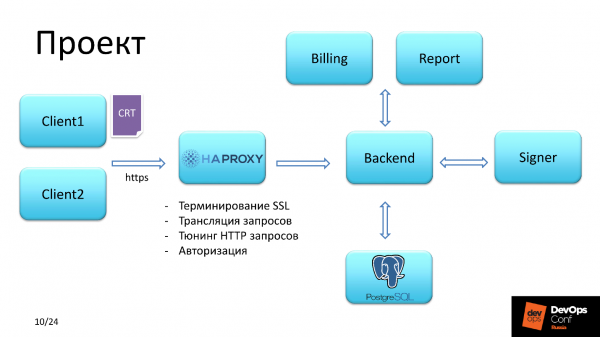
Il y avait deux types d'utilisateurs. Premier acquérait l'accès en s'authentifiant avec un certificat SSL SHA-2. Le deuxième avait accès par identifiant et mot de passe.
HAProxy
Ensuite, la demande client passait par HAProxy, qui résolvait les tâches suivantes :
- première autorisation;
- terminaison SSL;
- optimisation des requêtes HTTP;
- transmission des requêtes.
La vérification du certificat client se faisait en chaîne. Nous sommes autorité et nous pouvons nous permettre cela car nous délivrons nous-mêmes des certificats aux clients du service.
Faites attention au troisième point, nous y reviendrons un peu plus tard.
Backend
Nous prévoyions de faire le backend sur Linux. Le backend interagit avec la base de données, charge la liste nécessaire des privilèges et ensuite, en fonction des privilèges du utilisateur authentifié, donne accès à la signature de documents financiers et à leur envoi pour exécution, ou à la génération de tout rapport.
Économie avec HAProxy
En plus des deux contextes par lesquels chaque client passait, il y avait également un contexte d'identité. IdentityServer4 qui permet justement de s'authentifier, c'est un analogue gratuit et puissant de ADFS — Services d'Application de Fédération Active Directory.
La requête dans l'identité était traitée en plusieurs étapes. La première étape client était envoyée au backend, qui échangeait des données avec ce serveur et vérifiait la présence d'un jeton pour le client. S'il n'en trouvait pas, la requête était renvoyée au contexte d'origine, mais avec une redirection, et la redirection se faisait vers identity.
La deuxième étape consistait à ce que la requête atteigne la page d'authentification dans IdentityServer, où le client s'enregistrait, et dans la base de données d'IdentityServer apparaissait ce fameux jeton tant attendu.
La troisième étape – le client était redirigé vers le contexte d'origine.
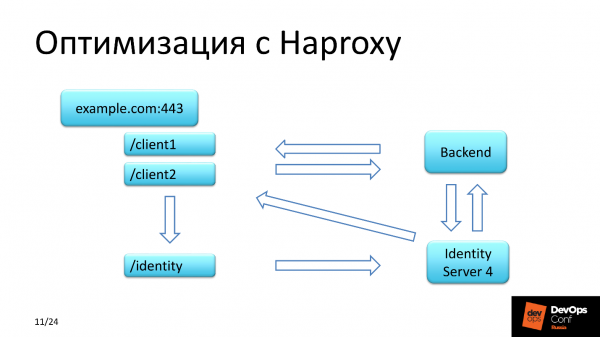
IdentityServer4 a une particularité : la réponse à la requête inverse est renvoyée par HTTP. Peu importe combien nous avons bataillé avec la configuration du serveur, peu importe combien nous nous sommes éclairés grâce à la documentation, nous recevions à chaque fois la requête initiale du client avec une URL venant par HTTPS, tandis qu'IdentityServer renvoyait le même contexte, mais avec HTTP. Nous étions choqués ! Nous avons donc transféré tout cela à travers le contexte identity sur HAProxy, et avons dû modifier le protocole HTTP en HTTPS dans les en-têtes.
Quelle amélioration et où avons-nous économisé ?
Nous avons économisé de l'argent en utilisant une solution gratuite pour l'authentification d'un groupe d'utilisateurs, des ressources, car nous n'avons pas extrané IdentityServer4 en tant que nœud distinct dans un segment séparé, mais l'avons utilisé conjointement avec le backend sur le même serveur que celui où le backend de l'application fonctionne.
Comment cela devrait fonctionner
Alors, comme je l'ai promis – Magic Box. Nous comprenons déjà que nous nous dirigeons assurément vers Linux. Formulons les tâches spécifiques qui nécessitaient une solution.
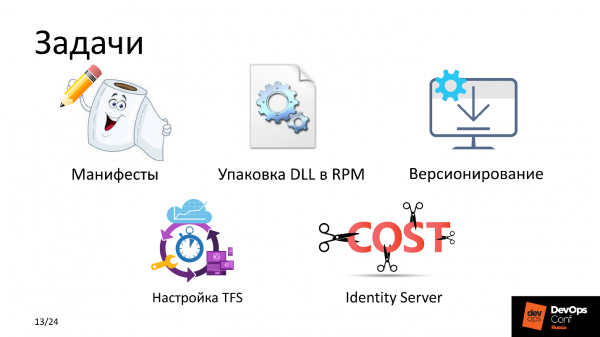
Les manifestes Puppet. Pour livrer et gérer la configuration du service et de l'application, il fallait écrire de superbes recettes. Le petit rouleau avec un crayon montre clairement à quelle vitesse et qualité cela a été effectué.
Mode de livraison. La norme est RPM. Tout le monde sait qu'en Linux, c'est indispensable, mais le projet lui-même, une fois construit, se composait d'un ensemble de fichiers DLL exécutables. Il y en avait environ 150, le projet étant assez lourd. La seule solution harmonieuse était d'emballer ce binaire dans un RPM et de déployer l'application à partir de celui-ci.
Versioning. Nous devions déployer très souvent et il fallait décider comment former le nom du paquet. C'est une question d'intégration avec TFS. L'agent de build que nous avions était sous Linux. Lorsque TFS envoie une tâche au worker sur l'agent de build, il lui transmet également un ensemble de variables qui sont intégrées dans l'environnement du processus du worker. Ces variables d'environnement incluent le nom du Build, le nom de la version et d'autres variables. Plus de détails à ce sujet dans la section « construction du paquet RPM ».
Configuration de TFS se limitait à la configuration du Pipeline. Auparavant, nous construisions tous les projets Windows sur des agents Windows, mais maintenant un agent Linux - l'agent de build - doit être intégré dans le groupe de construction, enrichi avec certains artefacts, et il faut spécifier quels types de projets seront construits sur cet agent de build et comment modifier le Pipeline.
IdentityServer. ADFS n'est pas notre voie, nous optons pour l'Open Source.
Passons en revue les composants.
boîte magique
Il se compose de quatre parties.
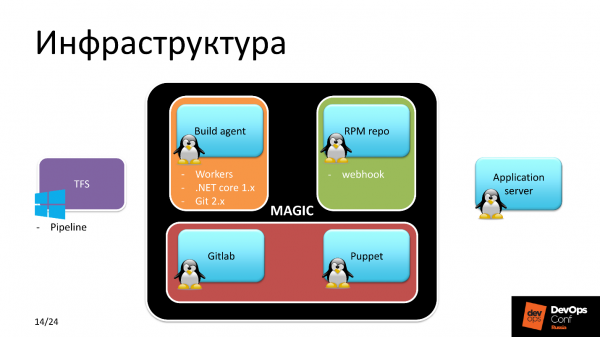
Agent de build Linux. Linux, car nous développons pour lui - c'est logique. Cette partie s'est déroulée en trois étapes.
- Configurer les workers et pas un seul, car un travail distribué était prévu sur le projet.
- Installer .NET Core 1.x. Pourquoi 1.x, alors que 2.0 est déjà disponible dans le dépôt standard ? Parce que, lorsque nous avons commencé le développement, la version stable était 1.09, et le projet a été décidé de le faire pour cette version.
- Git 2.x.
Dépôt RPM. Les paquets RPM devaient être stockés quelque part. Il était prévu que nous utiliserions le même dépôt RPM d'entreprise qui est accessible à tous les hôtes Linux. C'est ce que nous avons fait. Sur le serveur du dépôt, un webhook a été configuré pour télécharger le paquet RPM requis à partir de l'emplacement spécifié. La version du paquet était communiquée au webhook par l'agent de build.
GitLab. Attention ! GitLab ici n'est pas utilisé par les développeurs, mais par le service d'exploitation pour le contrôle de version des applications, des versions de paquets, le suivi de l'état de toutes les machines Linux et il contient la recette - tous les manifestes Puppet.
Puppet – résout tous les problèmes discutables et fournit exactement la configuration que nous voulons, depuis GitLab.
Nous commençons à plonger. Comment se fait la livraison de DLL dans RPM ?
Livraison DDL dans RPM
Supposons que nous avons une rock star du développement sous .NET. Il utilise Visual Studio et crée une branche de release. Après cela, il la télécharge sur Git, et Git ici est une entité TFS, c'est-à-dire que c'est le dépôt de l'application avec lequel le développeur travaille.
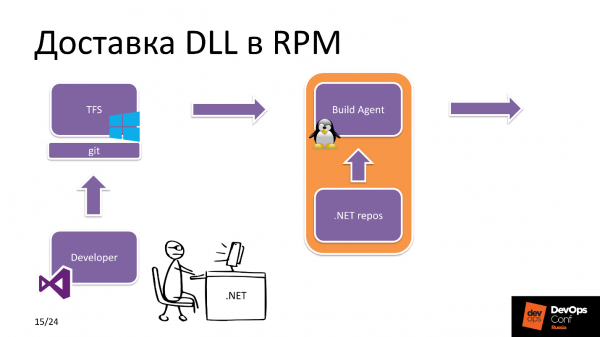
Après quoi TFS constate qu'un nouveau commit a été reçu. Quelle application ? Dans les paramètres de TFS, il existe une étiquette indiquant quelles ressources possède chaque agent de Build. Dans ce cas, il voit que nous construisons un projet .NET Core et sélectionne un agent de Build Linux dans le pool.
L'agent de Build obtient les sources, télécharge les nécessaires dépendances du dépôt .NET, npm, etc. et après la construction de l'application elle-même et l'emballage ultérieur, envoie le paquet RPM dans le dépôt RPM.
D'un autre côté, cela se passe ainsi. L'ingénieur du département d'exploitation s'occupe de la mise en production du projet : il modifie les versions des paquets dans Hiera dans le dépôt où est stockée la recette de l'application, après quoi Puppet déclenche Yum, prend le nouveau paquet du dépôt, et la nouvelle version de l'application est prête à être utilisée.
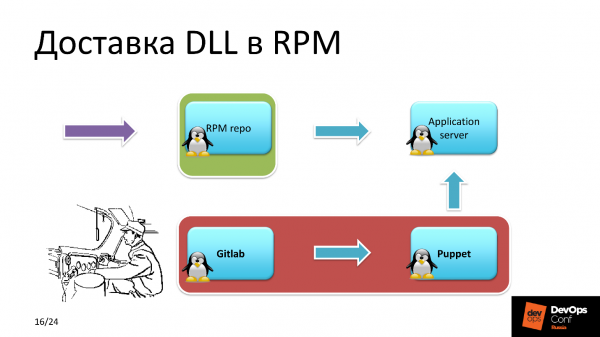
En théorie, tout est simple, mais que se passe-t-il à l'intérieur de l'agent de Build ?
Emballage DLL RPM
Les sources du projet ont été reçues et la tâche de construction de TFS. L'agent de Build démarre la construction du projet à partir des sources.Le projet construit est disponible sous la forme de plusieurs fichiers DLL, qui sont emballés dans une archive zip pour réduire la charge sur le système de fichiers.
L'archive ZIP est placée dans le répertoire de construction du paquet RPM. Ensuite, un script Bash initialise les variables d'environnement, trouve la version du Build, la version du projet, le chemin vers le répertoire de construction, et lance RPM-build. À la fin de la construction, le paquet est publié dans le dépôt local, qui se trouve sur l'agent de Build.
Ensuite, de l'agent de Build au serveur dans le dépôt RPM un JSON est envoyé indiquant le nom de la version et du Build. Le webhook, dont j'ai parlé précédemment, récupère ce paquet dans le dépôt local sur l'agent de Build et rend une nouvelle construction disponible pour installation.
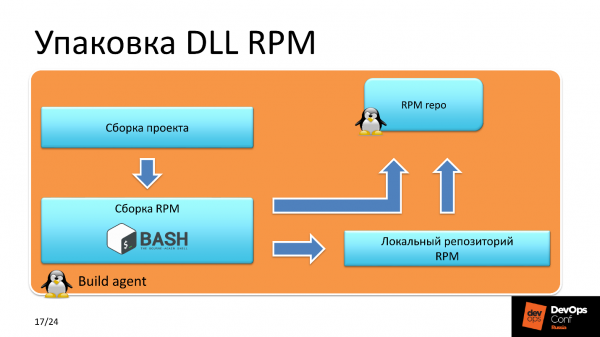
Pourquoi ce schéma de livraison du paquet dans le dépôt RPM ? Pourquoi ne pas envoyer directement le paquet construit au dépôt ? Cela est dû au fait que cette condition garantit la sécurité. Un tel scénario limite la possibilité de chargement non autorisé de paquets RPM par des personnes extérieures sur le serveur, qui est accessible à toutes les machines Linux.
Versionnage de la BDD
Lors d'un conseil avec le développement, il est apparu que les gars préféraient MS SQL, mais dans la plupart des projets non-Windows, nous utilisions déjà PostgreSQL. Comme nous avions décidé de nous passer de tout ce qui était payant, nous avons commencé à utiliser PostgreSQL ici aussi.
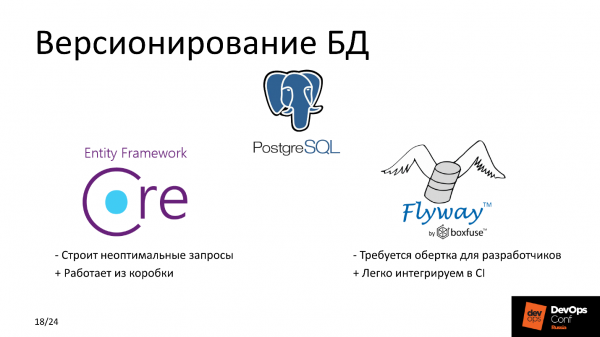
Dans cette partie, je vais expliquer comment nous avons géré la versionnage de la base de données et comment nous avons choisi entre Flyway et Entity Framework Core. Examinons leurs avantages et inconvénients.
Inconvénients
Flyway n'opère que dans un sens, nous ne pouvons pas revenir en arrière — c'est un inconvénient majeur. La comparaison avec Entity Framework Core peut se faire sur d'autres critères — en termes de commodité pour le développeur. Vous vous rappelez que nous avons mis cela en avant, et le critère principal était de ne rien changer pour le développement sous Windows.
Pour Flyway, nous avions besoin d'une sorte d'enveloppe, afin que les développeurs n'écrivent pas des requêtes SQL. Il leur est beaucoup plus facile de travailler en termes de POO. Nous avons rédigé des instructions pour travailler avec les objets de la base de données, une requête SQL a été formée et exécutée. La nouvelle version de la base de données est prête, ça a fonctionné — tout va bien, tout fonctionne.
Entity Framework Core a un inconvénient — sous de fortes charges, il génère des requêtes SQL non optimales, et la diminution de la base de données peut être significative. Mais comme nous n'avons pas un service à forte charge, nous ne mesurons pas la charge en centaines de RPS, nous avons pris ces risques et avons délégué le problème à notre futur nous.
Avantages
Entity Framework Core fonctionne dès la sortie de la boîte et est pratique pour le développement, tandis que Flyway s'intègre facilement dans le CI existant. Mais nous voulons rendre les choses simples pour les développeurs :)
La procédure de déploiement
Puppet vérifie les modifications de version des paquets, y compris celui qui est responsable de la migration. Il commence par installer le paquet contenant les scripts de migration et les fonctions liées à la base de données. Ensuite, l'application qui interagit avec la base de données redémarre. Ensuite, les composants restants sont installés. L'ordre d'installation des paquets et de lancement des applications est décrit dans le manifeste Puppet.
Les applications utilisent des données sensibles, telles que des tokens, des mots de passe de base de données, tout cela est récupéré dans la configuration depuis Puppet master, où elles sont stockées sous forme chiffrée.
Problèmes TFS
Après avoir confirmé que tout fonctionne réellement, j'ai décidé de vérifier les constructions dans TFS pour l'ensemble du département de développement Windows sur d'autres projets — pour voir si nous construisons/relançons rapidement ou non, et j'ai découvert des problèmes majeurs de vitesse.
Un des projets principaux se construit en 12-15 minutes — c'est long, il est impossible de fonctionner ainsi. Une analyse rapide a montré un ralentissement terrible au niveau des E/S, et cela sur des tableaux.
Après une analyse par composant, j'ai identifié trois foyers. Le premier — «Kaspersky antivirus», qui scanne les sources sur tous les agents de build Windows. Deuxième — Windows Indexeur. Il n'a pas été désactivé, et tout était indexé en temps réel sur les agents de build durant le processus de déploiement.
Troisième — Npm install. Il s'est avéré que dans la plupart des Pipelines, nous utilisions ce script. Quel est son problème ? La procédure Npm install s'exécute lors de la construction de l'arbre des dépendances dans package-lock.json, où les versions des paquets qui seront utilisées pour construire le projet sont enregistrées. Le problème, c'est que Npm install tire à chaque fois les versions les plus récentes des paquets depuis internet, ce qui prend beaucoup de temps dans le cas d'un grand projet.
Les développeurs expérimentent parfois sur leur machine locale pour vérifier le bon fonctionnement d'une partie ou du projet dans son ensemble. Parfois, il arrivait que tout fonctionne bien localement, mais en construisant et déployant — rien ne marchait. Nous commençons à enquêter sur le problème — ah, différentes versions des paquets avec dépendances.
Solution
- Sources dans les exceptions AV.
- Désactivation de l'indexation.
- Passage à npm ci.
L'avantage de npm ci, c'est que nous construisons l'arbre des dépendances une seule fois, et avons la possibilité de fournir au développeur une liste à jour des paquets, avec laquelle il peut expérimenter localement autant qu'il veut. Cela économise du temps des développeurs qui écrivent le code.
Configuration
À présent, un peu sur la configuration du dépôt. Historiquement, nous utilisons Nexus pour la gestion des dépôts, y compris REPO Interne. Ce dépôt interne reçoit tous les composants que nous utilisons pour des besoins internes, comme nos propres outils de monitoring.
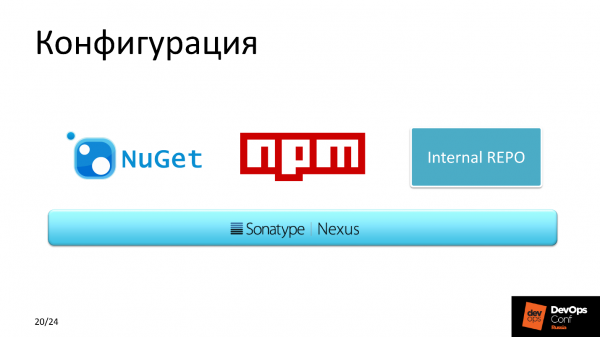
Nous utilisons également NuGet, car il met en cache mieux par rapport aux autres gestionnaires de paquets.
Résultat
Après avoir optimisé les agents de build, le temps moyen de construction a été réduit de 12 minutes à 7.
Si l'on compte toutes les machines que nous aurions pu utiliser pour Windows, mais que nous avons transférées sur Linux dans ce projet, nous avons économisé environ 10 000 $. Et cela ne concerne que les licences, sans compter les coûts d'exploitation — c'est plus.
Plans
Pour le prochain trimestre, nous avons planifié de travailler sur l'optimisation de la livraison du code.
Passage à une image Docker pré-construite. TFS est un excellent outil avec de nombreux plugins qui permettent d'intégrer dans le Pipeline, y compris la construction sur un déclencheur, comme par exemple, l'image Docker. Nous voulons mettre en place ce déclencheur sur celui-ci. package-lock.json. Si la composition des composants utilisés pour assembler le projet change d'une manière ou d'une autre, nous construisons une nouvelle image Docker. Celle-ci est ensuite utilisée pour déployer un conteneur avec l'application construite. Actuellement, cela n'existe pas, mais nous prévoyons de nous orienter vers une architecture microservices dans Kubernetes, qui se développe activement dans notre entreprise et gère depuis longtemps des solutions en production.
Résumé
J’invite tout le monde à abandonner Windows, mais ce n’est pas parce que je ne sais pas le préparer. La raison est que la majeure partie des solutions open source est une pile Linux. Vous économiserez bien sur les ressources. À mon avis, l'avenir appartient aux solutions open source sur Linux avec une communauté solide.
Profil du conférencier Alexandre Sinchinov .
est une conférence sur l'intégration des processus de développement, de test et d'exploitation pour les professionnels par des professionnels. C'est pourquoi le projet dont Alexandre a parlé est réalisé et fonctionne, et deux mises à jour réussies ont été effectuées le jour de la présentation. Les 27 et 28 mai, il y aura encore plus de cas similaires de praticiens. Vous pouvez encore monter dans le dernier train et ou tranquillement votre billet. Nous nous retrouverons à Skolkovo !
Source : habr.com
