

Je m'appelle Anton Baderin. Je travaille au Centre des Hautes Technologies et je m'occupe de l'administration système. Il y a un mois, notre conférence d'entreprise s'est tenue, où nous avons partagé notre expérience avec la communauté IT de notre ville. J'ai parlé de la surveillance des applications web. Le matériel était destiné aux niveaux junior ou intermédiaire, qui ne construisaient pas ce processus à partir de zéro.
La pierre angulaire de tout système de surveillance est la résolution des problèmes d'entreprise. La surveillance pour la surveillance n'intéresse personne. Que veut l'entreprise ? Que tout fonctionne rapidement et sans erreurs. L'entreprise veut de la proactivité, que nous identifions nous-mêmes les problèmes dans le fonctionnement du service et que nous les corrigions le plus rapidement possible. C'est, en substance, ce que j'ai résolu tout au long de l'année dernière sur le projet d'un de nos clients.
À propos du projet
Le projet est l'un des plus grands programmes de fidélité du pays. Nous aidons les réseaux de distribution à augmenter la fréquence des ventes grâce à divers outils marketing tels que les cartes de fidélité. Au total, le projet comprend 14 applications qui fonctionnent sur dix serveurs.
Au cours de mes entretiens, j'ai souvent remarqué que les administrateurs n'approchent pas toujours correctement la surveillance des applications web : beaucoup se limitent encore aux métriques du système d'exploitation et surveillent occasionnellement les services.
Dans mon cas, la base du système de surveillance du client était auparavant Icinga. Cela ne répondait en rien aux problèmes mentionnés ci-dessus. Souvent, le client nous informait lui-même des problèmes et nous manquions de données pour comprendre la cause.
De plus, il était clairement compris que son développement futur était sans perspective. Je pense que ceux qui connaissent Icinga me comprendront. Ainsi, nous avons décidé de retravailler complètement le système de surveillance des applications web sur le projet.
Prometheus
Nous avons choisi Prometheus, en nous basant sur trois indicateurs principaux :
- Un grand nombre de métriques disponibles. Dans notre cas, il y en a 60 000. Bien sûr, il convient de noter que la grande majorité d'entre elles ne sont pas utilisées (probablement environ 95 %). D'un autre côté, elles sont toutes relativement bon marché. Pour nous, c'est une autre extrémité, par rapport à Icinga que nous utilisions auparavant. Dans ce dernier, ajouter des métriques était particulièrement pénible : celles existantes coûtaient cher (il suffit de regarder le code source de n'importe quel plugin). Chaque plugin était un script Bash ou Python, dont l'exécution n'est pas bon marché en termes de ressources consommées.
- Ce système consomme relativement peu de ressources. Pour toutes nos métriques, il nous faut 600 Mo de mémoire vive, 15 % d'un cœur et quelques dizaines d'IOPS. Bien sûr, il faut exécuter des exportateurs de métriques, mais ils sont tous écrits en Go et ne sont pas non plus gourmands en ressources. Je ne pense pas que cela soit un problème dans les réalités modernes.
- Permet le passage à Kubernetes. Compte tenu des plans du client, le choix est évident.
ELK
Auparavant, nous ne collections ni ne traitions les logs. Les inconvénients sont clairs pour tout le monde. Nous avons choisi ELK, car nous avions déjà de l'expérience avec ce système. Nous n'y stockons que les logs des applications. Les principaux critères de choix étaient la recherche en texte intégral et sa rapidité.
Clickhouse
Au départ, nous avons opté pour InfluxDB. Nous étions conscients de la nécessité de collecter les logs Nginx, les statistiques de pg_stat_statements et de conserver les données historiques de Prometheus. Influx ne nous a pas convenu, car il commençait périodiquement à consommer une grande quantité de mémoire et à tomber en panne. De plus, nous voulions grouper les requêtes par remote_addr, mais le groupement dans cette SGBD n'est possible que par tags. Les tags coûtent cher (en mémoire), et leur nombre est conditionnellement limité.
Nous avons recommencé nos recherches. Nous avions besoin d'une base analytique avec une consommation minimale de ressources, de préférence avec compression des données sur disque.
Clickhouse répond à tous ces critères, et nous n'avons jamais regretté notre choix. Nous ne lui écrivons pas des volumes de données exceptionnels (le nombre d'inserts est d'environ cinq mille par minute).
NewRelic
NewRelic a historiquement été avec nous, car c'était le choix du client. Nous l'utilisons comme APM.
Zabbix
Nous utilisons Zabbix uniquement pour surveiller Black Box de diverses API.
Définition de l'approche de monitoring
Nous souhaitions décomposer la tâche et ainsi systématiser l'approche du monitoring.
Pour cela, j'ai divisé notre système en plusieurs niveaux :
- «matériel» et VMS;
- système d'exploitation;
- services système, pile logiciel;
- application;
- logique métier.
Voici les avantages de cette approche :
- Nous savons qui est responsable de chaque niveau de fonctionnement et, à partir de cela, nous pouvons envoyer des alertes ;
- Nous pouvons également utiliser cette structure pour supprimer les alertes — il serait étrange d'envoyer une alerte concernant l'indisponibilité de la base de données alors que la machine virtuelle dans son ensemble n'est pas accessible.
Puisque notre tâche est d'identifier les violations dans le fonctionnement du système, nous devons définir, à chaque niveau, un ensemble de métriques sur lesquelles prêter attention lors de l'écriture des règles d'alerte. Nous allons maintenant passer aux niveaux «VMS», «Système d'exploitation» et «Services système, pile logiciel».
Machines virtuelles
Hébergement il nous attribue un processeur, un disque, de la mémoire et un réseau. Nous avons eu des problèmes avec les deux premiers. Donc, les métriques :
Temps CPU volé — lorsque vous achetez une machine virtuelle sur Amazon (t2.micro, par exemple), il est important de comprendre que vous ne vous voyez pas attribuer un noyau entier, mais simplement une quota de son temps. Et lorsque ce quota est épuisé, le processeur commencera à être retiré.
Cette métrique permet de suivre ces moments et de prendre des décisions. Par exemple, faut-il opter pour un tarif supérieur ou répartir le traitement des tâches d'arrière-plan et les demandes d'API sur différents de serveurs.
IOPS + temps d'attente CPU iowait — pour une raison quelconque, de nombreux hébergeurs cloud ont tendance à fournir moins d'IOPS. De plus, un graphique présentant de faibles IOPS ne leur sert pas d'argument. Il vaut donc la peine de recueillir les données sur le CPU iowait. Avec cette paire de graphiques — faibles IOPS et forte attente d'entrée-sortie — on peut déjà discuter avec l'hébergeur et résoudre le problème.
Système d'exploitation
Métriques du système d'exploitation :
- pourcentage de mémoire disponible ;
- activité d'utilisation du swap : vmstat swapin, swapout ;
- nombre d'inodes disponibles et d'espace libre sur le système de fichiers en % ;
- charge moyenne ;
- nombre de connexions en état de tw ;
- taux de remplissage de la table conntrack ;
- La qualité du réseau peut être surveillée à l'aide de l'utilitaire ss, du paquet iproute2 — obtenir à partir de sa sortie le taux RTT des connexions et regrouper par port de destination.
De plus, au niveau de l'utilisateur, nous avons une entité appelée processus. Il est essentiel de définir un ensemble de processus dans le système qui jouent un rôle clé dans son fonctionnement. Si, par exemple, vous avez plusieurs pgpool, il est nécessaire de collecter des informations sur chacun d'eux.
L'ensemble des métriques est le suivant :
- CPU ;
- La mémoire est avant tout résidente ;
- IO — de préférence en IOPS ;
- FileFd — ouverts et limites ;
- Les pannes de pages significatives — cela vous permettra de comprendre quel processus est en train de swapper.
Tout notre monitoring est déployé dans Docker, nous utilisons Cadvisor pour collecter des données de métriques. Sur les autres machines, nous utilisons process-exporter.
Services système, pile logicielle
Chaque application a sa propre spécificité, et il est difficile de выделить un ensemble de métriques.
L'ensemble universel est :
- taux de requêtes ;
- nombre d'erreurs ;
- latence ;
- saturation.
Les exemples les plus marquants de ce niveau de monitoring chez nous sont Nginx et PostgreSQL.
Le service le plus sollicité de notre système est la base de données. Auparavant, nous avions souvent des problèmes pour déterminer ce que faisait la base de données.
Nous avons observé une forte charge sur les disques, mais les slow logs ne montraient rien de significatif. Nous avons résolu ce problème avec pg_stat_statements, une vue qui collecte des statistiques sur les requêtes.
C'est tout ce dont a besoin un administrateur.
Nous construisons des graphiques d'activité des requêtes en lecture et en écriture :
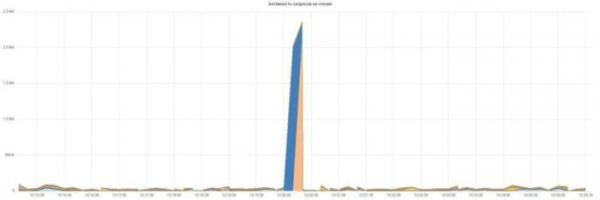
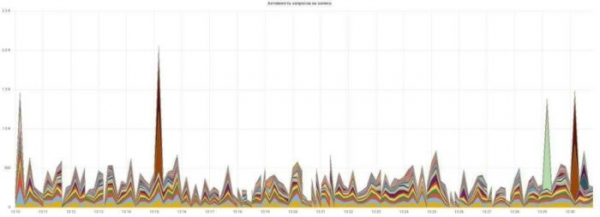
C'est simple et clair, chaque requête a sa propre couleur.
Un autre exemple marquant est les logs Nginx. Il n'est pas surprenant que peu de gens les analysent ou les mentionnent dans la liste des incontournables. Le format standard n'est pas très informatif et doit être étendu.
Personnellement, j'ai ajouté request_time, upstream_response_time, body_bytes_sent, request_length, request_id. Nous construisons des graphiques sur le temps de réponse et le nombre d'erreurs :
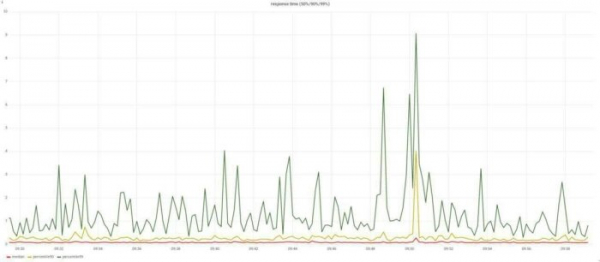
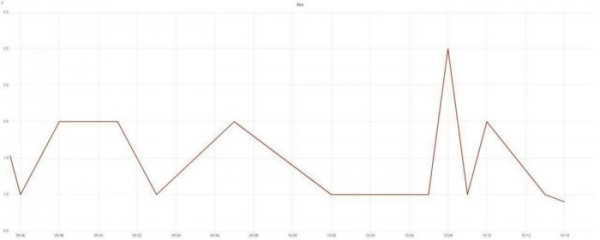
Nous construisons des graphiques sur le temps de réponse et le nombre d'erreurs. Vous vous souvenez ? J'ai parlé des objectifs commerciaux ? Pour être rapide et sans erreurs ? Nous avons déjà couvert ces questions avec deux graphiques. Et à partir de cela, nous pouvons déjà contacter les administrateurs de garde.
Mais il reste un problème — assurer une résolution rapide des causes de l'incident.
Résolution des incidents
Tout le processus de détection à la résolution du problème peut être divisé en plusieurs étapes :
- détection du problème ;
- notification de l'administrateur de garde ;
- réaction à l'incident ;
- résolution des causes.
Il est important que nous fassions cela le plus rapidement possible. Et si lors des étapes de détection du problème et d'envoi de notification, nous ne pouvons pas gagner beaucoup de temps — deux minutes sont nécessaires de toute façon, les étapes suivantes sont simplement un champ inexploré pour des améliorations.
Imaginons simplement que le téléphone de l'opérateur sonne. Que va-t-il faire ? Chercher des réponses aux questions : qu'est-ce qui s'est cassé, où cela s'est-il produit, comment réagir ? Voici comment nous répondons à ces questions :
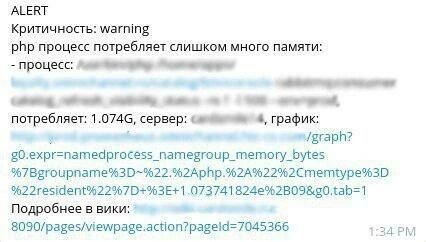
Nous intégrons simplement toutes ces informations dans le texte de l'avis, en y ajoutant un lien vers la page wiki qui décrit comment répondre à ce problème, comment le résoudre et l'escalader.
Je n'ai toujours rien dit concernant le niveau d'application et la logique métier. Malheureusement, nos applications ne collectent pas encore de métriques. La seule source d'informations à ces niveaux est les logs.
Quelques points.
Tout d'abord, écrivez des logs structurés. Ne mettez pas de contexte dans le texte du message. Cela complique leur regroupement et leur analyse. Logstash nécessite beaucoup de temps pour normaliser tout cela.
Deuxièmement, utilisez correctement les niveaux de gravité. Chaque langage a sa propre norme. Personnellement, je distingue quatre niveaux :
- pas d'erreur;
- erreur côté client;
- erreur de notre côté, nous ne perdons pas d'argent, nous ne prenons pas de risques;
- erreur de notre côté, nous perdons de l'argent.
En résumé. Nous devons essayer de construire le monitoring précisément à partir de la logique métier. Essayer de monitorer l'application elle-même et d'opérer avec des métriques telles que le nombre de ventes, le nombre de nouvelles inscriptions utilisateurs, le nombre d'utilisateurs actifs à ce moment-là, etc.
Si votre entreprise entière n'est qu'un bouton dans le navigateur, il est nécessaire de surveiller si ce bouton est pressé, s'il fonctionne correctement. Tout le reste n'est pas important.
Si vous n'avez pas cela, vous pouvez essayer de le rattraper dans les logs d'application, les logs Nginx, etc., comme nous l'avons fait. Vous devez être aussi proche que possible de l'application.
Les métriques du système d'exploitation sont bien sûr importantes, mais elles n'intéressent pas le business, on ne nous paie pas pour elles.
Source : habr.com
