

L'écriture de cet article a été motivée par la grande quantité de contenus sur l'analyse statique, qui attirent de plus en plus mon attention. Tout d'abord, c'est , qui se promeut activement sur Habr grâce à des revues des erreurs détectées par son outil dans des projets open source. Récemment, PVS-studio a introduit , et bien sûr, les développeurs d'IntelliJ IDEA, dont l'analyseur intégré est sans doute le plus avancé pour Java aujourd'hui, .
En lisant de telles revues, on a l'impression qu'il s'agit d'une potion magique : appuyez sur un bouton, et voilà — la liste des défauts devant vos yeux. On aurait l'impression qu'à mesure que les analyseurs s'améliorent, de plus en plus de bugs seront automatiquement trouvés et que les produits scannés par ces robots deviendront de mieux en mieux, sans aucun effort de notre part.
Mais il n'existe pas de potions magiques. Je voudrais parler de ce dont on ne parle généralement pas dans les articles du type « voici ce que notre robot peut trouver » : ce que les analyseurs ne peuvent pas faire, quel est leur véritable rôle et place dans le processus de livraison logicielle, et comment les intégrer correctement.
Cloche à rats (source : ).
Ce que les analyseurs statiques ne pourront jamais accomplir
Qu'est-ce que, du point de vue pratique, l'analyse de code source ? Nous soumettons certains codes sources, et en sortie, en peu de temps (beaucoup plus court que les tests) nous obtenons des informations sur notre système. La limitation fondamentale et mathématiquement insurmontable est que nous ne pouvons obtenir qu'une classe d'informations plutôt étroite de cette manière.
Le cas le plus célèbre d'une tâche non résoluble par l'analyse statique est : c'est un théorème qui prouve qu'il est impossible de développer un algorithme général qui, à partir du code source d'un programme, déterminerait s'il va entrer dans une boucle ou se terminer en un temps fini. Une extension de ce théorème est , affirmant que pour toute propriété non triviale des fonctions calculables, la question de savoir si un programme arbitraire calcule une fonction avec cette propriété est une tâche algorithmiquement indécidable. Par exemple, il est impossible d'écrire un analyseur qui détermine, pour tout code source, si le programme analysé est une implémentation d'un algorithme calculant, disons, le carré d'un entier.
Ainsi, la fonctionnalité des analyseurs statiques a des limitations insurmontables. Un analyseur statique ne pourra jamais, dans tous les cas, déterminer des éléments comme, par exemple, l'occurrence d'une « null pointer exception » dans des langages permettant une valeur nulle, ou dans tous les cas, déterminer la survenue d'un « attribute not found » dans des langages à typage dynamique. Tout ce qu'un analyseur statique le plus performant peut faire, c'est mettre en évidence des cas particuliers, dont le nombre parmi tous les problèmes potentiels avec votre code source est, sans exagération, une goutte dans l'océan.
L'analyse statique n'est pas une recherche de bogues
De ce qui précède, on peut conclure que l'analyse statique n'est pas un moyen de réduire le nombre de défauts dans un programme. Je me risque à affirmer que, lorsqu'elle est appliquée pour la première fois à votre projet, elle trouvera des « endroits intéressants » dans le code, mais ne trouvera probablement aucun défaut affectant la qualité de votre programme.
Les exemples de défauts automatiquement trouvés par les analyseurs sont impressionnants, mais il ne faut pas oublier que ces exemples ont été trouvés grâce à l'analyse d'un grand ensemble de grandes bases de code. Sur le même principe, les hackers capables de tester plusieurs mots de passe simples sur un grand nombre de comptes finissent par trouver ceux pour lesquels le mot de passe est simple.
Cela signifie-t-il qu'il ne faut pas appliquer l'analyse statique ? Bien sûr que non ! Et pour la même raison pour laquelle il est utile de vérifier chaque nouveau mot de passe contre la liste noire des « mots de passe simples ».
L'analyse statique est plus qu'une recherche de bogues
En réalité, les tâches pratiquement résolues par l'analyse sont beaucoup plus larges. En effet, l'analyse statique est toute vérification des sources effectuée avant leur exécution. Voici quelques-unes des choses que l'on peut faire :
- La vérification du style de code au sens large du terme. Cela inclut à la fois la vérification du formatage et la recherche de l'utilisation de parenthèses vides/superflues, l'établissement de seuils pour des métriques telles que le nombre de lignes/la complexité cyclomatique des méthodes, etc. — tout ce qui peut potentiellement compliquer la lisibilité et la maintenabilité du code. En Java, un tel outil est Checkstyle, en Python — flake8. Les programmes de ce type sont généralement appelés « linters ».
- L'analyse peut porter non seulement sur le code exécutable. Les fichiers de ressources, tels que JSON, YAML, XML, .properties peuvent (et doivent !) être vérifiés automatiquement pour leur validité. Après tout, il vaut mieux découvrir qu'en raison de guillemets non appariés la structure JSON est rompue à un stade précoce de la vérification automatique de la Pull Request, plutôt qu'en exécutant des tests ou en runtime ? Des outils correspondants sont disponibles : par exemple, , .
- La compilation (ou le parsing pour les langages de programmation dynamiques) est également une forme d'analyse statique. En général, les compilateurs sont capables de fournir des avertissements signalant des problèmes de qualité du code source, et ils ne doivent pas être ignorés.
- Parfois, la compilation n'est pas seulement la compilation du code exécutable. Par exemple, si vous avez de la documentation au format , alors au moment de la transformer en HTML/PDF, le processeur AsciiDoctor () peut émettre des avertissements, par exemple sur des liens internes rompues. Et c'est une raison solide de ne pas accepter la Pull Request avec des modifications de la documentation.
- La vérification orthographique est aussi une forme d'analyse statique. L'outil peut vérifier l'orthographe non seulement dans la documentation, mais aussi dans le code source des programmes (commentaires et littéraux) dans différents langages de programmation, y compris C/C++, Java et Python. Une faute d'orthographe dans l'interface utilisateur ou la documentation est aussi un défaut !
- Les tests de configuration (pour ce que c'est, voir et les rapports), bien qu'ils soient effectués dans l'environnement d'exécution de tests unitaires comme pytest, sont en réalité aussi une forme d'analyse statique, car ils n'exécutent pas le code source lors de leur exécution.
Comme nous le voyons, la recherche de bogues dans cette liste occupe un rôle moins important, tandis que tout le reste est accessible par l'utilisation d'outils open source gratuits.
Quels types d'analyse statique devez-vous appliquer dans votre projet ? Bien sûr, tous, plus il y en a, mieux c'est ! L'essentiel est de bien les intégrer, c'est ce dont nous allons parler ensuite.
Le pipeline de livraison comme un filtre multi-niveaux et l'analyse statique comme son premier niveau.
La métaphore classique de l'intégration continue est le pipeline, où les changements circulent — de la modification du code source à la livraison en production. La séquence standard des étapes de ce pipeline est la suivante :
- analyse statique
- compilation
- tests unitaires
- tests d'intégration
- tests UI
- vérification manuelle
Les modifications rejetées à l'étape N du pipeline ne sont pas transmises à l'étape N+1.
Pourquoi ainsi et non autrement ? Dans la partie du pipeline qui concerne les tests, les testeurs découvrent la fameuse pyramide des tests.
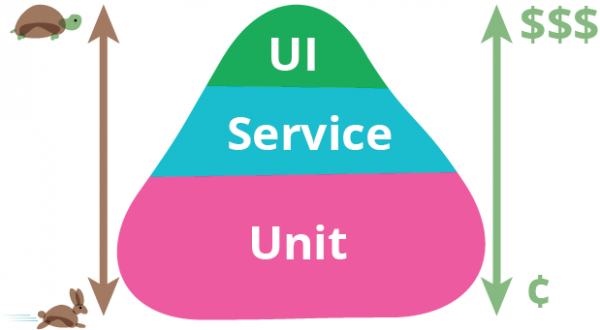
Pyramide des tests. Source : Martin Fowler.
En bas de cette pyramide se trouvent des tests qui sont plus faciles à écrire, qui s'exécutent plus rapidement et qui n'ont pas tendance à déclencher de faux positifs. Ils doivent donc être plus nombreux, couvrir plus de code et s'exécuter en premier. En haut de la pyramide, c'est tout le contraire, c'est pourquoi le nombre de tests d'intégration et de tests UI doit être réduit au minimum nécessaire. L'humain dans cette chaîne est la ressource la plus chère, la plus lente et la moins fiable, c'est pourquoi il se trouve à la fin et n'effectue son travail que si les étapes précédentes n'ont détecté aucun défaut. Cependant, le pipeline est construit selon les mêmes principes dans les parties non directement liées aux tests !
Je voudrais proposer une analogie avec un système de filtration d'eau multi-niveaux. À l'entrée, de l'eau sale (des changements avec des défauts) est fournie, à la sortie, nous devons obtenir de l'eau propre, où toutes les impuretés indésirables ont été éliminées.
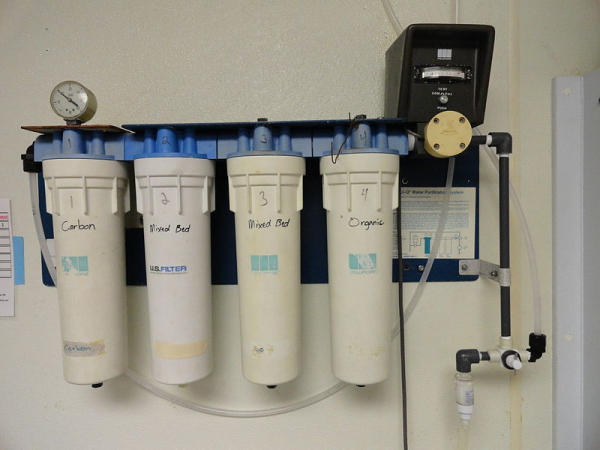
Filtre multi-niveaux. Source :
Comme vous le savez, les filtres de nettoyage sont conçus de telle manière que chaque cascade suivante peut éliminer des fractions de pollution de plus en plus fines. Les cascades de nettoyage le plus grossier, quant à elles, ont une plus grande capacité de passage et sont moins coûteuses. Dans notre analogie, cela signifie que les portes de qualité à l'entrée ont de meilleures performances, nécessitent moins d'efforts pour être lancées et sont en elles-mêmes plus faciles à utiliser — et c'est précisément dans cet ordre qu'elles sont agencées. Le rôle de l'analyse statique, qui, comme nous le comprenons maintenant, ne peut filtrer que les défauts les plus grossiers — c'est le rôle de la grille « grossière » au tout début de la cascade de filtres.
L'analyse statique en elle-même n'améliore pas la qualité du produit final, comme un filtre grossier ne rend pas l'eau potable. Néanmoins, dans l'ensemble, son importance est évidente lorsqu'elle est associée à d'autres éléments de la chaîne. Bien que dans un filtre à plusieurs cascades, les cascades de sortie puissent potentiellement capturer exactement ce que les cascades d'entrée attrapent — il est clair quelles en seraient les conséquences si l'on n'utilisait que des cascades de nettoyage fines, sans celles d'entrée.
Le but du « filtre grossier » est de décharger les cascades suivantes de la détection de défauts vraiment grossiers. Par exemple, au minimum, la personne effectuant la révision de code ne devrait pas être distrait par du code mal formaté et des violations des normes de codage établies (comme des parenthèses en trop ou des imbrications trop profondes). Les bugs tels que les NPE doivent être détectés par des tests unitaires, mais si l'analyseur nous indique qu'un bug doit inévitablement se produire avant même le test — cela accélérera considérablement sa correction.
Je suppose qu'il est maintenant clair pourquoi l'analyse statique n'améliore pas la qualité du produit lorsqu'elle est appliquée épisodiquement, et qu'elle doit être appliquée de manière continue pour éliminer les changements ayant des défauts grossiers. La question de savoir si l'application d'un analyseur statique améliorera la qualité de votre produit est à peu près équivalente à celle de « l'eau tirée d'un réservoir sale s'améliorera-t-elle si elle est passée au travers d'une passoire ? »
Intégration dans un projet hérité
Question pratique importante : comment intégrer l'analyse statique dans le processus d'intégration continue en tant que « quality gate » ? Dans le cas des tests automatisés, tout est clair : il existe un ensemble de tests, et l'échec de l'un d'eux est un motif suffisant pour considérer que la construction n'a pas franchi le quality gate. Essayer d'établir un gate basé sur les résultats de l'analyse statique échoue : avec le code hérité, il y a trop d'avertissements d'analyse, on ne veut pas les ignorer complètement, mais il n'est pas possible d'arrêter la livraison du produit simplement parce qu'il contient des avertissements de l'analyseur.
Lorsqu'il est utilisé pour la première fois, l'analyseur génère un grand nombre d'avertissements, la grande majorité desquels n'ont pas de rapport avec le bon fonctionnement du produit. Il est impossible de corriger immédiatement tous ces commentaires, et beaucoup ne le sont même pas. Après tout, nous savons que notre produit fonctionne globalement, même avant l'intégration de l'analyse statique !
En fin de compte, beaucoup se contentent d'une utilisation épisodique de l'analyse statique, ou l'utilisent uniquement en mode d'information, où un rapport de l'analyseur est simplement généré lors de la construction. Cela équivaut à une absence totale d'analyse, car si nous avons déjà de nombreux avertissements, l'apparition d'un autre (quel qu'il soit) lors de la modification du code reste inaperçue.
Les méthodes suivantes pour établir des quality gates sont connues :
- Établir une limite sur le nombre total d'avertissements ou sur le nombre d'avertissements divisé par le nombre de lignes de code. Cela fonctionne mal, car un tel gate laisse passer librement des modifications avec de nouveaux défauts tant que leur limite n'est pas dépassée.
- La fixation, à un moment donné, de tous les anciens avertissements dans le code comme étant ignorés, et le refus de la construction en cas de nouveaux avertissements. Cette fonctionnalité est fournie par PVS-Studio et certains ressources en ligne, comme Codacy. Je n'ai pas eu l'occasion de travailler avec PVS-Studio, en ce qui concerne mon expérience avec Codacy, leur principal problème réside dans le fait que déterminer ce qu'est une « ancienne » erreur et ce qu'est une « nouvelle » erreur est un algorithme assez complexe et qui ne fonctionne pas toujours correctement, surtout si les fichiers sont fortement modifiés ou renommés. De mémoire, Codacy a pu passer de nouveaux avertissements dans une pull request, tout en refusant celle-ci en raison d'avertissements non liés aux modifications du code de cette PR.
- À mon avis, la solution la plus efficace est celle décrite dans le livre « méthode du cliquet » (« ratcheting »). L'idée principale est que la propriété de chaque version est le nombre d'avertissements d'analyse statique, et seules les modifications qui n'augmentent pas le nombre total d'avertissements sont autorisées.
Cliquet
Cela fonctionne de la manière suivante :
- À l'étape initiale, une inscription dans les métadonnées de la version du nombre d'avertissements dans le code, trouvés par les analyseurs, est mise en œuvre. Ainsi, lors de la construction de la branche principale, votre gestionnaire de dépôts enregistre non seulement « version 7.0.2 », mais « version 7.0.2, contenant 100500 avertissements Checkstyle ». Si vous utilisez un gestionnaire de dépôts avancé (comme Artifactory), il est facile de conserver de telles métadonnées sur votre version.
- Maintenant, chaque pull request lors de la construction compare le nombre d'avertissements obtenus avec celui qui existe dans la version actuelle. Si la PR entraîne une augmentation de ce nombre, le code ne passe pas le quality gate pour l'analyse statique. Si le nombre d'avertissements diminue ou ne change pas - alors il est validé.
- Lors de la prochaine version, le nombre d'avertissements recalculé sera de nouveau enregistré dans les métadonnées de la version.
Ainsi, progressivement mais sûrement (comme avec le travail d'un cliquet), le nombre d'avertissements tendra vers zéro. Bien sûr, le système peut être trompé en ajoutant un nouvel avertissement tout en corrigeant celui d'un autre. C'est acceptable, car à long terme, cela produit des résultats : les avertissements sont généralement corrigés non pas un par un, mais en groupe selon un type défini, et tous les avertissements facilement supprimables sont rapidement résolus.
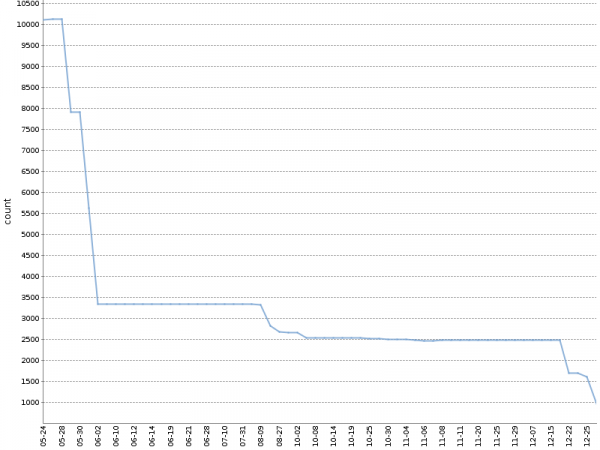
Ce graphique montre le nombre total d'avertissements Checkstyle sur une période de six mois de fonctionnement de ce « cliquet » sur . Le nombre d'avertissements a diminué d'un ordre de grandeur, et cela s'est produit naturellement, parallèlement au développement du produit !
J'applique une version modifiée de cette méthode, en comptant séparément les avertissements par module de projet et par outils d'analyse, le fichier YAML généré avec les métadonnées de la construction ressemble approximativement à ceci :
celesta-sql:
  checkstyle: 434
  spotbugs: 45
celesta-core:
  checkstyle: 206
  spotbugs: 13
celesta-maven-plugin:
  checkstyle: 19
  spotbugs: 0
celesta-unit:
  checkstyle: 0
  spotbugs: 0
Dans tout système CI avancé, un « cliquet » peut être mis en œuvre pour n'importe quel outil d'analyse statique, sans s'appuyer sur des plugins ou des outils tiers. Chacun des analyseurs fournit son rapport au format texte simple ou XML, facilement analysable. Il ne reste plus qu'à rédiger la logique requise dans le script CI. Vous pouvez voir comment cela est réalisé dans nos projets open source basés sur Jenkins et Artifactory. ou . Les deux exemples dépendent de la bibliothèque : la méthode countWarnings() compte de manière ordinaire les balises xml dans les fichiers générés par Checkstyle et Spotbugs, et compareWarningMaps() met en œuvre ce fameux cliquet, générant une erreur lorsque le nombre d'avertissements dans l'une des catégories augmente.
Une option intéressante pour mettre en œuvre un « système à cliquet » est possible pour l'analyse orthographique des commentaires, des littéraux textuels et de la documentation à l'aide d'aspell. Comme on le sait, lors de la vérification orthographique, tous les mots qui ne sont pas connus du dictionnaire standard ne sont pas nécessairement incorrects ; ils peuvent être ajoutés au dictionnaire personnel. Si le dictionnaire personnel fait partie du code source du projet, alors la porte de qualité relative à l'orthographe peut être formulée comme suit : exécuter aspell avec le dictionnaire standard et le dictionnaire personnel. trouver des erreurs d'orthographe.
L'importance de la fixation de la version de l'analyseur
En conclusion, il convient de noter ce qui suit : peu importe la manière dont vous intégrez l'analyse dans votre pipeline de livraison, la version de l'analyseur doit être fixée. Si on laisse l'analyseur se mettre à jour de manière spontanée, de nouveaux défauts peuvent « émerger » lors de la compilation d'une nouvelle demande de tirage, qui ne sont pas liés à un changement de code, mais simplement au fait que le nouvel analyseur peut identifier plus de défauts — ce qui perturbera votre processus d'acceptation des demandes de tirage. La mise à niveau de l'analyseur doit être un acte conscient. Cependant, la fixation stricte de la version de chaque composant de la compilation est généralement une exigence nécessaire et un sujet à part entière.
Conclusions
- L'analyse statique ne trouvera pas de bogues pour vous et n'améliorera pas la qualité de votre produit si elle n'est appliquée qu'une seule fois. Un effet positif sur la qualité ne peut être obtenu que par son application continue tout au long du processus de livraison.
- La recherche de bogues n'est pas du tout la principale tâche de l'analyse ; la quasi-totalité des fonctionnalités utiles est disponible dans les outils open source.
- Mettez en place des portes de qualité en fonction des résultats de l'analyse statique dès la première étape du pipeline de livraison, en utilisant le « système à cliquet » pour le code hérité.
Liens
- présentation sur différentes méthodes d'analyse de code (pas seulement statiques !)
Source : habr.com
