

Bonjour, amis. Avant de partir pour la deuxième partie des vacances de mai, nous partageons avec vous un document que nous avons traduit en prévision du lancement d'un nouveau cours. .
Les développeurs d'applications passent beaucoup de temps à comparer plusieurs bases de données opérationnelles afin de choisir celle qui conviendra le mieux à la charge de travail prévue. Les besoins peuvent inclure une modélisation des données simplifiée, des garanties transactionnelles, des performances de lecture/écriture, une mise à l'échelle horizontale et une résilience en cas de panne. Traditionnellement, le choix commence par la catégorie de la base de données, SQL ou NoSQL, car chaque catégorie offre un ensemble clair de compromis. Une haute performance en termes de faible latence et de grande capacité est généralement considérée comme une exigence non négociable, et donc nécessaire pour toute base de données sélectionnée.
L'objectif de cet article est d'aider les développeurs d'applications à faire le bon choix entre SQL et NoSQL dans le contexte de la modélisation des données de l'application. Nous examinerons une base de données SQL, à savoir PostgreSQL, et deux bases de données NoSQL – Cassandra et MongoDB, afin de discuter des principes de conception des bases de données, tels que la création de tables, leur remplissage, la lecture des données d'une table et leur suppression. Dans le prochain article, nous aborderons certainement les index, les transactions, les JOIN, les directives TTL et la conception des bases de données basées sur JSON.
Quelle est la différence entre SQL et NoSQL ?
Les bases de données SQL augmentent la flexibilité de l'application grâce aux garanties transactionnelles ACID, ainsi qu'à leur capacité à interroger des données avec des JOIN de manières inattendues sur des modèles normalisés existants de bases de données relationnelles.
Étant donné leur architecture monolithique/à nœud unique et leur utilisation du modèle de réplication maître-esclave pour la redondance, les bases de données SQL traditionnelles manquent de deux caractéristiques importantes : la scalabilité linéaire des écritures (c'est-à-dire la séparation automatique sur plusieurs nœuds) et la perte automatique/nulle de données. Cela signifie que le volume des données obtenues ne peut pas dépasser le maximum de débit d'écriture d'un nœud. De plus, une certaine perte de données dans le temps doit être prise en compte pour la tolérance aux pannes (dans une architecture sans séparation des ressources). Il est important de noter que les derniers commits ne se reflètent pas encore dans la copie esclave. Les mises à jour sans temps d'arrêt sont également difficiles à réaliser dans les bases de données SQL.
Les bases de données NoSQL sont généralement distribuées par nature, c'est-à-dire que les données sont divisées en sections et réparties sur plusieurs nœuds. Elles nécessitent une dénormalisation. Cela signifie que les données saisies doivent également être copiées plusieurs fois pour répondre aux requêtes spécifiques que vous envoyez. L'objectif principal est d'obtenir une haute performance en réduisant le nombre de shards disponibles lors de la lecture. Cela implique que NoSQL vous oblige à modéliser vos requêtes, tandis que SQL vous oblige à modéliser vos données.
NoSQL met l'accent sur l'atteinte d'une haute performance dans un cluster distribué, ce qui justifie de nombreux compromis dans la conception des bases de données, y compris la perte de garanties de transaction ACID, les jointures et les index secondaires globaux cohérents.
Il existe une opinion selon laquelle, bien que les bases de données NoSQL offrent une scalabilité linéaire des écritures et une haute tolérance aux pannes, la perte de garanties transactionnelles les rend inadaptées aux données critiques.
Le tableau suivant montre comment la modélisation des données dans NoSQL diffère de celle dans SQL.
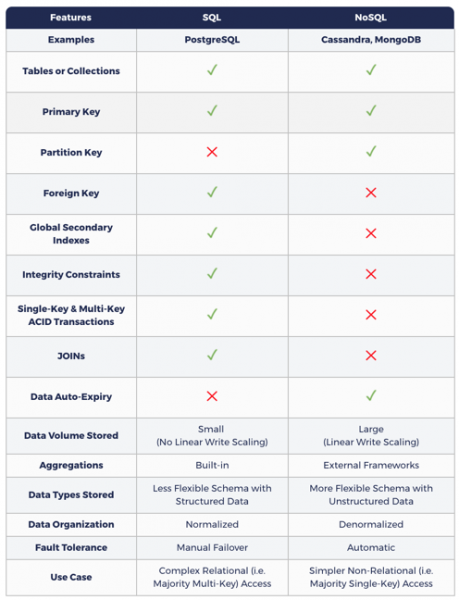
SQL et NoSQL : Pourquoi les deux sont-ils nécessaires ?
Des applications réelles avec un grand nombre d'utilisateurs, telles qu'Amazon.com, Netflix, Uber et Airbnb, ont pour tâche l'exécution de processus complexes et variés. Par exemple, une application de commerce électronique comme Amazon.com doit stocker des données légères et très critiques, telles que des informations sur les utilisateurs, les produits, les commandes, les factures, ainsi que des données volumineuses mais moins sensibles, telles que les avis sur les produits, les messages du service client, l'activité des utilisateurs, les commentaires et les recommandations des utilisateurs. Naturellement, ces applications s'appuient au moins sur une base de données SQL, ainsi que sur au moins une base de données NoSQL. Dans les systèmes interrégionaux et globaux, la base de données NoSQL fonctionne comme un cache géodistribué pour les données stockées dans une source de confiance, une base de données SQL opérant dans une seule région.
Comment YugaByte DB combine-t-il SQL et NoSQL ?
Construite sur un moteur de stockage hybride orienté journal, avec un auto-sharding, une réplication de consensus distribuée par sharding et des transactions ACID distribuées (inspirées de Google Spanner), YugaByte DB est la première base de données open source au monde à être compatible à la fois avec NoSQL (Cassandra & Redis) et SQL (PostgreSQL). Comme le montre le tableau ci-dessous, YCQL, l'API de YugaByte DB compatible avec Cassandra, ajoute le concept de transactions ACID à clé unique et multiclée ainsi que des index secondaires globaux à l'API NoSQL, ouvrant ainsi l'ère des bases de données NoSQL transactionnelles. De plus, YCQL, l'API de YugaByte DB compatible avec PostgreSQL, ajoute les notions d'évolutivité linéaire des écritures et de tolérance aux pannes automatique à l'API SQL, révélant ainsi au monde les bases de données SQL distribuées. Étant donné que la base de données YugaByte DB est essentiellement transactionnelle, l'API NoSQL peut maintenant être utilisée dans le contexte de données critiques.
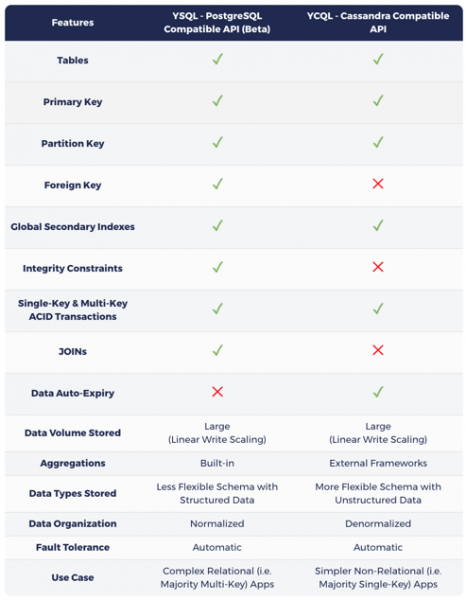
Comme mentionné précédemment dans l'article , le choix entre SQL ou NoSQL dans YugaByte DB dépend entièrement des caractéristiques de la charge de travail principale :
- Si la charge de travail principale implique des opérations multiclés avec des JOIN, alors en choisissant YSQL, gardez à l'esprit que vos clés peuvent être réparties sur plusieurs nœuds, ce qui entraînera une latence plus élevée et/ou une baisse de la bande passante par rapport à NoSQL.
- Sinon, choisissez l'une des deux API NoSQL, en gardant à l'esprit que vous obtiendrez de meilleures performances grâce aux requêtes gérées par un seul nœud à la fois. YugaByte DB peut servir de base de données opérationnelle unique pour des applications réelles complexes nécessitant la gestion de plusieurs charges de travail simultanément.
Au cœur du laboratoire de modélisation des données dans la section suivante se trouvent des bases de données YugaByte DB compatibles avec PostgreSQL et Cassandra, contrairement aux bases de données d'origine. Cette approche met en avant la simplicité d'interaction avec deux API différentes (sur deux ports différents) d'un même cluster de bases de données, au lieu d'utiliser des clusters complètement indépendants de deux bases de données différentes.
Dans les sections suivantes, nous allons explorer le laboratoire de modélisation des données pour illustrer les différences et certaines similitudes entre les bases de données examinées.
Laboratoire de modélisation des données
Installation des bases de données
Étant donné l'accent mis sur la conception du modèle de données (et non sur des architectures de déploiement complexes), nous installerons les bases de données dans des conteneurs Docker sur un ordinateur local, puis interagirons avec elles en utilisant les shells de commande appropriés.
Base de données YugaByte DB compatible avec PostgreSQL & Cassandra
mkdir ~/yugabyte && cd ~/yugabyte
wget https://downloads.yugabyte.com/yb-docker-ctl && chmod +x yb-docker-ctl
docker pull yugabytedb/yugabyte
./yb-docker-ctl create --enable_postgres
MongoDB
docker run --name my-mongo -d mongo:latestAccès via la ligne de commande
Connectons-nous aux bases de données à l'aide d'un shell de commande pour les API correspondantes.
PostgreSQL
— est un shell de ligne de commande pour interagir avec PostgreSQL. Pour faciliter l'utilisation, YugaByte DB est fourni avec psql directement dans le dossier bin.
docker exec -it yb-postgres-n1 /home/yugabyte/postgres/bin/psql -p 5433 -U postgresCassandra
— est un shell de ligne de commande pour interagir avec Cassandra et ses bases de données compatibles via CQL (Cassandra Query Language). Pour plus de commodité, YugaByte DB est fourni avec cqlsh dans le répertoire bin.
Notez que CQL s'inspire de SQL et possède des concepts similaires de tables, lignes, colonnes et index. Cependant, en tant que langage NoSQL, il ajoute un ensemble spécifique de contraintes, dont la plupart seront également abordées dans d'autres articles.
docker exec -it yb-tserver-n1 /home/yugabyte/bin/cqlshMongoDB
– est une interface de ligne de commande pour interagir avec MongoDB. Elle se trouve dans le répertoire bin de l'installation de MongoDB.
docker exec -it my-mongo bash
cd bin
mongo
Création d'une table
Nous pouvons maintenant interagir avec la base de données pour effectuer diverses opérations via la ligne de commande. Commençons par créer une table qui stocke des informations sur les chansons écrites par différents artistes. Ces chansons peuvent faire partie d'un album. Les attributs optionnels pour une chanson incluent l'année de sortie, le prix, le genre et la note. Nous devons également prendre en compte des attributs supplémentaires qui pourraient être nécessaires à l'avenir, via un champ « tags ». Ce champ peut stocker des données semi-structurées sous forme de paires clé-valeur.
PostgreSQL
CREATE TABLE Music (
    Artist VARCHAR(20) NOT NULL,
    SongTitle VARCHAR(30) NOT NULL,
    AlbumTitle VARCHAR(25),
    Year INT,
    Price FLOAT,
    Genre VARCHAR(10),
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
Cassandra
La création d'une table dans Cassandra est très similaire à celle dans PostgreSQL. L'une des principales différences est l'absence de contraintes d'intégrité (par exemple, NOT NULL), mais cela relève de la responsabilité de l'application, et non de la base de données NoSQL.. La clé primaire est composée de la clé de partition (colonne Artist dans l'exemple ci-dessous) et d'un ensemble de colonnes de clustering (colonne SongTitle dans l'exemple ci-dessous). La clé de partition détermine dans quelle partition/shard placer la ligne, tandis que les colonnes de clustering indiquent comment les données doivent être organisées au sein du shard actuel.
CREATE KEYSPACE myapp;
USE myapp;
CREATE TABLE Music (
    Artist TEXT,
    SongTitle TEXT,
    AlbumTitle TEXT,
    Year INT,
    Price FLOAT,
    Genre TEXT,
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
MongoDB
MongoDB organise des données en bases de données (Database) (analogues aux Keyspaces dans Cassandra), où il y a des collections (Collections) (analogues aux tables) contenant des documents (Documents) (analogues aux lignes dans une table). Dans MongoDB, il n'est pas nécessaire de définir un schéma initial. La commande « use database », montrée ci-dessous, crée une instance de la base de données lors de son premier appel et change le contexte pour la nouvelle base de données créée. Même les collections n'ont pas besoin d'être créées explicitement, elles sont créées automatiquement lors de l'ajout du premier document à une nouvelle collection. Notez que par défaut, MongoDB utilise une base de données de test, donc toute opération au niveau des collections sans spécifier de base de données particulière se fera par défaut dans celle-ci.
use myNewDatabase;Obtention d'informations sur la table
PostgreSQL
d Music
Table "public.music"
    Column    |         Type          | Collation | Nullable | Default
--------------+-----------------------+-----------+----------+--------
 artist       | character varying(20) |           | not null |
 songtitle    | character varying(30) |           | not null |
 albumtitle   | character varying(25) |           |          |
 year         | integer               |           |          |
 price        | double precision      |           |          |
 genre        | character varying(10) |           |          |
 criticrating | double precision      |           |          |
 tags         | text                  |           |          |
Indexes:
    "music_pkey" PRIMARY KEY, btree (artist, songtitle)
Cassandra
DÉCRIRE LA TABLE MUSIC;
CRÉER TABLE myapp.music (
    artist texte,
    songtitle texte,
    albumtitle texte,
    year int,
    price float,
    genre texte,
    tags texte,
    PRIMARY KEY (artist, songtitle)
) AVEC ORDRE DE CLUSTERING PAR (songtitle ASC)
    ET default_time_to_live = 0
    ET transactions = {'enabled': 'false'};
MongoDB
utiliser myNewDatabase;
montrer les collections;
Insertion de données dans la table
PostgreSQL
INSÉRER DANS Music
    (Artist, SongTitle, AlbumTitle,
    Year, Price, Genre, CriticRating,
    Tags)
VALEURS(
    'No One You Know', 'Call Me Today', 'Somewhat Famous',
    2015, 2.14, 'Country', 7.8,
    '{"Composers": ["Smith", "Jones", "Davis"],"LengthInSeconds": 214}'
);
INSÉRER DANS Music
    (Artist, SongTitle, AlbumTitle,
    Price, Genre, CriticRating)
VALEURS(
    'No One You Know', 'My Dog Spot', 'Hey Now',
    1.98, 'Country', 8.4
);
INSÉRER DANS Music
    (Artist, SongTitle, AlbumTitle,
    Price, Genre)
VALEURS(
    'The Acme Band', 'Look Out, World', 'The Buck Starts Here',
    0.99, 'Rock'
);
INSÉRER DANS Music
    (Artist, SongTitle, AlbumTitle,
    Price, Genre,
    Tags)
VALEURS(
    'The Acme Band', 'Still In Love', 'The Buck Starts Here',
    2.47, 'Rock',
    '{"radioStationsPlaying": ["KHCR", "KBQX", "WTNR", "WJJH"], "tourDates": { "Seattle": "20150625", "Cleveland": "20150630"}, "rotation": Heavy}'
);
Cassandra
Globalement, l'expression INSERT en Cassandra ressemble beaucoup à son équivalent en PostgreSQL. Cependant, il existe une grande différence de sémantique. En Cassandra INSERT est en fait une opération UPSERT, où les dernières valeurs sont ajoutées à la ligne, si la ligne existe déjà.
L'entrée de données se fait de manière similaire à PostgreSQL
INSERTsupérieur
.
MongoDB
Bien que MongoDB soit une base de données NoSQL, semblable à Cassandra, son opération d'insertion de données n'a rien à voir avec le comportement sémantique en Cassandra. Dans MongoDB n'a pas de capacités UPSERT, ce qui le rend similaire à PostgreSQL. L'ajout de données par défaut sans _idspecified entraînera l'ajout d'un nouveau document dans la collection.
db.music.insert( {
 artiste: "No One You Know",
 titreChanson: "Call Me Today",
 titreAlbum: "Somewhat Famous",
 année: 2015,
 prix: 2.14,
 genre: "Country",
 tags: {
 Compositeurs: ["Smith", "Jones", "Davis"],
 DuréeEnSecondes: 214
 }
 }
 );
 db.music.insert( {
 artiste: "No One You Know",
 titreChanson: "My Dog Spot",
 titreAlbum: "Hey Now",
 prix: 1.98,
 genre: "Country",
 noteCritique: 8.4
 }
 );
 db.music.insert( {
 artiste: "The Acme Band",
 titreChanson: "Look Out, World",
 titreAlbum:"The Buck Starts Here",
 prix: 0.99,
 genre: "Rock"
 }
 );
 db.music.insert( {
 artiste: "The Acme Band",
 titreChanson: "Still In Love",
 titreAlbum:"The Buck Starts Here",
 prix: 2.47,
 genre: "Rock",
 tags: {
 stationsDeRadioDiffusant:["KHCR", "KBQX", "WTNR", "WJJH"],
 datesDeTournée: {
 Seattle: "20150625",
 Cleveland: "20150630"
 },
 rotation: "Heavy"
 }
 }
 );
Requête de table
Peut-être la différence la plus significative entre SQL et NoSQL en ce qui concerne la rédaction de requêtes réside dans l'utilisation des formulations DE et OÙ. SQL permet de sélectionner plusieurs tables après l'expression DE et l'expression avec OÙ peut être de n'importe quelle complexité (y compris les opérations JOIN entre les tables). Toutefois, le NoSQL a tendance à imposer une restriction stricte sur DE, et ne fonctionne qu'avec une seule table spécifiée, et dans OÙ, il doit toujours y avoir une clé primaire. Cela est dû à l'objectif d'améliorer la performance NoSQL dont nous avons parlé précédemment. Cet objectif conduit à réduire tout type d'interaction inter-table et inter-clé. Cela peut entraîner une grande latence dans la communication entre les nœuds lors de la réponse à une requête, il est donc préférable de l'éviter en principe. Par exemple, Cassandra exige que les requêtes soient limitées à certains opérateurs (seuls sont autorisés =, IN, , =>, <=) sur les clés de partition, sauf dans le cas d'une requête d'index secondaire (où seul l'opérateur = est autorisé).
PostgreSQL
Voici trois exemples de requêtes qui peuvent facilement être exécutées par une base de données SQL.
- Afficher toutes les chansons de l'artiste;
- Afficher toutes les chansons de l'artiste dont le titre commence par la première partie du nom;
- Afficher toutes les chansons de l'artiste contenant un certain mot dans le titre et dont le prix est inférieur à 1,00.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE 'Call%';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE '%Today%'
AND Price > 1.00;
Cassandra
Parmi les requêtes mentionnées ci-dessus, seule la première fonctionnera dans Cassandra sans modification, car l'opérateur LIKE ne peut pas être appliqué aux colonnes de clustering, telles que SongTitle. Dans ce cas, seuls les opérateurs sont autorisés = et IN.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle IN ('Call Me Today', 'My Dog Spot')
AND Price > 1.00;
MongoDB
Comme le montrent les exemples précédents, la principale méthode de création de requêtes dans MongoDB est . Cette méthode contient explicitement le nom de la collection (music dans l'exemple ci-dessous), donc une requête sur plusieurs collections est interdite.
db.music.find( {
  artist: "No One You Know"
 }
);
db.music.find( {
  artist: "No One You Know",
  songTitle: /Call/
 }
);
Lire toutes les lignes de la table
Lire toutes les lignes est simplement un cas particulier du modèle de requête que nous avons examiné précédemment.
PostgreSQL
SELECT *
FROM Music;
Cassandra
De même que l'exemple ci-dessus en PostgreSQL.
MongoDB
db.music.find( {} );Modifier les données dans la table
PostgreSQL
PostgreSQL fournit une instruction UPDATE pour modifier des données. Elle n'a pas de capacités UPSERT, donc l'exécution de cette instruction échouera s'il n'y a plus de lignes dans la base de données.
UPDATE Music
SET Genre = 'Disco'
WHERE Artist = 'The Acme Band' AND SongTitle = 'Still In Love';
Cassandra
En Cassandra, il existe UPDATE un équivalent à PostgreSQL. UPDATE a la même sémantique UPSERT, semblable à INSERT.
De même que l'exemple ci-dessus en PostgreSQL.
MongoDB
Opération MongoDB peut entièrement mettre à jour un document existant ou mettre à jour uniquement certains champs. Par défaut, elle met à jour un seul document avec la sémantique désactivée. UPSERT. La mise à jour de plusieurs documents et un comportement similaire UPSERT peuvent être appliqués en définissant des drapeaux supplémentaires pour l'opération. Comme dans l'exemple ci-dessous, où le genre d'un interprète spécifique est mis à jour en fonction de sa chanson.
db.music.update(
  {"artist": "The Acme Band"},
  {
    $set: {
      "genre": "Disco"
    }
  },
  {"multi": true, "upsert": true}
);
Suppression de données dans une table
PostgreSQL
DELETE FROM Music
WHERE Artist = 'The Acme Band' AND SongTitle = 'Look Out, World';
Cassandra
De même que l'exemple ci-dessus en PostgreSQL.
MongoDB
Dans MongoDB, il existe deux types d'opérations pour supprimer des documents — et . Les deux types suppriment des documents, mais renvoient des résultats différents.
db.music.deleteMany( {
        artist: "The Acme Band"
    }
);
Suppression de la table
PostgreSQL
DROP TABLE Music;Cassandra
De même que l'exemple ci-dessus en PostgreSQL.
MongoDB
db.music.drop();Conclusion
Les débats sur le choix entre SQL et NoSQL existent depuis plus de 10 ans. Il y a deux aspects principaux dans ce débat : l'architecture du cœur de la base de données (SQL monolithique et transactionnel contre NoSQL distribué et non transactionnel) et l'approche de conception de la base de données (modélisation des données en SQL contre modélisation de vos requêtes en NoSQL).
Avec une base de données transactionnelle distribuée comme YugaByte DB, les débats sur l'architecture de la base de données peuvent être facilement dissipés. Alors que les volumes de données deviennent supérieurs à ce qui peut être enregistré sur un seul nœud, une architecture entièrement distribuée qui prend en charge la mise à l'échelle linéaire des écritures avec un sharding / rebalancement automatique devient nécessaire.
Outre ce qui est dit dans un des articles , les architectures transactionnelles, strictement cohérentes, sont désormais largement utilisées pour assurer une meilleure flexibilité dans le développement par rapport aux architectures non transactionnelles, finalement cohérentes.
En revenant à la discussion sur la conception des bases de données, il est juste de dire que les deux approches de conception (SQL et NoSQL) sont nécessaires pour toute application réelle complexe. L'approche SQL « modélisation des données » permet aux développeurs de mieux répondre aux exigences commerciales changeantes, tandis que l'approche NoSQL « modélisation des requêtes » permet aux mêmes développeurs de gérer de grands volumes de données avec une faible latence et un haut débit. C'est pourquoi YugaByte DB fournit une API SQL et NoSQL dans un noyau commun, au lieu de promouvoir une seule des approches. De plus, en assurant la compatibilité avec les langages de bases de données populaires, y compris PostgreSQL et Cassandra, YugaByte DB garantit que les développeurs n'auront pas besoin d'apprendre un autre langage pour travailler avec un noyau de base de données distribué et strictement cohérent.
Dans cet article, nous avons examiné comment les principes de conception des bases de données diffèrent dans PostgreSQL, Cassandra et MongoDB. Dans les articles suivants, nous plongerons dans des concepts avancés de conception tels que les index, les transactions, les JOIN, les directives TTL et les documents JSON.
Nous vous souhaitons de passer un excellent reste de week-end et vous invitons à , qui aura lieu le 14 mai.
Source : habr.com
